F-Stack 2.0 前瞻 6 : LD_PRELOAD 无锁 Ring IPC 改造

1. 本功能主要作用和特点

F-Stack 的 LD_PRELOAD 模块(libff_syscall.so)从 2023-05 初版提交到现在演进三年了,这篇讲的是 2026 年上半年给它做的无锁环形队列改造(FF_USE_RING_IPC),顺带把这三年从初版到现在的优化和修改一起捋一遍。

F-Stack 的标准接入方式是改代码:应用调 ff_* 前缀 API + ff_run() 主循环,代码侵入大。为了降低存量应用的迁移门槛,2023 年社区在 dev 分支提交了 adapter/syscall 目录(commit 8f5f1dfbb,2023-05-03),提供 libff_syscall.so 动态库,通过 LD_PRELOAD 劫持 Linux socket 系统调用转发给 fstack 实例进程处理,应用零代码修改即可接入。初版发布时官方定位很克制:「目前功能尚不完善,仅供测试使用」。

三年后的今天,这个模块已经支持 fork、accept4、_FORTIFY_SOURCE 包装函数、epoll polling 模式,并且把 APP 与 fstack 之间的 IPC 从信号量三层同步演进到了 DPDK 无锁 rte_ring 双环 SPSC。几个关键点:

  • 免改代码接入:socket/bind/connect/read/write/epoll/kevent/select 全部劫持,存量应用(Nginx、netperf 等)零代码修改直接跑在 F-Stack 上
  • 双环 SPSC:FF_USE_RING_IPC 用 rte_ring 单生产者单消费者模式替换 sem_wait/sem_post,消灭全局锁和 O(n) 遍历
  • 诚实收敛:ring 改造经过 v1~v3.7 共七轮实测迭代,最终结论不是”ring 全面胜利”,而是”ring 在 LD_PRELOAD + FF_MULTI_SC 场景下没有性能优势,生产推荐 sem”——这是这篇最想说的:优化要有对照、有证伪、敢于否定自己

2. 本功能的主要适用场景

2.1 存量应用免改代码接入 F-Stack

这是 LD_PRELOAD 模块的根本定位。历史 issue 档案里,官方对”现有多线程/多进程/Go/netperf 类应用怎么移植”的回答,推荐方案第一条几乎都是它:不用改源码,先起 fstack 实例进程,再 LD_PRELOAD 拉起应用。适配的接口面包括 socket 全家桶、epoll 全家桶、kqueue/kevent、select、fork,以及 glibc _FORTIFY_SOURCE 编译的 recv_chk/read_chk/__recvfrom_chk 包装函数。

2.2 Nginx 免改代码集成

Nginx 官方默认携带 1.16.1,经 LD_PRELOAD 接入无需改任何代码,需要同时开 FF_KERNEL_EVENT + FF_MULTI_SC 两个编译开关,配置上 multi_accept on、listen reuseport。不适用场景明确:多实例做客户端(反向代理)暂不支持,需要像社区 @铁皮大爷 那样在 hook 层加 RSS 对称 hash 选实例。

2.3 fork 多进程模型应用

2025-05 的 fork 支持(commit 4891fabf5,PR #887)之后,每个 fork 出来的进程都拥有独立的 FreeBSD struct thread,行为对标 Linux 内核 fork。配合 FF_MULTI_SC,Nginx master fork worker 的经典模型可以跑通。

2.4 不太适合的场景

  • 追求极致性能:每组应用实例要 2 个 CPU 核(1 个 fstack + 1 个 APP),CPU 几乎翻倍,官方原话”性价比不高”。要极致性能还是直接改代码用标准 F-Stack
  • 8 核以上的短连接场景:LD_PRELOAD 性能不如标准 F-Stack,受 APP 与 fstack 匹配度影响

3. 本功能的架构特征

3.1 整体拓扑
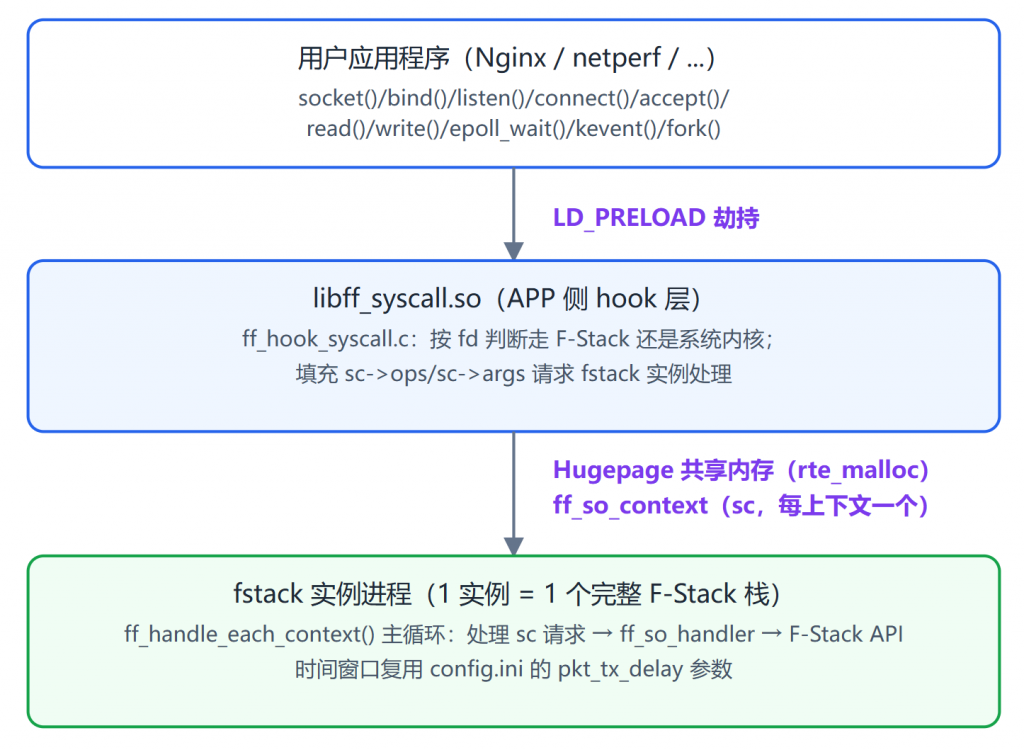
核心通信载体是 DPDK 大页共享内存上的 ff_so_context(简称 sc)。APP 把要执行的 socket 操作填进 sc,fstack 实例主循环处理并把结果写回。fstack 实例和 APP 建议跑在同 NUMA 节点的不同物理核上。

3.2 初版同步机制:信号量三层同步

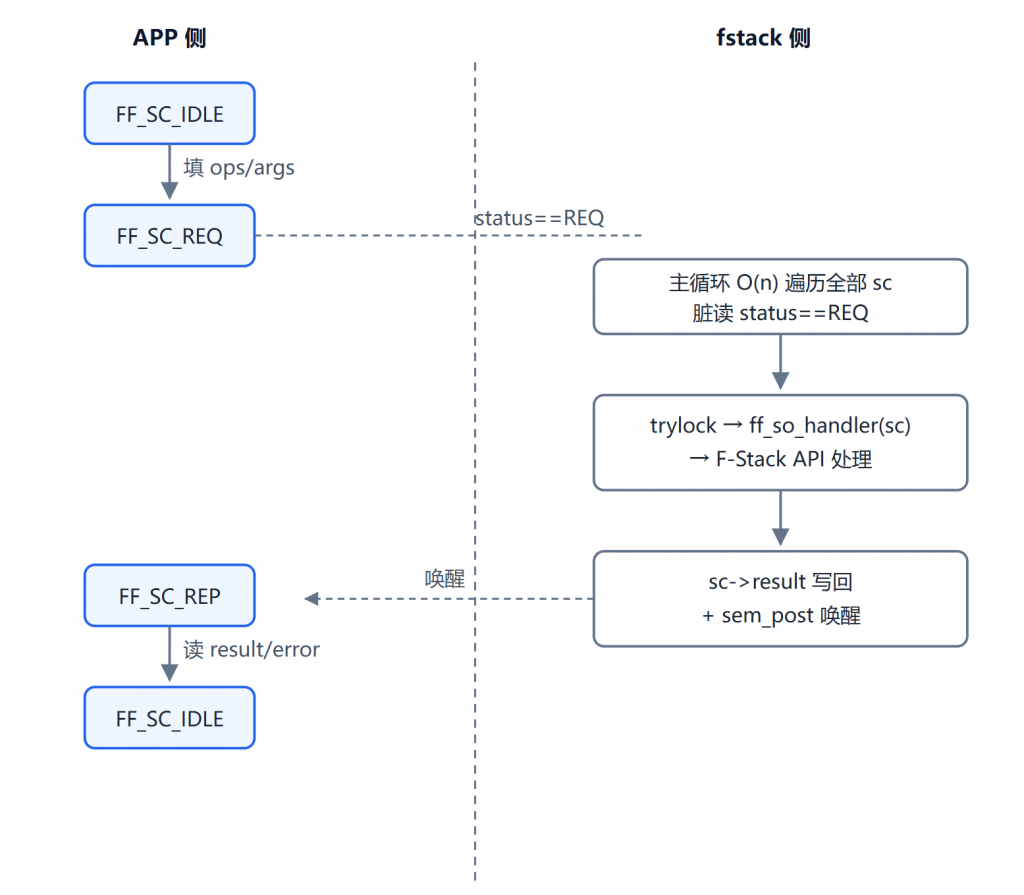
初版(2023-05 ~ 2026-04 默认路径)sc 的同步靠三层机制:

层机制位置
状态机FF_SC_IDLE → FF_SC_REQ → FF_SC_REP → FF_SC_IDLEff_socket_ops.h
互斥锁rte_spinlock_t lock(sc 级 + zone 级全局锁)ff_socket_ops.h
信号量sem_t wait_sem(POSIX 跨进程信号量,futex 实现)ff_socket_ops.h

一次 socket 调用的往返流程:

3.3 新同步机制:双 Ring SPSC

2026-04-09 的 commit d2b71ac89 引入 FF_USE_RING_IPC:用 DPDK rte_ring(SPSC 模式)替代 sem。请求环 APP 生产 fstack 消费,响应环 fstack 生产 APP 消费:

状态语义的等价迁移:sc 在 req_ring 中 = 旧 FF_SC_REQ;在 rsp_ring 中 = 旧 FF_SC_REP;两个 ring 都不在 = 空闲。spinlock 和状态机转换不再参与同步逻辑。

3.4 为什么选 rte_ring

spec 文档(SPEC-002)里给了四条理由:F-Stack 本身大量使用 rte_ring(dispatch_ring、msg_ring),零学习成本;DPDK 原生 SPSC 无需自研无锁算法;Hugepage + rte_memzone 已验证跨进程可见;比 VPP 的 svm_msg_q 更简单。APP 与 fstack 实例 1:1 绑定,天然满足 SPSC 约束。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 初版遗留问题清单(ring 改造的动机)

初版的信号量机制在 spec 文档(SPEC-001)里被列了 5 条性能瓶颈:

  1. 内核态切换:sem_wait/sem_post 走 futex 系统调用,每次 100-200ns,epoll_wait 短超时场景被放大
  2. 超时精度差:sem_timedwait 用 CLOCK_REALTIME,受 NTP 调时影响,唤醒粒度受调度器 tick(1-4ms)限制;还有个竞态:超时返回后 fstack 才 sem_post,导致下次 sem_timedwait 立即返回读到过期结果
  3. O(n) 遍历:ff_handle_each_context 每轮遍历全部 32 个 sc 的 status 字段,绝大多数处于 IDLE 也要脏读
  4. alarm_event_sem 补偿机制脆弱:5 个示例程序里只有 1 个真正调用它,其余全注释掉了
  5. 模式分裂:信号量模式(低 CPU 高延迟)和轮询模式 FF_PRELOAD_POLLING_MODE(低延迟 100% CPU)通过编译宏二选一,运行时不可切换

4.2 三年中间演进(2023-08 ~ 2026-03,ring 之前的沉淀)

ring 不是凭空出现的,中间这三年社区补了不少坑,按时间排:

时间commit内容
2023-080ee517ed0修 Ubuntu 22.04 / kernel 5.19 / gcc 11.4 编译错误(#777),pre-C99 声明问题
2025-035de6ec6d2新增 epoll polling 模式,改善 RTT 敏感场景延迟
2025-033c21f2253修 ff_hook_recvfrom sh_fromlen 未初始化导致返回 -1(PR #872)
2025-03e3766b423accept4 支持 + ff_socket 支持 LINUX_SOCK_CLOEXEC/NONBLOCK
2025-05111816e29hook recv_chk/read_chk/_recvfrom_chk,FORTIFY_SOURCE 编译的应用可用
2025-054891fabf5完整 fork 支持(PR #887),每个进程独立 FreeBSD struct thread
2026-03b36ce995d修 ioctl 可变参数签名冲突编译错误(#942,PR #1048)

其中 ioctl 那个坑值得展开一句:glibc 里 ioctl(2) 是可变参数签名 int ioctl(int, unsigned long, …),而 ff_declare_syscalls.h 按定参注册,新工具链一编就炸。这类”glibc 签名 vs hook 声明”的不一致,是 LD_PRELOAD 这类方案的天生雷区,只能靠社区逐一踩坑修复。

4.3 ring 初版落地(2026-04)

2026-03-27 先产出了 4 篇 spec(需求/架构/接口/测试),审核通过后 2026-04-09 一次性提交 d2b71ac89:双 rte_ring SPSC、FF_USE_RING_IPC 编译开关、三种等待策略(busy-poll/yield-poll/eventfd,默认 yield-poll)、rte_rdtsc 替代 sem_timedwait 做微秒级超时、alarm_event_sem 改为 sentinel 入队。设计上严格走”编译宏切换 + 旧路径不动”,可渐进迁移。

4.4 ring 性能优化攻坚战(2026-05,七轮迭代的教训全集)

初版 ring 一上实测就出问题:短连接 QPS 9.1w,比 sem 基线 10.5w 低 12.4%。于是有了 v1~v3.7 的七轮迭代,这段过程是这篇最有价值的部分——不是”怎么修好的”,而是”怎么一步步证伪自己的错误假设”。

第一轮假设(H10/H11,v1):只读了 ff_socket_ops.c 的 ring 分支,下结论”sem 模式没有 30us drain 强制空轮询”。被证伪——对照 else 分支发现 sem 同样有 if (diff_tsc >= drain_tsc) break 循环。教训:单边代码分析,不对照另一分支就下结论。

第二轮假设(H15,v2):基于”sem 有 nb_handled 旁路而 ring 没有”,假设 ring 的 dequeue burst 跨核读 prod.tail 导致 LLC miss 暴增。perf stat 实测证伪:ring 的 LLC miss 反而比 sem 少 23%(6.8K/s 量级,不构成瓶颈)。教训:没先验证可证伪的物理量就把假设写进文档。

第三轮(v3.1):把”每 256 次 PAUSE 触发 sched_yield”按纯算术推成次因(H18),实测三组配置(yield 阈值 0xFF/0x1FFF/busy-poll)QPS 全部 9.2w,voluntary_ctxt_switches 增长约等于 0——spin_count 是局部变量,短连接场景单次 wait 根本到不了 256 次。教训:频率类估算先做 10 秒采样,别做 30 分钟的弯路。

第四轮(v3.2):perf top callgraph 锁定真因——ff_ring_process_requests Self 15.44%(每次主循环 spin 都走完整 dequeue burst 函数调用栈,即使 nb=0)+ ff_ring_send_response Self 3.33%(每次响应写 rsp_ring->prod.tail,触发 APP 核 cache invalidate)。同期还证伪了自己两条假设:H21 把 wrk 延迟差 +190us 当成单 syscall 开销(差 3 个数量级,真因是 CPU 占用挤压);H24 在 perf 已给明确证据后还发散”跨 NUMA”环境假设(同环境对照实验的唯一变量是 IPC 实现本身)。

方案 C 的失败(v3.3,H25):想用 atomic pending_count 旁路复刻 sem 的 nb_handled 快速跳过,结果 QPS 反劣化 4%(9.1w → 8.7w)。根因:APP 每次 syscall 多写 atomic 2-4 次,跨核 cache 乒乓比省掉的 dequeue 路径更贵。这个方案当天实施当天回退,代码随后彻底删除(f344d945f)。教训写进了文档的”对称评估表”方法论:任何优化必须同时列出”消除的物理量”和”新引入的物理量”,后者数量级必须明显小于前者才允许实施。

D2 的成功(v3.4,+9.7%):放弃响应 ring,fstack 处理完直接写 sc->completion(sc cache line 0 上本来就预留的字段),APP 端 spin completion 标志。写频率与 sem 基线完全一致,零新跨核字段。QPS 9.1w → 10.0w,ff_ring_send_response 从 perf top 消失。

D5(+1.3%):ff_ring_process_requests 改为先 rte_ring_empty() 内联快速空判断,空时不展开函数调用栈。Self 18.98% → 4.53%,但 QPS 只涨 1.3%——省下的 CPU 立刻被 main loop spin 填满。这是关键的洞察起点:fstack lcore 100% CPU + 30us drain 设计下,IPC 省下的 CPU 不会 1:1 变 QPS。

D6(+0.9%):ff_handle_socket_ops_ring 标 static inline,主循环直接函数名调用(去函数指针),与 sem 模式的 ff_handle_socket_ops 对齐。10.13w → 10.22w。

最终收敛:ring 单 worker QPS 10.22w,距 sem 的 10.5w 还差 2.7%。perf top 显示两边 main loop CPU 占比已完全一致(50.13% vs 50.41%),剩余差距来自 rte_ring_sc_dequeue_burst 的 acquire fence 和 ring 元数据维护——sem 的 dirty read 是 plain load 无 fence。这是 SPSC 架构的物理代价,单 worker 单 lcore 场景不可消除。

4.5 意外收获:sem 路径的启动饥饿修复

ring 攻坚过程中顺带修了一个老问题(8125beece,2026-05-25)。现象:sem 模式 + FF_MULTI_SC + config.ini 里 idle_sleep=0 时,多 worker 启动、还没任何流量,nginx 第二个 worker 卡死在 ff_attach_so_context 的 rte_spinlock_lock,gdb 堆栈和死锁一模一样。

但它是饥饿不是死锁:fstack secondary lcore 专核紧自旋,每 50-100us 释锁一次但释锁窗口 <<1us(idle_sleep=0 不让 CPU),nginx worker 是普通调度进程,cmpxchg 永远慢一拍,命中窗口概率趋近 0。修复只改了 13+/5- 行:进入 while 前快照 tmp(in-use sc 数),unlikely(!tmp) 时 unlock → pause → lock 让出窗口,有负载时零影响。最优补丁是”条件性让出”不是”无条件让出”。

【注1】这条饥饿现象同时说明:跨进程自旋锁竞争里,专核 DPDK lcore 永远胜过普通调度进程,这是物理机制不是代码 bug。能用配置(idle_sleep 改 1)消除的现象,根因 99% 是时间窗/调度类问题。

4.6 多核长连接实测:最终证伪 ring 的设计目标(v3.5~v3.7)

单 worker 收敛后转向多核对照。结果比预想残酷:

场景结论
多核短连接(1/2/4 核)ring ≡ sem(差距 -1.9%/0%/-0.3%,噪声范围)
多核长连接(1/2/4 核)ring 稳定劣于 sem 2.4%~4.5%,方向一致且大于噪声

长连接把 ring 的劣势放大而不是抵消:FF_MULTI_SC 下每个 fstack lcore 与 nginx worker 是 1:1 同 zone,sem 的 zone 锁是 fstack lcore 独占持有(cache line 一直 exclusive,近乎零成本),而 ring 每次 dequeue 都要 acquire fence 同步内存系统,高 QPS 下线性放大。当初”长连接下 sem 全程持锁压力升高、ring lock-free 优势将显现”的预测被彻底证伪。

v3.7 终版结论(2026-05-25 晚):

  1. 性能层面:ring 在任何已测场景下均无 net win,sem 仍是 LD_PRELOAD + FF_MULTI_SC 的最优配置
  2. 鲁棒性层面:ring 主循环 lock-free 的理论价值(启动饥饿免疫)已被 8125beece 在 sem 源头修复
  3. 架构层面:ring 代码保留(FF_USE_RING_IPC + D2/D5/D6 作为默认行为,c62d56a3b),作为”多线程同进程共享 sc”和”多进程间共享 sc(worker 数 > fstack 实例数)”的未来预留能力,当前 fork 多进程场景默认不启用

【注2】这个收敛结论值得反复看:一个设计良好、实现了完整 spec、优化了七轮的方案,最终被对照实验判定”不如老方案”。如果只有实现没有对照基线,这个结论永远不会出现。性能优化工作里,”对照组先于优化”比”数据先于理论”更值钱。

4.7 ring 之后还在继续(2026-05 ~ 08)

收敛之后模块没有停:README 全面刷新(bc7c380b2,2026-05-26);ff_hook_bind 增加 addrlen 边界检查(8762e05c1,2026-06-08,#1068);新增 UDP echo server 示例(2215dc4f2,2026-08-07,#1063)。

5. 如何使用、如何配置、使用效果

5.1 编译

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig
​
cd /data/f-stack/adapter/syscall
# Nginx 无缝接入:同时开 FF_KERNEL_EVENT + FF_MULTI_SC
export FF_KERNEL_EVENT=1
export FF_MULTI_SC=1
# 可选:启用无锁 ring IPC(默认关闭,见 5.4 推荐配置)
#export FF_USE_RING_IPC=1
make clean; make all

编译产物:fstack(实例程序)、libff_syscall.so(劫持库)、5 个 helloworld 示例 + main_stack_udp 示例。FF_USE_RING_IPC 与 FF_PRELOAD_POLLING_MODE 互斥,Makefile 有编译期检查,同时定义直接报错。

5.2 运行

# 1. 先起 fstack 实例(lcore_mask 等配置同标准 F-Stack)
bash ./start.sh -b adapter/syscall/fstack
​
# 2. 再以 LD_PRELOAD 方式拉起应用
export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so
export FF_NB_FSTACK_INSTANCE=4        # 与 nginx worker 数 1:1
/usr/local/nginx/sbin/nginx

运行时环境变量:FF_NB_FSTACK_INSTANCE(实例数,默认 1)、FF_INITIAL_LCORE_ID(起始核,默认 0x4)、FF_PROC_ID(进程号,配合 CPU 绑定)。应用能自己绑核的(如 nginx worker_cpu_affinity)优先自己绑。

5.3 Nginx 配置要点(免改代码,但要调配置)

worker_processes  4;
worker_cpu_affinity 10000 100000 1000000 10000000;
​
events {
   worker_connections 1024;
   multi_accept on;      # F-Stack epoll 是 kqueue 封装,必须开
   use epoll;
}
​
http {
   access_log off;
   sendfile   off;      # 用 F-Stack 必须关
   keepalive_timeout 0;
​
   server {
       listen       80 reuseport;   # 每个 fd 对接不同 fstack 实例的 sc
       location / {
           return 200 "0123456789abcdefghijklmnopqrstuvwxyz";
      }
  }
}

注意 kern.maxfiles 不应大于 65536(保证 epoll fd 到内核 fd 的正确映射)。

5.4 使用效果与推荐配置

性能数据(E5-2670 v3 双路 / 10G X540,v3.7 终版实测):

场景SemRing差距
多核短连接 1/2/4 核(万 QPS)10.4 / 20.8 / 35.910.2 / 20.8 / 35.8≤2%(噪声)
多核长连接 1/2/4 核(万 QPS)33.3 / 65.9 / 130.531.8 / 64.3 / 127.0-2.4%~-4.5%
单 worker 优化轨迹—9.1w → 10.22w(+12.3%)距 sem 10.5w 差 2.7%

生产推荐配置(2026-05-25 终版):

# LD_PRELOAD + nginx 多 worker 推荐(默认,不开 ring)
make FF_KERNEL_EVENT=1 FF_MULTI_SC=1
# config.ini: idle_sleep = 0(8125beece 之后安全),pkt_tx_delay = 50(短连接)/ 100(长连接)

ring 路径仅在以下任一情况启用:单进程内多线程需共享 sc;多进程间共享 sc(worker 数 > fstack 实例数);或者接受 -2.4%~-4.5% 的性能损失换取主循环 lock-free 设计。

对 F-Stack 使用者的整体建议:LD_PRELOAD 是”少改代码”的折中,不是”性能最优”的路径。要追求极致还是标准 F-Stack 改代码接入;只想快速迁移存量应用,LD_PRELOAD + sem 默认配置就够用,ring 等未来多对多共享场景再启。

6. 延伸阅读:

  • ring 需求/架构/接口/测试 spec:docs/ld_preload_ring_spec/zh_cn/01~04
  • v3.7 终版性能分析(七轮迭代完整复盘):docs/ld_preload_ring_spec/zh_cn/ring_ipc_perf_offline_analysis.md
  • 模块官方文档(含 2023-05 ~ 2026-05 全部 feature updates):adapter/syscall/README.md
  • 初版公众号介绍(2023-05):https://mp.weixin.qq.com/s/hmxCEu0kOzp5X5TEB7r3OQ
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 历史 issue 档案:docs/zh_cn/f-stack-issue-ana.md
F-Stack LD_PRELOAD 介绍

2026.05.26本文章已经更新

跳票许久许久的LD_PRELOAD功能模块(后续以 libff_syscall.so 代替)在 F-Stack dev 分支的 adapter/sysctall 目录下已经提交,支持 hook 系统内核 socket 相关接口的代码,降低已有应用迁移到 F-Stack 的门槛。下面将分别进行具体介绍, 主要包括libff_syscall.so 相关的架构涉及其中的一些思考,支持的几种模式以及如何使用等内容。

总体结论:

  • 原有应用程序的接入门槛比原本的 F-Stack 有所降低,大部分情况下可以不修改原有的用户应用程序和 F-Stack lib 的代码,而是仅修改libff_syscall.so相关代码即可适配。
  • 可以支持多 F-Stack 实例(即原 F-Stack 应用程序进程),每个 F-Stack 实例可以对应 1 个或多个用户应用程序。
    • 为了达到最佳的性能,建议一个用户应用程序(进程或线程)对应一个 fstack 实例应用程序,即为一组应用实例。
  • 每组应用实例的性能会略高于系统内核的性能,与单个标准 F-Stack 应用进程互有高低;单机整体的性能相比系统内核仍有较大的优势,但与标准 F-Stack 仍有差距。
    • 新的每组应用实例需要运行在两个 CPU 核心上,而标准 F-Stack 应用进程只需要运行在一个 CPU 核心上,总体而言性价比不高,是否使用可以视各业务的具体情况而定。
    • Nginx 600 字节的 body 内存应答测试中,长连接中相同数量的新应用实例组略高于标准 F-Stack 应用进程,短连接中相同数量的新应用实例组则略低于标准 F-Stack 应用进程,见 Nginx 接入介绍章节,但使用的 CPU 几乎翻倍。

已知限制

自 2023 年以来 libff_syscall.so 持续迭代,原本作为开放问题的多个能力(如 fork、accept4、__recv_chk 系列、epoll polling 模式以及 lock-free ring IPC 等)已经实现,详见下文 功能更新历程。下列限制仍在跟踪,欢迎社区共同完善:

  • 进程结束时仍可能存在内存泄漏与死锁风险。
  • 部分接口(如 sendmsg、readv、readmsg 等)线上场景使用较少,尚未做充分的性能优化与测试,仍需进一步打磨(较新加入的 accept4、__recv_chk、__read_chk、__recvfrom_chk 等已覆盖)。
  • 项目在准生产环境中持续迭代,欢迎社区提供更长时间运行的稳定性反馈。
  • 在多 F-Stack 实例同时运行时暂不能作为客户端使用,例如 Nginx 的 proxy 场景;参考的改造思路如下:
  • @铁皮大爷:之前实现过类似的逻辑,在 hook 内再加一层 RSS。延迟建立 socket(仅在确定目的与来源后再选择由哪个 F-Stack 作为 worker 进程),同时要求网卡接收侧开启 RSS 对称哈希,保证出入方向能落到同一个 F-Stack worker。
    • app -> socket:暂存 socket 操作,创建 fd(fd1)返回给用户。
    • app -> bind:暂存 bind 操作,将 bind 参数与 fd1 绑定后返回给用户。
    • app -> connect:在 fd1 上追加 connect 参数,按 RSS 对称哈希选定某个 F-Stack 进程(worker),将暂存的 socket、bind、connect 一并交给该 F-Stack 进程处理并等待同步结果。

功能更新历程 (2023-05-04 ~ 2026-05-25)

以下汇总自 v1.22 以来 adapter/syscall/ 目录的主要变更。

新功能

  • Lock-free rte_ring IPC(FF_USE_RING_IPC):以 DPDK SPSC ring 替代原先基于信号量的共享内存 IPC,从 fstack 主循环中彻底移除全局 ff_so_zone->lock。多核短/长连接实测中 ring 与 sem 性能相当或略低 2–4%,无跨 worker 锁竞争,并天然免疫启动期自旋锁饥饿。Ring 分支默认启用 v3.4 的优化(D2:sc->completion 唤醒;D5:内联 rte_ring_empty 快速空判断;D6:内联 dequeue burst 与 dispatch)。编译开关见附录 FF_USE_RING_IPC,完整设计与性能分析见 docs/ld_preload_ring_spec/。
  • epoll polling 模式:在 RTT 敏感的事件等待路径上改善时延表现。
  • fork 支持:每个 fork 出的进程拥有自己的 FreeBSD struct thread,行为更接近 Linux kernel,解除了原先 LD_PRELOAD 下 fork 使用受限的状况。
  • accept4 及 SOCK_CLOEXEC / SOCK_NONBLOCK 支持:新增 accept4 hook,并在 ff_socket 上支持 LINUX_SOCK_CLOEXEC / LINUX_SOCK_NONBLOCK 标志位。
  • glibc _FORTIFY_SOURCE 系列 hook:新增 __recv_chk、__read_chk、__recvfrom_chk,使开启 -D_FORTIFY_SOURCE 编译的应用能在 LD_PRELOAD 下正常工作。

功能完善与缺陷修复

  • FF_KERNEL_EVENT 模式下 kernel epoll fd 泄漏修复:ff_hook_close 在启用 FF_KERNEL_EVENT 时同步关闭系统侧 epoll fd,解决长时间运行 Nginx 场景下观察到的内核 fd 泄漏。
  • ff_hook_syscall.c 中 cplen 计算修复:修复 hook 路径中错误的长度计算,并后续将代码风格统一到 ff_hook_accept。
  • ff_hook_recvfrom 中 sh_fromlen 未初始化修复:在调用 ff_sys_recvfrom 之前初始化 sh_fromlen,修复返回 -1 的回归问题。
  • ioctl 函数原型冲突的编译错误修复(#942):解决新版工具链下函数原型冲突导致的构建失败。
  • Ring IPC 启动期饥饿修复:在 FF_MULTI_SC + idle_sleep = 0 场景下,nginx worker 在 attach 第二个 fstack 实例的 ff_so_zone 时可能表现为死锁;sem 路径在确认无在用 socket context 时做条件性的 unlock → pause → lock,消除饥饿且对正常负载零影响。
  • Ubuntu 22.04 / kernel 5.19 / gcc 11.4 编译错误修复:包含 pre-C99 声明问题,参考 #777。
  • 其他零碎编译 / 日志 / Makefile / 头文件打磨:包括 syscall 目录编译问题修复、日志清理,以及一系列围绕 ff_hook_syscall.c、ff_socket_ops.c、ff_socket_ops.h、ff_linux_syscall.c、ff_sysproto.h、ff_declare_syscalls.h 与 Makefile 的细节改进。

libff_syscall.so 的编译

先设置好FF_PATH和PKG_CONFIG_PATH环境变量

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig

在adapter/sysctall目录下直接编译即可得到ibff_syscall.so的相关功能组件

cd /data/f-stack/adapter/sysctall
make clean;make all
​
ls -lrt
fstack
libff_syscall.so
helloworld_stack
helloworld_stack_thread_socket
helloworld_stack_epoll
helloworld_stack_epoll_thread_socket
helloworld_stack_epoll_kernel

下面将分别进行介绍各个组件的主要作用

fstack 实例应用程序

fstack应用程序对标的是标准版 F-Stack 中的应用程序,其运行与普通的 F-Stack 应用程序完全相同,包括配置文件及其多进程(每进程即为一个实例)的运行方式等, 具体运行方式可以参考 F-Stack 主目录的 README, 在执行 LD_PRELOAD 的用户应用程序前必须先运行 fstack实例应用程序。

fstack 应用程序的作用主要是底层对接 F-Stack API,其主函数ff_handle_each_context即为普通 F-Stack 应用的用户层 loop 函数,非空闲时或每间隔 10ms (受 HZ参数影响) 时会调用该函数去循环处理与 APP 对接的上下文,如果 APP 有对应的 API 请求,则调用实际的 F-Stack API 进行处理。

与 libff_syscall.so用户应用进程间通信使用 DPDK 的 rte_malloc 分配的 Hugepage 共享内存进行。

该函数对 libff_syscall.so 的整体性能有至关重要的影响,目前是复用了 F-Stack 主配置文件(config.ini)中的 pkt_tx_dalay参数,死循环并延迟该参数指定的值后才会回到 F-Stack 的其他处理流程中。

如果想提高 libff_syscall.so的整体性能,那么fstack实例应用程序与 APP 应用程序的匹配十分重要,只有当一个ff_handle_each_context循环中尽量匹配一次循环的所有事件时才能达到最优的性能,这里需要调十分精细的调优,但是目前还是粗略的使用 pkt_tx_dalay参数值。

【提示】pkt_tx_dalay参数的默认值为 100us, 较适合长连接的场景。如果是 Nginx 短链接的场景,则应考虑设置为 50us,可以可获得更好的性能。当然不同的用用场景如果想达到最优的性能,可能需要业务自行调整及测试。复用该参数也只是临时方案,后续如果有更优的方案,则随时可能进行调整。

libff_syscall.so

该动态库主要作用是劫持系统的 socket 相关接口,根据 fd 参数判断是调用 F-Stack的相关接口(通过上下文 sc 与 fsack 实例应用程序交互)还是系统内核的相关接口。

与fstack实例应用进程间通信使用 DPDK 的 rte_malloc 分配的 Hugepage 共享内存进行。

【注意】在第一次调用相关接口时分配相关内存,不再释放,进程退出时存在内存泄漏的问题,待修复。

F-Stack用户的应用程序 (如 helloworl 或 Nginx)设置 LD_PRELOAD劫持系统的 socket 相关 API 时使用,即可直接接入 F-Stack 开发框架,可以参考如下命令:

export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so

确保 fstack实例应用程序已经正确运行的前提下,然后启动用户应用程序。

当然如果是改造用户的 APP 使用 kqueue代替 Linux 的 epoll 相关事件接口时,也可以在用户 APP 中直接链接该运行库, 可以参考相关示例程序helloworld_stack和helloworld_stack_thread_socket对应的源文件main_stack.c和main_stack_thread_socket.c,因为不是使用的LD_PRELOAD, 所以本文档不再详细介绍。

【重要提示】一组对应的fstack应用程序和用户应用程序最好运行在同一个 CPU NUMA 节点的不同物理核上,其他场景(运行在同一个CPU核心、两个 CPU 核心跨 NUMA 节点,物理核和超线程核混用)都无法达到一组实例的最佳性能。

  • 特别的,如果 CPU 物理核心比较缺乏,可以考虑一组实例分别运行在对应的一组 CPU 的物理核心和 HT 核心上,虽然单组实例性能会有所下降(约 20% 左右),但可以使用更多的 CPU 核心,单机总性能可能会有所提升。

DEMO 演示程序 helloworld_stack*

其他编译生成的hello_world开头的可执行文件为当前libff_syscall.so支持的几种不同运行模式的相关演示程序,下一节进行具体介绍。

F-Stack LD_PRELOAD 支持的几种模式

为了适应不同应用对 socket 接口的不同使用方式,降低已有应用迁移到 F-Stack 的门槛,并尽量提高较高的性能,目前 F-Stack 的 libff_syscall.so 主要支持以下几种模式,支持多线程的 PIPELINE 模式、线程(进程)内的 RTC(run to completion)模式、同时支持 F-Stack 和内核 socket 接口的 FF_KERNEL_EVENT 模式和类似内核 SO_REUSEPORT 的 FF_MULTI_SC 模式。

支持多线程的 PIPELINE 模式

该模式为默认模式,无需额外设置任何参数直接编译libff_syscall.so即可。

在此模式下,socket 相关接口返回的 fd 可以在不同线程交叉调用,即支持 PIPELINE 模式,对已有应用的移植接入更友好,但性能上相应也会有更多的损失。

该模式除了单进程运行方式外,同时可以支持用户应用程序多进程方式运行,每个用户进程对应一个fstack实例应用程序的实例,更多信息可以参考附录的运行参数介绍。

【注意】以此默认方式接入 F-Stack 的应用程序只能使用 F-Stack 的 socket 网络接口,而不能使用系统的 socket 接口。

hook 系统 epoll 接口

对于已有的 Linux 下的应用,事件接口都是一般使用的是epoll相关接口,对于没有更多特殊要求的应用程序,可以直接使用默认的编译参数编译libff_syscall.so后使用,参考 DEMO 程序helloworld_stack_epoll, 代码文件为main_stack_epoll.c。

【注意】F-Stack 的epoll接口依然为kqueue接口的封装,使用上依然与系统标准的epoll事件接口有一定区别,主要是事件触发方式和multi accept的区别。

使用 kqueue

当然libff_syscall.so除了支持使用LD_PRELOAD方式 hook 系统的 socket 接口的方式使用,也支持普通的链接方式使用,此时除了可以使用系统的epoll事件接口之外,还可以使用 F-Stack(FreeBSD)具有的kqueue事件接口,参考 DEMO 程序helloworld_stack, 代码文件为main_stack.c。

该使用方式的性能比LD_PRELOALD使用系统epoll接口的方式有略微的性能提升。

线程(进程)内的 RTC(run to completion)模式

该模式需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_THREAD_SOCKET或执行以下 shell 命令来开启。

export FF_THREAD_SOCKET=1
make clean;make all

在此模式下,socket 相关接口返回的 fd 仅可以在本线程内调用,即仅支持线程内的 RTC 模式,对已有应用的移植接入门槛稍高,但性能上相应也会有一定的提升,适合原本就以 RTC 模式运行的应用移植。

同样的,该模式除了单进程运行方式外,同时可以支持用户应用程序多进程方式运行,每个用户进程对应一个fstack实例应用程序的实例,更多信息可以参考附录的运行参数介绍。

【注意】以此默认方式接入 F-Stack 的应用程序同样只能使用 F-Stack 的 socket 网络接口,而不能使用系统的 socket 接口。

hook 系统 epoll 接口

其他同默认的 PIPELINE 模式,可以参考 DEMO 程序helloworld_stack_epoll_thread_socket, 代码文件为main_stack_epoll_thread_socket.c。

使用 kqueue

其他同默认的 PIPELINE 模式,可以参考 DEMO 程序helloworld_stack_thread_socket, 代码文件为main_stack_thread_socket.c。

FF_KERNEL_EVENT 模式

该模式可以同时支持 F-Stack 和系统内核的 socket 接口,需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_KERNEL_EVENT或执行以下 shell 命令来开启。

export FF_KERNEL_EVENT=1
make clean;make all

在此模式下,epoll相关接口在调用 F-Stack 接口的同时会调用系统内核的相关接口,并将 F-Stack 返回的 fd 与系统内核返回的 fd 建立映射关系,主要为了支持两个场景:

  • 用户应用程序中有控制 fd 与 数据 fd 使用相同的 epoll fd, 如 Nginx。
  • 希望本机也可以同时访问用户应用程序监听的网络接口。
    • 如果希望单独与本机系统内核进行普通网络通信,需要额外调用socket接口,并需要指定type | SOCK_KERNEL参数,并为返回的 fd 单独调用 bind()、listen()、epoll_ctl()等接口,参考 DEMO 程序helloworld_stack_epoll_kernel, 代码文件为main_stack_epoll_kernel.c

【注意1】F-Stack 中 FreeBSD 的内核参数 kern.maxfiles不应该大于 65536(原默认值为 33554432),以保证 F-Stack 的 epoll fd 到系统内核的 epoll fd 的正确映射。

【注意2】Nginx 的无缝接入需要开启此模式,因为在 Nginx 中有多个控制 fd 与 数据 fd 使用相同的 epoll fd。

FF_MULTI_SC 模式

该模式为 Nginx 等使用内核SO_REUSEPORT且fork子进程 worker 运行等特殊的设置为设置,需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_MULTI_SC或执行以下 shell 命令来开启。

export FF_MULTI_SC=1
make clean;make all

在此模式下,用户应用程序与fstack实例相关联的上下文sc除了保存在全局变量sc中之外,会额外保存在全局的scs数组中,在fork()子进程 worker 时会使用 current_worker_id设置sc变量为对应 worker 进程 fd 对应的 sc,供子进程复制及使用。

Nginx 的reuseport模式的主要流程为,主进程为每个 worker 分别调用 socket()、bind()、listen()等接口,并复制到 worker 进程,而后 woker 进程各自调用epoll相关接口处理各自的 fd, 需要各自 fd 对应的上下文 sc 才能正确运行。

【注意】Nginx 的无缝接入需要同时开启 FF_THREAD_SOCKET 和 FF_MULTI_SC 模式。

Nginx 接入libff_syscall.so介绍

Nginx(以 F-Stack 默认携带的 Nginx-1.16.1 为例)目前可以不修改任何代码直接以LD_PRELOAD动态库libff_syscall.so的方式接入 F-Stack,以下为主要步骤及效果。

编译libff_syscall.so

需要同时开启 FF_THREAD_SOCKET 和 FF_MULTI_SC 模式进行编译

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig
​
cd /data/f-stack/adapter/sysctall
export FF_KERNEL_EVENT=1
export FF_MULTI_SC=1
make clean;make all

配置nginx.conf

以下为主要需要注意及修改的相关配置参数示例(非全量参数):

user  root;
worker_processes 4; # worker 数量
worker_cpu_affinity 10000 100000 1000000 10000000; # 设置 CPU 亲和性
​
events {
  worker_connections 1024;
  multi_accept on; # epoll 是封装 kqueue 接口,必须要开启
  use epoll;
}
​
http {
access_log off; # 关闭访问日志,用于提高测试时的网络性能,否则每次请求都需要额外调用系统的 write() 接口记录访问日志
​
sendfile       off; # 使用 F-Stack 时需要关闭

keepalive_timeout 0; # 视长连接/短链接的业务需要调整
  #keepalive_timeout 65;
  #keepalive_requests 200; # 默认每个长连接最多 100 个请求,视业务需要调整,长连接时适当提高此值可以略微提高性能
   
  server {
      listen       80 reuseport; # 应该设置 reuseport,与使用系统的内核的 reuseport 行为不太一致,但都可以提高性能
​
      access_log off;
       
      location / {
          #root   html;
          #index index.html index.htm;
          return 200 "0123456789abcdefghijklmnopqrstuvwxyz"; # 直接返回数据用以测试单纯的网络性能
      }
  }
}

【注意】此处的 reuseport作用是使用多个不同的 socket fd, 而每个 fd 可以对接不同的fstack实例应用程序的上下文sc来分散请求,从而达到提高性能的目的。与系统内核的reuseport行为异曲同工。

运行

假设运行4组 Nginx – fstack 实例应用程序,可以简单按照以下步骤进行

  • 运行 fstack 实例
  • 设置config.ini中的lcore_mask=f00,即使用 CPU 核心 9-11, 其他配置按照标准 F-Stack 配置进行。
  • 参考以下命令启动 fstack 实例,并等待一段时间待 fstack 主进程和子进程都启动完成
  cd /data/f-stack
  bash ./start.sh -b adapter/syscall/fstack
  • 运行 Nginx
  • 参考以下命令配置libff_syscall.so所需的环境变量
  export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so # 设置 LD_PRELOAD libff_syscall.so
  export FF_NB_FSTACK_INSTANCE=4 # 设置有 4 个 fstack 实例应用程序,前面 nginx.conf 中也配置了 4 个worker
  • 启动 Nginx
  /usr/local/nginx/sbin/nginx # 启动 Nginx

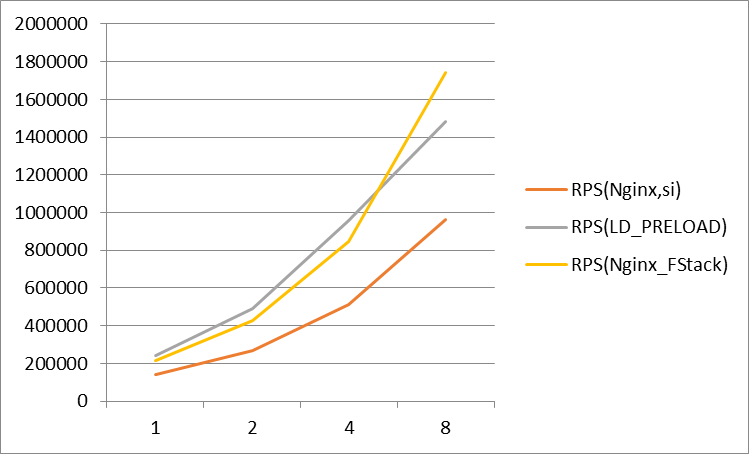
性能对比

测试环境

CPU:Intel(R) Xeon(R) CPU E5-2670 v3 @ 2.30GHz * 2

网卡:Intel Corporation Ethernet Controller 10-Gigabit X540-AT2

OS :TencentOS Server 3.2 (Final)

内核:5.4.119-1-tlinux4-0009.1 #1 SMP Sun Jan 23 22:20:03 CST 2022 x86_64 x86_64 x86_64 GNU/Linux

Nginx长连接

  • body 大小为 602 字节(不包括 http 头等)。
  • LD_PRELOAD 实际使用的 CPU 为几乎横轴 CPU 核心数的双倍,系统内核均衡软中断实际使用的 CPU 也远高于 worker 数量对应的 CPU 核心数量。
  • 限于时间所限,其中 LD_PRELOAD 的测试数据为以上测试环境的数据,其他为历史 40G 测试环境的数据,后续会更新为相同测试环境的数据。
  • 受网卡硬件所限,8核 LD_PRELOAD 测试带宽已经接近 10G 网卡线速(服务端出带宽9.xG,148万 RPS), 导致的与标准 F-Stack 的数据差异,实际CPU尚有一些空闲,后续应使用 40G/100G 网卡进行对比测试
  • pkt_tx_delay 参数为 100us。

Nginx短链接

  • body 大小为 602 字节(不包括 http 头等)。
  • LD_PRELOAD 实际使用的 CPU 为几乎横轴 CPU 核心数的双倍,系统内核均衡软中断实际使用的 CPU 也远高于 worker 数量对应的 CPU 核心数量。
  • 受 CPU 硬件所限(12C24HT * 2),LD_PRELOAD 测试只能测试12组应用实例组,即使用了全部 CPU 的物理核心,无法进行更多实例组的测试。
  • 8核之后 LD_PRELOAD 的性能不如标准 F-Stack 的性能,最主要是受用户应用程序和fstack应用程序的匹配度不高(ff_handle_each_context的循环次数及时间等)影响很大,并未完全达到性能极致,如果持续的精细化调整可以进一步提高性能,但是通用性也不高。
  • pkt_tx_delay 参数由 100us 调整到 50us。

附录:详细参数介绍

编译参数

本段总体介绍各个编译选项,所有参数都可以在adapter/sysctall/Makefile中开启或通过 shell 命令设置环境变量来开启。

DEBUG

开启或关闭 DEBUG 模式,主要影响优化和日志输出等, 默认关闭。

export DEBUG=-O0 -gdwarf-2 -g3

默认的优化参数为

-g -O2 -DNDEBUG

FF_THREAD_SOCKET

是否开启线程级上下文sc变量,如果开启,则 socket 相关 fd 只能在本线程中调用,一般可以略微提高性能, 默认关闭。

export FF_THREAD_SOCKET=1

FF_KERNEL_EVENT

是否开启epoll相关接口在调用 F-Stack 接口的同时调用系统内核的相关接口,并将 F-Stack 返回的 fd 与系统内核返回的 fd 建立映射关系, 默认关闭,主要为了支持两个场景:

  • 用户应用程序中有控制 fd 与 数据 fd 使用相同的 epoll fd, 如 Nginx。
  • 希望本机也可以同时访问用户应用程序监听的网络接口。
export FF_KERNEL_EVENT=1

FF_MULTI_SC

在此模式下,用户应用程序与fstack实例相关联的上下文sc除了保存在全局变量sc中之外,会额外保存在全局的scs数组中,在fork()子进程 worker 时会使用 current_worker_id设置sc变量为对应 worker 进程 fd 对应的 sc,供子进程复制及使用。 默认关闭。

export FF_KERNEL_EVENT=1

FF_USE_RING_IPC

是否将 libff_syscall.so 与 fstack 实例之间的 IPC 从原有的信号量+共享内存方案切换为 lock-free 的 DPDK SPSC rte_ring,默认关闭。

export FF_USE_RING_IPC=1

启用该开关时,v3.4 的 ring 路径优化均作为默认行为合入(基于 sc->completion 的唤醒、内联 rte_ring_empty 快速空判断、以及内联 dequeue burst 与 dispatch),无需额外子开关。

性能摘要:在 LD_PRELOAD + FF_MULTI_SC 且 nginx worker 与 fstack 实例 1:1 的部署形态下,ring 与 sem 在 1 / 2 / 4 核短/长连接实测中相差均在 2–4% 以内。Ring 路径的主要价值是结构性的:主循环 lock-free、天然免疫启动期自旋锁饥饿、且不需要 fstack 侧的 zone 级锁。对于每个 worker 拥有独立 fstack 实例的生产部署,sem 路径仍是推荐配置;ring 路径主要作为未来”单进程内多线程共享 sc”或”多进程间共享 sc(worker 数量多于 fstack 实例数量)”扩展场景的预留能力。完整设计与性能分析见 docs/ld_preload_ring_spec/。

运行参数

通过设置环境变量设置一些用户应用程序需要的参数值,如果后续通过配置文件配置的话可能需要修改原有应用,所以暂时使用设置环境变量的方式。

LD_PRELOAD

设置 LD_PRELOAD 的运行库,再运行实际的应用程序,可以参考以下命令

export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so

如果想通过gdb调试应用程序,则可以参考以下命令

export LD_PRELOAD=
gdb ./helloworld_stack_epoll
(gdb) set exec-wrapper env 'LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so'

FF_NB_FSTACK_INSTANCE

设置fstack实例应用程序的实例数,用于和用户应用程序的进程/线程等 worker 数量相匹配,默认1。

export FF_NB_FSTACK_INSTANCE=4

建议用户应用程序 worker 数量与fstack实例应用程序尽量 1:1 配置,可以达到更好的性能。

FF_INITIAL_LCORE_ID

配置用户应用程序的 CPU 亲和性绑定的起始 CPU 逻辑 ID,16进制,默认0x4(0b0100),即 CPU 2。

export FF_INITIAL_LCORE_ID=0x4

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。

FF_PROC_ID

配置用户应用程序的进程 ID,可以配合FF_INITIAL_LCORE_ID参数设置 CPU 亲和性的绑定,10进制递增,默认0。

export FF_PROC_ID=1

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。

致谢

特别感谢以下外部贡献者自 2023-05-04 以来通过 pull request 与 commit 对 libff_syscall.so 做出的实质性扩展:

  • liujinhui-job —— 自 2025 年以来贡献最多的外部开发者,主要工作包括:fork 支持(PR #887)、accept4 及 SOCK_CLOEXEC / SOCK_NONBLOCK 支持、__recv_chk / __read_chk / __recvfrom_chk 系列 _FORTIFY_SOURCE hook、epoll polling 模式、ff_hook_recvfrom 中 sh_fromlen 未初始化修复(PR #872),以及围绕 ff_hook_syscall.c、ff_socket_ops.c、ff_socket_ops.h、ff_linux_syscall.c、ff_sysproto.h、ff_declare_syscalls.h 与 Makefile 的一系列细节优化。
  • zhaozihanzzh —— 修复 ff_hook_syscall.c 中的 cplen 计算错误(并将代码风格统一到 ff_hook_accept),以及在 FF_KERNEL_EVENT 模式下 ff_hook_close 内的 kernel epoll fd 泄漏问题。

上述贡献显著提升了 LD_PRELOAD 路径的完整性、正确性以及对 Nginx 的友好程度,欢迎社区继续提交 pull request 与建议。

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。