F-Stack 2.0 前瞻8 :用户态/协议栈间的零拷贝,从魔改到 FreeBSD 原生 sosend 对称架构

1. 本功能主要作用和特点

本篇只讲 F-Stack 的用户态与协议栈之间一直有的”最后一公里”的内存拷贝问题,不涉及其他层的零拷贝,这篇把零拷贝从 2018 年到 2026 年的演进捋一遍——早期双向都有内存拷贝,2022 年有了发送方向的魔改方案,2026 年 6 月终于收敛成”双向对称、纯原生”的完整用户态零拷贝栈。

拷贝发生在哪先搞清楚。数据包在服务器的处理分接收和发送两个方向:

  • 接收方向:网卡 → DPDK hugepage 是 DMA,天然零拷贝;但应用调 ff_read() 把数据从协议栈 mbuf 搬到用户 buffer 有一次拷贝(issue #407 官方确认,这是设计如此)
  • 发送方向:有两处拷贝——应用层调用 socket 发送接口时数据从应用层拷到 FreeBSD 协议栈(应用 → 协议栈),以及协议栈把数据拷到 DPDK rte_mbuf(协议栈 → 网卡)

2026 年 6 月之前,F-Stack 零拷贝的版图是这样的:接收方向零拷贝(FF_ZC_RECV)只有空接口,未实际实现,在2026-06-11通过FreeBSD源生接口实现了接受方向零拷贝的实际实现(commit b87f5f0d2);发送方向零拷贝(FF_ZC_SEND)用的是 FSTACK_ZC_MAGIC 哨兵 + m_uiotombuf 内核魔改的 workaround——能跑但有 GPF 风险、大数据量发送 crash、FreeBSD 升级时维护成本高。2026-06-12 的原生化重构(commit b6ce5884c)把发送方向也换成了 FreeBSD 15.0 原生的 sosend(top) 路径,至此形成完全对称的双向零拷贝栈。几个关键词:

  • 双向对称:ZC-send(kern_zc_sendit + sosend top)与 ZC-recv(kern_zc_recvit + soreceive mp0)在内核入口、用户态 API、生命周期、错误路径、ABI 增量五个维度全镜像
  • 纯原生:直接复用 FreeBSD 15.0 上游能力——sosend(9) 手册原文就写着”Data may be sent as an mbuf chain via top, avoiding a data copy”,f-stack 只是补了一个把 top 贯通进 sosend 的入口
  • 拆除魔改:FSTACK_ZC_MAGIC 哨兵 + m_uiotombuf 魔改共 17 处触点全部拆除,m_uiotombuf 回归 vanilla 15.0 版本,内核 patch 从”5 处魔改”变成”只新增 1 个函数”

2. 本功能的主要适用场景

2.1 大块数据收发场景

这是零拷贝最实在的收益场景。M2 实测已经证明:小包 echo(256B 请求/438B 应答)下 ZC 与普通 read/write 持平——小请求的 uiomove 拷贝开销相对 TCP 处理 + syscall + 调度可以忽略,且 f-stack 用 UIO_SYSSPACE,uiomove 本就是同地址空间 memcpy,已经很廉价。真正的收益在 4KB/64KB/1MB 级 payload:大文件下载、大 body POST、块存储类业务。

2.2 代理转发场景(收到即转发)

转发类应用(代理、网关)收到数据后原样发出去,传统路径是 recv 拷进用户 buffer 再 send 拷回协议栈,两趟拷贝;ZC 路径下 recv 拿到 mbuf 链、send 直接投递 mbuf 链,全程零拷贝。这是 spec 里明确标注的优先收益场景。

2.3 与 FF_USE_PAGE_ARRAY 的关系(要说清)

FF_USE_PAGE_ARRAY 是 2020 年 PR #364 贡献的”协议栈 → DPDK”方向零拷贝(mmap + mlock + virt2phy 查找),与这篇讲的应用层零拷贝是两段不同的拷贝。它至今仍是实验性特性:issue 档案确认它在 i40e 下会静默丢包,官方不建议启用;Phase-2 实测还触发过 panic(F-A1,已修复为 soft drop)。三者开关完全独立,可任意组合。

2.4 不太适合的场景

  • 小包 echo 类负载:实测零收益,直接开还会多一层 API 复杂度
  • 依赖增量编译的快速迭代环境:FF_ZC_* 开关切换后必须 make clean,否则会踩 M2 的 http=000 坑(见 4.3)
  • 期待性能翻倍的:2022 年官方公众号文章就说过,性能提升”并不一定很明显,比如只有 2-3% 左右的提升”——零拷贝省的是 memcpy,不是协议栈本身的开销

3. 本功能的架构特征

3.1 三条发送路径对比(核心图)
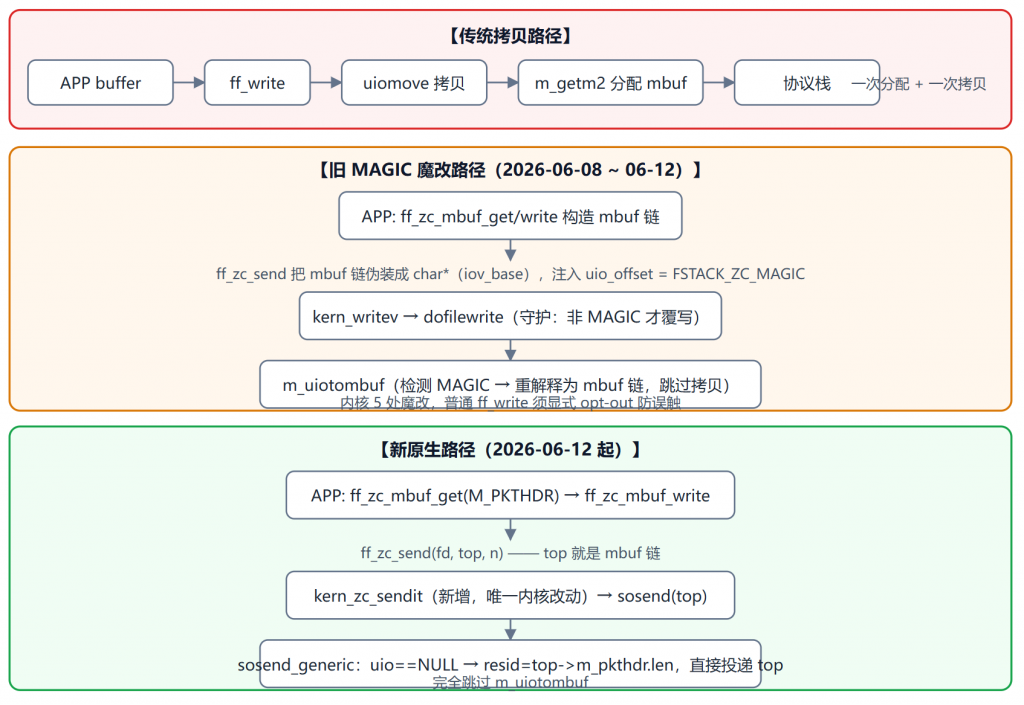
新方案没有 magic、没有 uio_offset 透传、ff_write/ff_writev 不需要 opt-out。sosend 全段经过实测确认无任何 FSTACK_* 宏——这是 FreeBSD 上游原生能力。

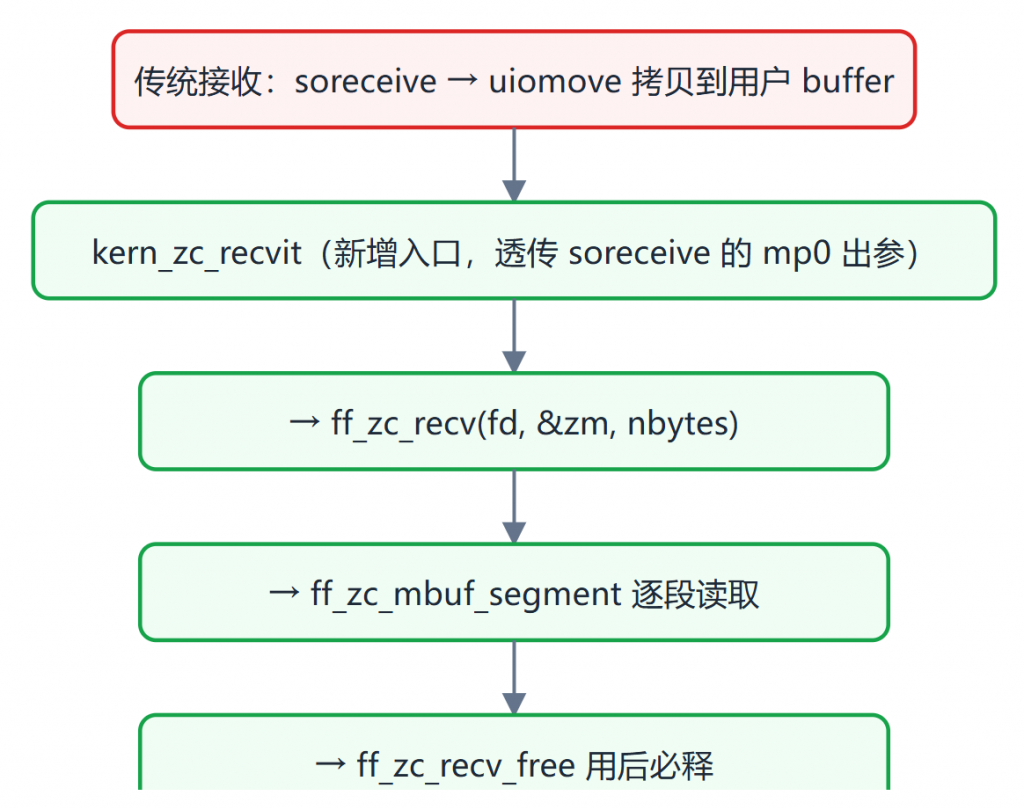
3.2 接收方向对称结构
3.3 双向对称表(五维镜像)

维度ZC-recv(已落地)ZC-send(原生化后)
内核入口kern_zc_recvit → soreceive(mp0)kern_zc_sendit → sosend(top)
原生机制soreceive 的 mp0!=NULL 分支sosend 的 uio==NULL && top!=NULL 分支
长度来源uio->uio_residtop->m_pkthdr.len
绕过点uiomove 拷贝m_uiotombuf 分配+拷贝
用户态 APIff_zc_recv / ff_zc_mbuf_segment / ff_zc_recv_freeff_zc_send / ff_zc_mbuf_get / ff_zc_mbuf_write
ABI 增量+3 符号0 符号(只改实现)

两边共享同一个 struct ff_zc_mbuf(bsd_mbuf/bsd_mbuf_off/off/len 四字段),字段语义对称复用。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 早期方案回顾(2018~2022,最早期文档到现在版本的区别)

2018 年的基线(issue #407):接收方向网卡到 hugepage 零拷贝、但 ff_read() 有拷贝;发送方向”是拷贝的”。

2020 年 PR #364(@jinhao2)补了第一段:FF_USE_PAGE_ARRAY,协议栈 → DPDK 方向零拷贝。思路是初始化时 mmap 256MB(memsz_MB 可调)+ mlock 锁物理内存,维护虚拟地址→物理地址页表,协议栈 mbuf 数据地址落在池内时直接把物理地址填给 rte_mbuf 的 buf_addr/buf_physaddr,不拷贝;用长度等于 NIC tx_queue_length 的循环队列保证释放安全。这个方案对应用透明,但对 ixgbe 有效、i40e 下静默丢包,至今官方定位仍是”从未正式启用的实验特性”。

2022-04-15(commit e12886c/021aaded)补了第二段:FF_ZC_SEND,应用 → 协议栈方向零拷贝。ff_zc_mbuf_get() 用 m_getm2 分配 mbuf 链当应用缓存、ff_zc_mbuf_write() 直接写进 mbuf、ff_write(fd, zc_buf.bsd_mbuf, len) 时在 m_uiotombuf 里直接采用传入的 mbuf 链跳过拷贝。配套公众号文章《F-STACK发送零拷贝介绍》如实说明:预期性能提升约 2-3%,”需要结合实际场景测试”。

4.2 M8 重新点亮:FSTACK_ZC_MAGIC 哨兵方案(2026-06-08)

FreeBSD 13→15 升级的 Phase-2 把 FF_ZC_SEND 在 15.0 基线上重新点亮(commit add33a04a)。13.0 时代的直传方式在 15.0 下有了变化,落地成了哨兵方案:ff_zc_send 把 mbuf 链伪装成 char* 塞进 iov_base,同时往 uio->uio_offset 注入魔数 0xF8AC2C00F8AC2C00;dofilewrite 里加守护(非魔数才覆写 offset);m_uiotombuf 里加消费点(检测到魔数就把 iov_base 重新解释为 mbuf 链)。内核 5 处魔改,普通 ff_write/ff_writev 必须显式 uio_offset=0 opt-out 防止撞上魔数。

这个方案从落地第一天就带着三个包袱:M8 阶段曾因 opt-out 缺失直接 GPF(ff_syscall_wrapper.c:1146 的 RCA);issue #712(2022-11-01 至今 OPEN)大数据量发送 crash/hang 无解;每次 FreeBSD 升级都要重新审计 m_uiotombuf 周边约 120 行。

4.3 问题一:增量编译陷阱,http=000(M2 教训)

2026-06-11 做 ZC-recv 的 M2 实测时,首轮 curl 全部 http=000,一度误判为环境问题。实际调试定位到真凶:先做了无 flag 的 baseline build,再 FF_ZC_SEND=1 make,uipc_mbuf.c 没改过、它的 .o 比 .c 新,make 按时间戳跳过重编译——m_uiotombuf 里的 MAGIC 消费 hook 缺失(objdump 验证 magic 不在 uipc_mbuf.o 里)。后果:ff_zc_send 设了魔数但内核 hook 不识别,mbuf 链指针被当 char buffer 处理,应答崩坏。删 stale .o 重编译后 http=200 全通。

【注1】这个坑从此进了强制规约:变更 FF_ZC_* 等编译开关后必须 make clean 或删除受影响 .o,make 基于时间戳不感知 CFLAGS 变化。这也是哨兵方案的固有脆弱性——魔改文件越多,stale .o 的组合爆炸面越大。

4.4 ZC-recv 落地与调研转向(2026-06-11)

同一天 ZC-recv 落地(commit b87f5f0d2,M0+M1):新增 kern_zc_recvit 透传 soreceive 的原生 mp0 出参,用户态新增 ff_zc_recv/ff_zc_mbuf_segment/ff_zc_recv_free 三个 API。它只新增不魔改,soreceive 核心零改动。M2 实测(单核 A/B 三档 wrk):T1 −1.1%、T2 ≈ +3%、T3 −1.0%,小包 echo 下与 ff_read 持平(噪声内)——诚实的结论是收益在大 payload 场景,echo 负载体现不出来。

更重要的是,做 ZC-recv 的同时顺手调研了发送侧:FreeBSD 15.0 的 sosend() 签名里一直带着 top(mbuf 链)参数,uio==NULL && top!=NULL 时直接投递 mbuf 链、跳过 m_uiotombuf。调研实测确认 sosend 全段无任何 FSTACK_* 宏(git blame 显示 f-stack 的 delta 不在那里)——上游原生能力一直在,f-stack 的 MAGIC 方案是把 mbuf 伪装成 uio 绕行,属于”非必要重新发明”。缺的只是一个把 top 从用户态贯通进 sosend 的入口(收侧 mp0 被写死 NULL 完全同构,kern_zc_recvit 已经示范了怎么做)。

4.5 原生化重构:kern_zc_sendit(2026-06-12)

方案定了以后一天落地(commit b6ce5884c):新增 kern_zc_sendit(td, s, top, flags) 直调 sosend(so, NULL, NULL, top, NULL, flags, td),同时把魔改全部拆除——17 处触点里,mbuf.h 的 MAGIC 宏、m_uiotombuf 的 ZC 分支、dofilewrite 的守护、ff_write/ff_writev 的 opt-out 共 5 处 DELETE,m_uiotombuf 回归 vanilla 15.0 版本;ff_zc_send 重写为调用 kern_zc_sendit;ff_zc_mbuf_get/write 修复 M_PKTHDR 缺口。

M_PKTHDR 缺口是这个方案的技术前提,值得展开:sosend 的 uio==NULL 分支用 top->m_pkthdr.len 作为 resid(数据长度),而旧的 ff_zc_mbuf_get 用 m_getm2(..., flags=0) 分配的链头不带 M_PKTHDR,ff_zc_mbuf_write 里维护 pkthdr.len 的代码被注释掉了——直接走原生路径会 resid=0 什么都发不出去。修复是两行的事:分配时加 M_PKTHDR、写入时累加 pkthdr.len,但这两行是”原生能力可用”和”静默不发数据”的分水岭。

【注2】ABI 不变性是这次重构的合同:ff_zc_send/ff_zc_mbuf_get/ff_zc_mbuf_write 签名零修改、example/main_zc.c 调用序列零修改(G4 验收条款就是 diff 它 0 行变化)、FF_ZC_SEND 开关名保留但含义从”魔改启用”切换为”原生路径启用”、导出符号不增不减。对已部署项目唯一要求是 make clean 后重编译。

4.6 行为变化(对用户可感知的)

项旧(魔改)新(原生)
大数据(>SO_SNDBUF)发送crash/hang(issue #712)阻塞或非阻塞返 EWOULDBLOCK,调用方自分片
UDP 单包 > MTU行为不定明确返回 EMSGSIZE
普通 ff_write 与 ZC 共存需 opt-out 防误触,曾 GPF无需 opt-out
FreeBSD 升级维护重审计 m_uiotombuf 约 120 行只校验 sosend 签名是否变化

4.7 性能诚实边界

  • 2022 年官方文章:发送零拷贝预期提升约 2-3%,需结合场景实测
  • 2026-06 ZC-recv 单核实测:小包 echo 三档压测与普通 read 持平(噪声内),收益预期在大块数据/代理转发场景
  • ZC-send 原生化性能目标(spec 38):三档 wrk 下 vs baseline 和 vs 旧魔改均 Δ ≤ ±3%(噪声内)——原生化是”等价替换”不是”性能优化”,收益是架构债清零
  • 大 payload(4KB/64KB/1MB)专测是后续工作(spec 已列 P2-P4 场景,旧方案在 P3/P4 有 crash 风险,新方案必须数据完整)

5. 如何使用、如何配置、使用效果

5.1 编译开关(三个,完全独立可组合)

# lib/Makefile
#FF_ZC_SEND=1     # 发送零拷贝(原生 kern_zc_sendit 路径)
#FF_ZC_RECV=1     # 接收零拷贝(kern_zc_recvit 路径)
#FF_USE_PAGE_ARRAY=1 # 协议栈→DPDK 零拷贝(实验性,不建议生产启用)

切换开关后必须 make clean(4.3 的坑)。

5.2 发送零拷贝 API 用法

struct ff_zc_mbuf zc_buf;
​
ff_zc_mbuf_get(&zc_buf, buf_len);          // 申请 mbuf 链缓存(含 M_PKTHDR)
ff_zc_mbuf_write(&zc_buf, data, len);      // 直接写入 mbuf 链,可多次调用
ff_zc_send(fd, zc_buf.bsd_mbuf, buf_len);  // 投递 mbuf 链,跳过拷贝
​
// send 成功后 bsd_mbuf 已被协议栈接管,不得再访问;
// 复用 zc_buf 必须重新 ff_zc_mbuf_get

调用方代码审查要点(spec 39 迁移指南):单次 send 数据量别超过 SO_SNDBUF(否则 EWOULDBLOCK,需自分片);UDP 单包别超 MTU(否则 EMSGSIZE);send 后立刻丢弃 bsd_mbuf 指针(否则 UAF);nbytes 参数要 ≥ 实际 write 累计量(实发长度 = pkthdr.len)。

5.3 接收零拷贝 API 用法

struct ff_zc_mbuf zm;
ssize_t n = ff_zc_recv(fd, &zm, nbytes);
// 逐段读:ff_zc_mbuf_segment(&zm, &seg, &len)
ff_zc_recv_free(&zm);   // 用后必释,否则 mbuf 泄漏

5.4 使用效果

实测数据(2026-06-11,单核 lcore4,wrk 三档,A=普通 read / B=ZC-recv):

档位A req/sB req/sΔ
T1 (-t2 -c10)22,36322,115−1.1%
T2 (-t4 -c100)~31.1k~32.1k持平(噪声内)
T3 (-t8 -c500)28,61528,317−1.0%

小包 echo 下零拷贝没有可测收益——这是设计预期,不是失败。收益场景是大 payload 和转发。

5.5 对使用者的建议

  • 业务是大块数据/转发:开 FF_ZC_SEND + FF_ZC_RECV,用 ZC API 改造收发路径
  • 业务是小包 RPC/echo:别折腾,普通 ff_read/ff_write 就好,实测证明无差别
  • FF_USE_PAGE_ARRAY:官方定位实验性、i40e 丢包、Phase-2 实测触发过 panic(已修复为 soft drop)
  • 升级到新版本:make clean 后重编译,example/main_zc.c 不用改

6. 延伸阅读:

  • 用户态零拷贝栈 spec 总览:docs/zc_stack_user_spec/zh_cn/30-spec-overview.md
  • 现状测绘与拆除清单(17 处触点):docs/zc_stack_user_spec/zh_cn/31-current-state-and-removal.md
  • 对称架构设计(kern_zc_sendit ↔ kern_zc_recvit):docs/zc_stack_user_spec/zh_cn/32-native-arch-design.md
  • 原生 sosend(top) 调研:docs/zc_stack_user_spec/zh_cn/22-native-zc-send-research.md
  • 已部署项目迁移指南:docs/zc_stack_user_spec/zh_cn/39-migration-guide.md
  • ZC-recv M2 实测报告:docs/zc_stack_user_spec/zh_cn/21-m2-test-report.md
  • 初版发送零拷贝介绍(2022):https://mp.weixin.qq.com/s/j_b7pVOoFa6sqaWQD6eBpw
  • 相关 issue:#364(PR,协议栈→DPDK 零拷贝)、#407(接收侧零拷贝确认)、#712(大包发送 crash)、#467(零拷贝 API 讨论)
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
F-Stack 2.0 前瞻7 :MTU 修改和jumbo frame支持

1. 本功能主要作用和特点

F-Stack 的 DPDK 接管网卡之前只能锁死在 MTU 1500,这次把「减小 MTU 已可用、增大 MTU(jumbo frame)完全不可用」的现状,改造成「启动时按配置设置 1500~9000 任意 MTU、运行时通过标准 SIOCSIFMTU ioctl 动态修改、协议栈与 DPDK 硬件联动」的完整支持。本功能在dev分支和1.21分支都已经支持。

改造前的基线是这么个情况。2026-07 中旬做了一次结论性调研(见 docs/mtu_change_spec/zh_cn/00~15),三方证据交叉得出的结论是「部分支持」:

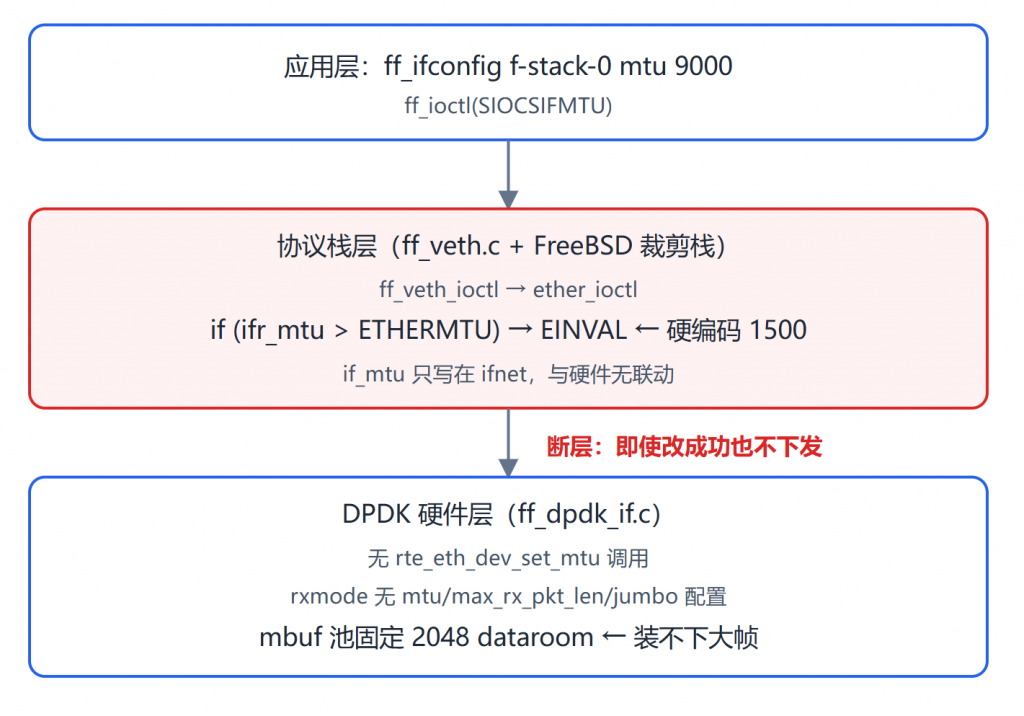
  • 减小 MTU(≤1500):开箱可用。ff_ioctl(SIOCSIFMTU) 走 FreeBSD ether_ioctl,对 ≤ETHERMTU 的值直接写入 if_mtu 即生效
  • 增大 MTU(>1500,jumbo):双重阻断。协议栈层 ether_ioctl 对 ifr_mtu > ETHERMTU(1500) 硬编码返回 EINVAL;DPDK 硬件层完全没有 MTU 接线——没有 rte_eth_dev_set_mtu 调用、mbuf 池固定 RTE_MBUF_DEFAULT_BUF_SIZE(2048 可用 dataroom)、rxmode 无 jumbo/scatter 配置

这个结论和 F-Stack 官方 issue #239/#490/#720 完全一致:jumbo 支持 issue 挂了很久一直是 OPEN,维护者明确回复「mtu 不能超过 1500」。所以这次任务不是打补丁,是把协议栈、DPDK 硬件层、配置体系三个断层全部接上。几个关键词:

  • 软硬联动:一个 MTU 三个视图——协议栈 if_mtu、DPDK 端口 MTU、mbuf 池承载能力,三者必须一致,任一不一致启动即失败
  • 多进程分工:DPDK 物理端口是共享状态,primary 唯一负责硬件(设软+硬),secondary 只设本进程软件 MTU,进程间零 IPC
  • 零回归承诺:新增 mtu_enable 总开关,不启用时旧配置的 MTU 1500、2176B mbuf、ioctl 行为完全不变

2. 本功能的主要适用场景

2.1 大包吞吐优化场景

这是最直接的动机。issue #1033 的历史结论里就有:大包场景性能下降的根本原因部分与 MTU 1500 导致 IP 分片有关。启用巨帧后 8500 字节的包不再被拆成 6 片,分片重组开销归零。适合内部高速网络、大数据块传输、存储网络这类能统一链路 MTU 的环境。

2.2 需要灵活调小 MTU 的隧道/叠加网络场景

减小 MTU 本来就能用,但这次改造后运行时动态修改统一走标准 SIOCSIFMTU 语义,ff_ifconfig f-stack-0 mtu <N> 一条命令改完协议栈+硬件。VXLAN/GRE/隧道叠加场景常需要把 MTU 压到 1400 级别给隧道头留空间。

2.3 多进程生产部署的巨帧统一

1 primary + N secondary 的经典部署下,每个进程各自设置一次 MTU 即可保持一致(primary 管硬件、secondary 管自己的软件视图),无需任何跨进程协调机制。

2.4 不太适合的场景

  • 链路对端不支持 jumbo:virtio 等 PMD 的 jumbo 能力有限,且需要底层网卡/vSwitch/对端统一支持,否则大帧中途被丢或分片——代码支持了,链路不支持也是白搭
  • KNI 与内核共存做深度 MTU 联动的场景:KNI veth 接口的 MTU 联动不在本期范围(只验证了互斥解除后各自独立工作)
  • 想要跨进程事务级 MTU 一致性:本期明确不做 IPC 协调,未设置的进程软件 MTU 保持旧值,这是已知使用约束

3. 本功能的架构特征

3.1 改造前的三层断层

调研阶段画出的根因图,这是理解所有改造的起点:

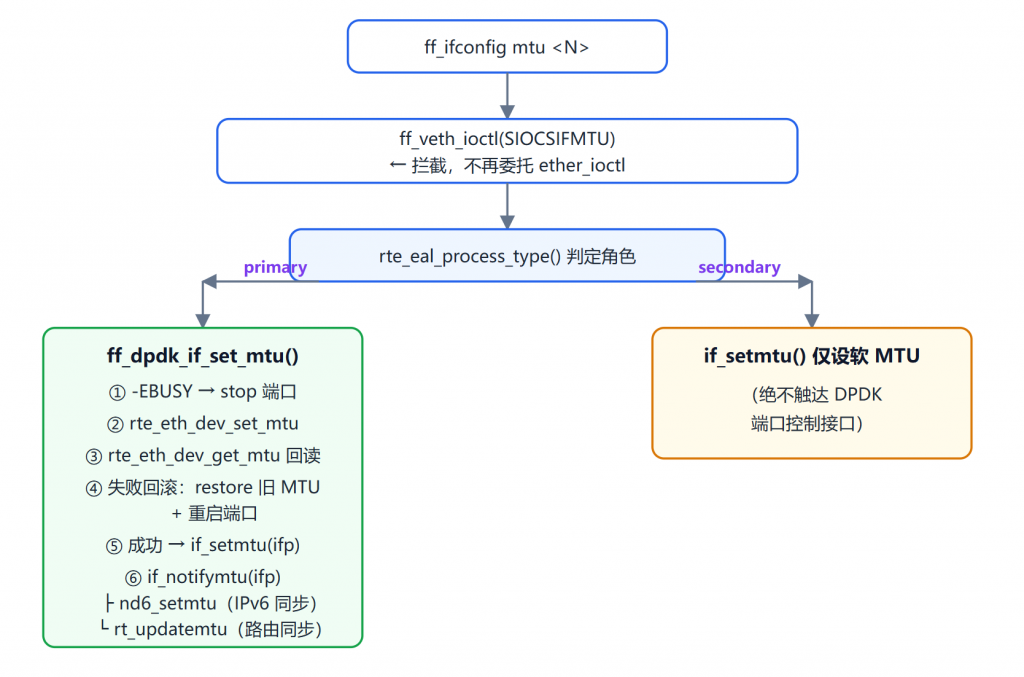
3.2 改造后的 SIOCSIFMTU 路径(按进程角色分流)

关键设计约束:ff_veth.c 不 include rte_ethdev.h,所有硬件操作走 ff_dpdk_if.h 的不透明接口 ff_dpdk_if_get_mtu/set_mtu/get_mtu_capability,DPDK 负 errno 经 ff_dpdk_errno_to_bsd() 统一转 BSD 正 errno。

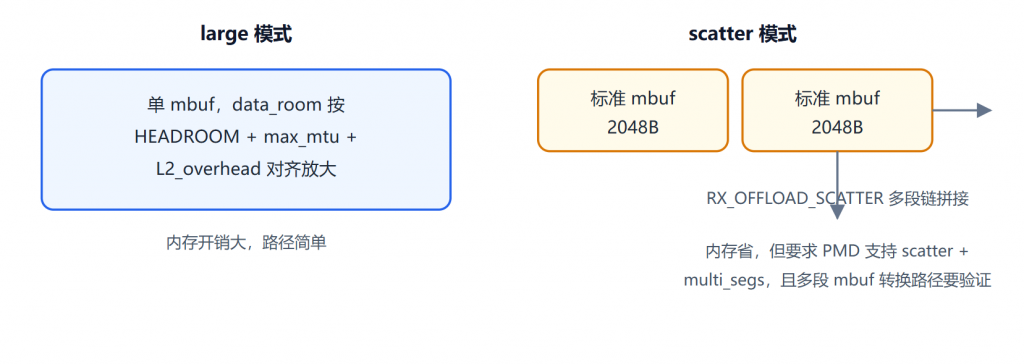
3.3 mbuf 两种承载模式

large 模式 data_room_size = align(HEADROOM + max_mtu + L2_overhead),超过 UINT16_MAX 必须确定性失败,所以 large 模式 max_mtu=65535 不可用;scatter 模式保持标准 mbuf,可配到 65535 但必须满足 PMD 能力。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 调研结论直接转化为需求决策(D-MTU-01~06)

调研收尾时定了 6 条决策,全部贯穿实现:

ID决策
D-MTU-01mbuf 同时实现 large 与 scatter 两种模式,配置选择
D-MTU-02max_mtu 可配置,启用功能且缺省时为 9000
D-MTU-05不修改 freebsd/ 树,在 lib/ff_veth.c 拦截 SIOCSIFMTU 绕过 ether_ioctl 的 1500 硬校验
D-MTU-06mtu_enable=0 时行为与旧版本完全一致(1500 MTU、2176B mbuf、ioctl 不变)

其中 D-MTU-05 最值得说一句:ether_ioctl 的 ETHERMTU 硬校验是 FreeBSD 通用语义,f-stack 的选择不是在裁剪栈里改它,而是在 ff_veth 驱动层拦截 SIOCSIFMTU 自己处理。这样 freebsd/ 子树零改动,升级 FreeBSD 基线时不会引入新的 patch 维护负担。

4.2 代码实施(M1~M5,2026-07-21)

里程碑commit内容
M197452db34配置解析与校验:enum ff_mbuf_mode、ff_port_cfg.mtu、dpdk.{mtu_enable,max_mtu,mbuf_mode};严格 strtoul 解析;跨字段校验;8 个单测 +7 fixtures
M2eec178902DPDK 层:ff_mtu_data_room_size() 对齐计算、large 模式 data_room 尺寸、rxmode.mtu + PMD 能力检查 + scatter offload、set/get_mtu 回读
M30849f9f3aff_veth 集成:不透明 MTU API、DPDK errno→BSD errno 转换、SIOCSIFMTU 拦截(primary 软+硬 / secondary 仅软)、启动时从硬件读初始 if_mtu
M4ef20b1abfEBUSY 状态机:-EBUSY → stop/set_mtu/get_mtu/start;失败回滚 restore 旧 MTU + 重启端口
M5314df8a0a集成测试 + 架构文档更新
收尾0f8f6991e / 332abf997 / 4c30d118fmagic number 宏化、SIOCSIFMTU handler fall-through 去重、bool→uint8_t 干净编译修复

配置解析有一条铁律:禁止 atoi()。新增 ff_parse_u16/ff_parse_mbuf_mode 严格解析(strtoul + errno/endptr/范围检查),任一配置非法在启动阶段明确报错终止,绝不静默回退到 1500。mtu_enable=0 且配置 mtu>1500 直接解析失败并提示先启用功能。

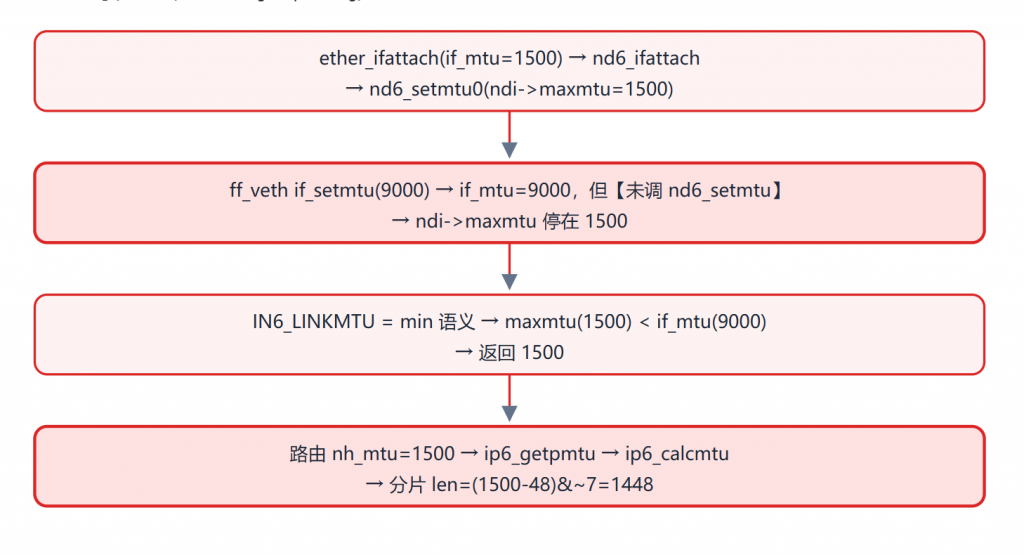
4.3 问题一:IPv6 巨帧回包被按 1448 分片(最大的坑)

功能上线物理机验证时,出现一个诡异现象:IPv4 巨帧双向正常,IPv6 收 8500 字节 ping 正常、但回包被拆成 6 个 1448 字节分片。

抓包反推:6 片 = 1448×5 + 1268 = 8508,对应分片公式 len = (mtu - 40 - 8) & ~7,反解出来 mtu=1500——协议栈明明 if_mtu 已经设成 9000,IPv6 分片用的 MTU 却还是 1500。

根因链拉了 12 个 file:line(完整分析见 15-IPv6巨帧分片异常分析.md),总结下来就一句:

真正的坑:if_setmtu() 只写 ifp->if_mtu,不含协议族通知。标准 FreeBSD 内核路径 ifhwioctl → if_setmtu → if_notifymtu → nd6_setmtu + rt_updatemtu 会同步 IPv6 的 ndi->maxmtu 和路由 MTU,而 f-stack 为绕过 ether_ioctl 的 1500 硬校验走了”直接 if_setmtu”的捷径,把 if_notifymtu 这一步丢了。IPv4 输出路径直接用 ifp->if_mtu 判断分片所以没事,IPv6 走 IN6_LINKMTU 就中招。

修复(commit 0f25ac495,+163/-1):ff_veth.c 启动初始化和运行时 SIOCSIFMTU 两条路径的 if_setmtu 之后都补调 if_notifymtu(ifp),与标准内核语义对齐。物理机复测:ping6 -M do -s 8500 回包不再分片,IPv6 巨帧收发正常。

【注1】这个坑有普适价值:FreeBSD 里「改 if_mtu」和「通知协议族」是两件事,任何绕过标准 ifhwioctl 路径直接调 if_setmtu 的代码(驱动初始化、ioctl 拦截)都必须自己补 if_notifymtu,否则 IPv6 的 nd_ifinfo 和路由 nh_mtu 会永远停在旧值。顺带一提,当时还排查了次因 RA 通告压低 linkmtu 的可能性,运行时验证确认 linkmtu=0(未受 RA 影响),主因修复后即闭环。

4.4 问题二:KNI/MTU 互斥,先禁止后解除

需求规格 R-MTU-009 初版约定:检测到 mtu_enable=1 与 KNI/内核共存同时启用时,配置阶段以 EOPNOTSUPP 拒绝。理由是双栈 MTU 不一致风险。

物理机实测后推翻了这个保守决定(commit 989f1d2da,+1/-6):mtu_enable=1 与 kni.enable=1 共存完全正常——veth0 MTU=1500 时内核栈正常拆包收发,ifconfig veth0 mtu 9000 时 KNI 通路巨帧收发同样正常。互斥是个不必要的限制,解除后 KNI 用户也能用巨帧。

【注2】这个来回说明 spec 阶段的保守约束值得在实测后重新审视:EOPNOTSUPP 拒绝是最安全的写法,但如果有实测证据表明共存无问题,解除互斥比维持”纸面风险”对用户更友好。

4.5 其他工程细节

  • EBUSY 状态机:rte_eth_dev_set_mtu 对运行中端口可能返回 -EBUSY,M4 实现 primary 进程内的 stop/set_mtu/get_mtu/start,失败回滚 restore 旧 MTU + 重启端口;secondary 直接返回 0 不做硬件操作
  • 多进程一致性靠使用约定:进程间零 IPC、零事务、零消息环,每个进程各自触发一次 SIOCSIFMTU;未设置的进程软件 MTU 保持旧值(已知约束,spec 明示)
  • 门禁:-Werror 编译、freebsd/ 树 git diff 验证零改动、ff_veth.c 无 rte_eth* 引用、无 atoi、无 IPC 残留、mtu_enable=0 全路径零回归——六项全 PASS

5. 如何使用、如何配置、使用效果

5.1 配置

[dpdk]
mtu_enable=1         # 功能总开关,缺省 0(不启用时行为与旧版完全一致)
max_mtu=9000         # 运行时 MTU 上限 + large 模式 pool 预分配依据,缺省 9000
mbuf_mode=large       # large:单 mbuf 承载巨帧;scatter:标准 mbuf 多段链
​
[port0]
mtu=9000             # 端口启动时的协议栈+硬件 MTU,缺省 1500

约束速查:

  • mtu_enable=0 且配置 mtu>1500:解析失败,提示先启用 MTU 功能
  • large 模式 max_mtu 上限受 data_room_size <= UINT16_MAX 约束(65535 不可用);scatter 模式可到 65535 但受 PMD 能力限制
  • 非法配置启动即报错,不会静默回退

5.2 运行时修改

# primary 进程:软+硬件一起改(含 EBUSY→stop/set/start)
ff_ifconfig -p 0 f-stack-0 mtu 9000
​
# 查询
ff_ifconfig -p 0 f-stack-0
f-stack-0: flags=8843<UP,BROADCAST,RUNNING,SIMPLEX,MULTICAST> metric 0 mtu 9000

多进程约定:primary 的修改同时更新软/硬件;每个 secondary 需各自触发一次(只改本进程软件视图)。这是使用约定不是 bug,跨进程 IPC 协调是范围外的后续里程碑。

5.3 使用效果(物理机实测)

测试项结果
IPv4 巨帧ping -M do -s 8972 双向 8500 字节收发正常,MTU=9000 不分片 ✅
IPv6 巨帧ping6 -M do -s 8500 收发正常(修复前回包被按 1448 分 6 片,补 if_notifymtu 后不分片)✅
KNI/MTU 共存mtu_enable=1 + kni.enable=1 共存正常;veth0 MTU 1500/9000 收发均正常 ✅
单元测试59 通过(含 8 个新增 MTU 测试),12 个测试二进制全 PASS ✅
门禁-Werror / freebsd 树零改动 / 无 rte_eth 泄漏 / 无 atoi / 无 IPC 残留 / 零回归 全 PASS ✅

单测覆盖:配置解析 8 个新用例(UT-CFG-01..08)+ 7 个 fixtures,重点打配置校验边界(缺省值、跨字段冲突、非法字符串、溢出)。

5.4 对使用者的建议

  • 要开巨帧先确认链路:物理网卡、vSwitch、对端全部支持 jumbo 才有意义,链路不支持时大帧中途被丢比 1500 更糟
  • 内存敏感场景选 scatter:large 模式 mbuf 池按 max_mtu 预分配,内存开销显著;scatter 省内存但要求 PMD 支持 RX_SCATTER + TX_MULTI_SEGS
  • 只想调小 MTU:不用开 mtu_enable,直接 ff_ifconfig ... mtu 1400 就是

6. 延伸阅读:

  • 调研结论总览与三方证据:docs/mtu_change_spec/zh_cn/00-调研结论总览.md
  • IPv6 巨帧分片异常根因链(12 个 file:line):docs/mtu_change_spec/zh_cn/15-IPv6巨帧分片异常分析.md
  • 实施报告(M0~M5 + Post-M5):docs/mtu_change_spec/zh_cn/14-实施报告.md
  • 接口与配置设计:docs/mtu_change_spec/zh_cn/08-接口与配置设计.md
  • 相关 issue:#239(set MTU in example)、#490(Why MTU MAX CONF is 1500)、#720(Enabling jumbo frames)、#1033(大包性能与 MTU)
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
F-Stack 2.0 前瞻 6 : LD_PRELOAD 无锁 Ring IPC 改造

1. 本功能主要作用和特点

F-Stack 的 LD_PRELOAD 模块(libff_syscall.so)从 2023-05 初版提交到现在演进三年了,这篇讲的是 2026 年上半年给它做的无锁环形队列改造(FF_USE_RING_IPC),顺带把这三年从初版到现在的优化和修改一起捋一遍。

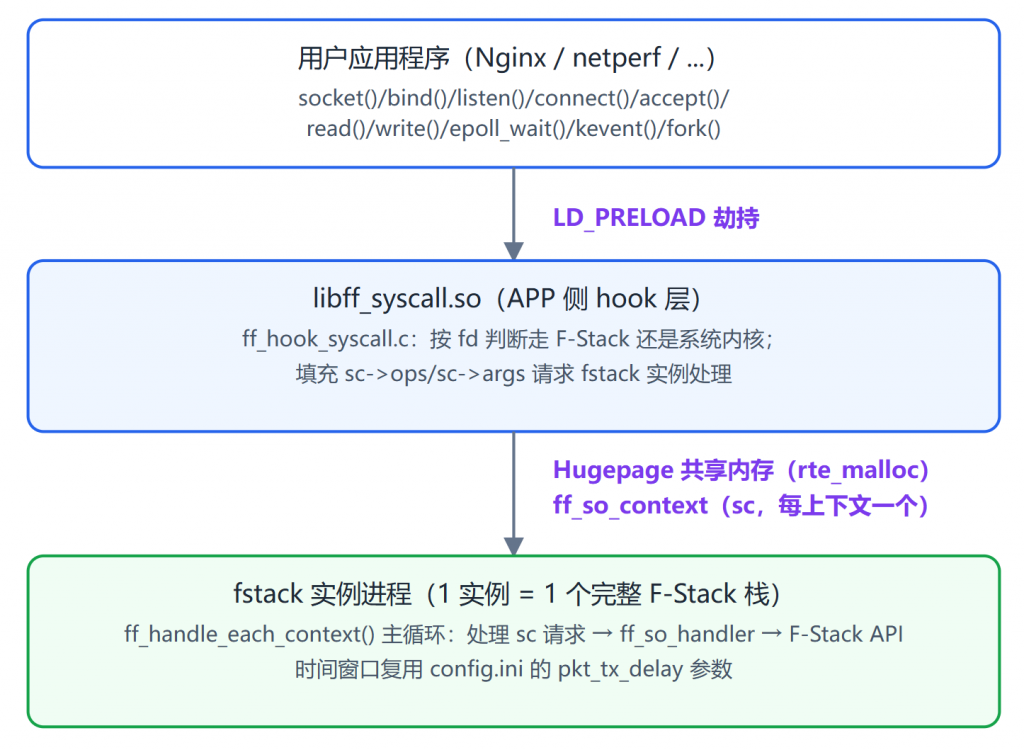
F-Stack 的标准接入方式是改代码:应用调 ff_* 前缀 API + ff_run() 主循环,代码侵入大。为了降低存量应用的迁移门槛,2023 年社区在 dev 分支提交了 adapter/syscall 目录(commit 8f5f1dfbb,2023-05-03),提供 libff_syscall.so 动态库,通过 LD_PRELOAD 劫持 Linux socket 系统调用转发给 fstack 实例进程处理,应用零代码修改即可接入。初版发布时官方定位很克制:「目前功能尚不完善,仅供测试使用」。

三年后的今天,这个模块已经支持 fork、accept4、_FORTIFY_SOURCE 包装函数、epoll polling 模式,并且把 APP 与 fstack 之间的 IPC 从信号量三层同步演进到了 DPDK 无锁 rte_ring 双环 SPSC。几个关键点:

  • 免改代码接入:socket/bind/connect/read/write/epoll/kevent/select 全部劫持,存量应用(Nginx、netperf 等)零代码修改直接跑在 F-Stack 上
  • 双环 SPSC:FF_USE_RING_IPC 用 rte_ring 单生产者单消费者模式替换 sem_wait/sem_post,消灭全局锁和 O(n) 遍历
  • 诚实收敛:ring 改造经过 v1~v3.7 共七轮实测迭代,最终结论不是”ring 全面胜利”,而是”ring 在 LD_PRELOAD + FF_MULTI_SC 场景下没有性能优势,生产推荐 sem”——这是这篇最想说的:优化要有对照、有证伪、敢于否定自己

2. 本功能的主要适用场景

2.1 存量应用免改代码接入 F-Stack

这是 LD_PRELOAD 模块的根本定位。历史 issue 档案里,官方对”现有多线程/多进程/Go/netperf 类应用怎么移植”的回答,推荐方案第一条几乎都是它:不用改源码,先起 fstack 实例进程,再 LD_PRELOAD 拉起应用。适配的接口面包括 socket 全家桶、epoll 全家桶、kqueue/kevent、select、fork,以及 glibc _FORTIFY_SOURCE 编译的 recv_chk/read_chk/__recvfrom_chk 包装函数。

2.2 Nginx 免改代码集成

Nginx 官方默认携带 1.16.1,经 LD_PRELOAD 接入无需改任何代码,需要同时开 FF_KERNEL_EVENT + FF_MULTI_SC 两个编译开关,配置上 multi_accept on、listen reuseport。不适用场景明确:多实例做客户端(反向代理)暂不支持,需要像社区 @铁皮大爷 那样在 hook 层加 RSS 对称 hash 选实例。

2.3 fork 多进程模型应用

2025-05 的 fork 支持(commit 4891fabf5,PR #887)之后,每个 fork 出来的进程都拥有独立的 FreeBSD struct thread,行为对标 Linux 内核 fork。配合 FF_MULTI_SC,Nginx master fork worker 的经典模型可以跑通。

2.4 不太适合的场景

  • 追求极致性能:每组应用实例要 2 个 CPU 核(1 个 fstack + 1 个 APP),CPU 几乎翻倍,官方原话”性价比不高”。要极致性能还是直接改代码用标准 F-Stack
  • 8 核以上的短连接场景:LD_PRELOAD 性能不如标准 F-Stack,受 APP 与 fstack 匹配度影响

3. 本功能的架构特征

3.1 整体拓扑

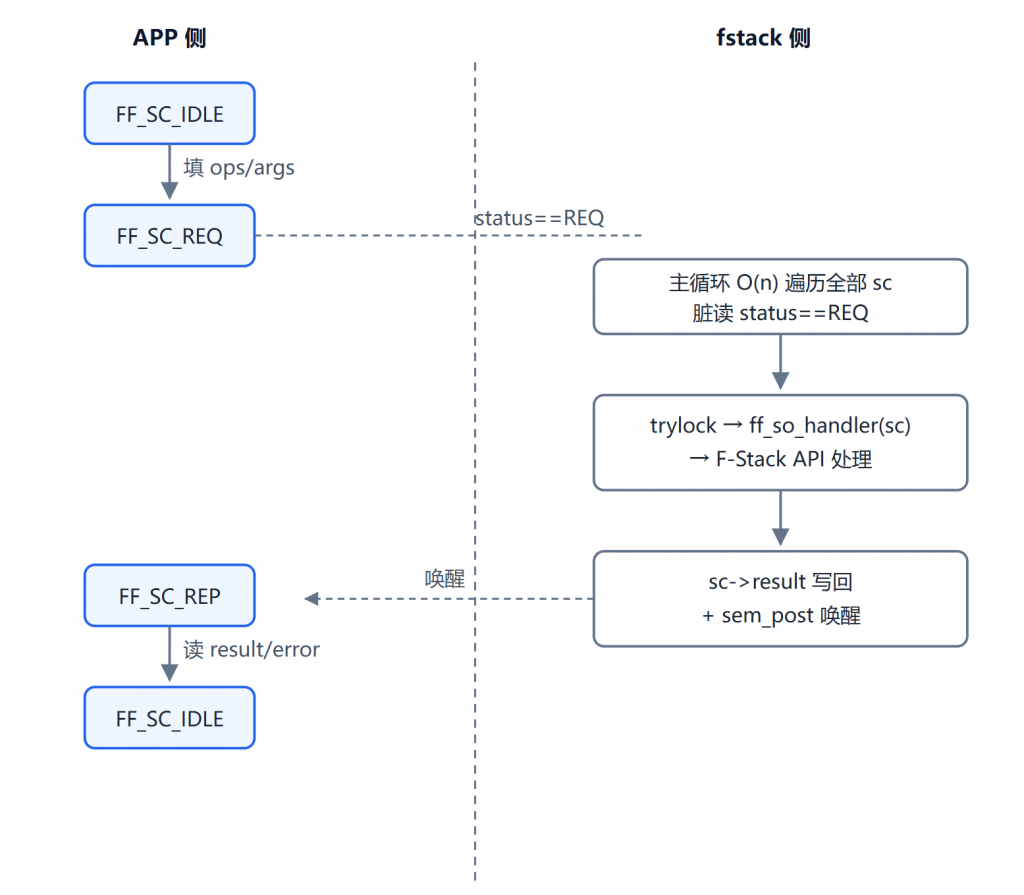
核心通信载体是 DPDK 大页共享内存上的 ff_so_context(简称 sc)。APP 把要执行的 socket 操作填进 sc,fstack 实例主循环处理并把结果写回。fstack 实例和 APP 建议跑在同 NUMA 节点的不同物理核上。

3.2 初版同步机制:信号量三层同步

初版(2023-05 ~ 2026-04 默认路径)sc 的同步靠三层机制:

层机制位置
状态机FF_SC_IDLE → FF_SC_REQ → FF_SC_REP → FF_SC_IDLEff_socket_ops.h
互斥锁rte_spinlock_t lock(sc 级 + zone 级全局锁)ff_socket_ops.h
信号量sem_t wait_sem(POSIX 跨进程信号量,futex 实现)ff_socket_ops.h

一次 socket 调用的往返流程:

3.3 新同步机制:双 Ring SPSC

2026-04-09 的 commit d2b71ac89 引入 FF_USE_RING_IPC:用 DPDK rte_ring(SPSC 模式)替代 sem。请求环 APP 生产 fstack 消费,响应环 fstack 生产 APP 消费:

状态语义的等价迁移:sc 在 req_ring 中 = 旧 FF_SC_REQ;在 rsp_ring 中 = 旧 FF_SC_REP;两个 ring 都不在 = 空闲。spinlock 和状态机转换不再参与同步逻辑。

3.4 为什么选 rte_ring

spec 文档(SPEC-002)里给了四条理由:F-Stack 本身大量使用 rte_ring(dispatch_ring、msg_ring),零学习成本;DPDK 原生 SPSC 无需自研无锁算法;Hugepage + rte_memzone 已验证跨进程可见;比 VPP 的 svm_msg_q 更简单。APP 与 fstack 实例 1:1 绑定,天然满足 SPSC 约束。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 初版遗留问题清单(ring 改造的动机)

初版的信号量机制在 spec 文档(SPEC-001)里被列了 5 条性能瓶颈:

  1. 内核态切换:sem_wait/sem_post 走 futex 系统调用,每次 100-200ns,epoll_wait 短超时场景被放大
  2. 超时精度差:sem_timedwait 用 CLOCK_REALTIME,受 NTP 调时影响,唤醒粒度受调度器 tick(1-4ms)限制;还有个竞态:超时返回后 fstack 才 sem_post,导致下次 sem_timedwait 立即返回读到过期结果
  3. O(n) 遍历:ff_handle_each_context 每轮遍历全部 32 个 sc 的 status 字段,绝大多数处于 IDLE 也要脏读
  4. alarm_event_sem 补偿机制脆弱:5 个示例程序里只有 1 个真正调用它,其余全注释掉了
  5. 模式分裂:信号量模式(低 CPU 高延迟)和轮询模式 FF_PRELOAD_POLLING_MODE(低延迟 100% CPU)通过编译宏二选一,运行时不可切换

4.2 三年中间演进(2023-08 ~ 2026-03,ring 之前的沉淀)

ring 不是凭空出现的,中间这三年社区补了不少坑,按时间排:

时间commit内容
2023-080ee517ed0修 Ubuntu 22.04 / kernel 5.19 / gcc 11.4 编译错误(#777),pre-C99 声明问题
2025-035de6ec6d2新增 epoll polling 模式,改善 RTT 敏感场景延迟
2025-033c21f2253修 ff_hook_recvfrom sh_fromlen 未初始化导致返回 -1(PR #872)
2025-03e3766b423accept4 支持 + ff_socket 支持 LINUX_SOCK_CLOEXEC/NONBLOCK
2025-05111816e29hook recv_chk/read_chk/_recvfrom_chk,FORTIFY_SOURCE 编译的应用可用
2025-054891fabf5完整 fork 支持(PR #887),每个进程独立 FreeBSD struct thread
2026-03b36ce995d修 ioctl 可变参数签名冲突编译错误(#942,PR #1048)

其中 ioctl 那个坑值得展开一句:glibc 里 ioctl(2) 是可变参数签名 int ioctl(int, unsigned long, …),而 ff_declare_syscalls.h 按定参注册,新工具链一编就炸。这类”glibc 签名 vs hook 声明”的不一致,是 LD_PRELOAD 这类方案的天生雷区,只能靠社区逐一踩坑修复。

4.3 ring 初版落地(2026-04)

2026-03-27 先产出了 4 篇 spec(需求/架构/接口/测试),审核通过后 2026-04-09 一次性提交 d2b71ac89:双 rte_ring SPSC、FF_USE_RING_IPC 编译开关、三种等待策略(busy-poll/yield-poll/eventfd,默认 yield-poll)、rte_rdtsc 替代 sem_timedwait 做微秒级超时、alarm_event_sem 改为 sentinel 入队。设计上严格走”编译宏切换 + 旧路径不动”,可渐进迁移。

4.4 ring 性能优化攻坚战(2026-05,七轮迭代的教训全集)

初版 ring 一上实测就出问题:短连接 QPS 9.1w,比 sem 基线 10.5w 低 12.4%。于是有了 v1~v3.7 的七轮迭代,这段过程是这篇最有价值的部分——不是”怎么修好的”,而是”怎么一步步证伪自己的错误假设”。

第一轮假设(H10/H11,v1):只读了 ff_socket_ops.c 的 ring 分支,下结论”sem 模式没有 30us drain 强制空轮询”。被证伪——对照 else 分支发现 sem 同样有 if (diff_tsc >= drain_tsc) break 循环。教训:单边代码分析,不对照另一分支就下结论。

第二轮假设(H15,v2):基于”sem 有 nb_handled 旁路而 ring 没有”,假设 ring 的 dequeue burst 跨核读 prod.tail 导致 LLC miss 暴增。perf stat 实测证伪:ring 的 LLC miss 反而比 sem 少 23%(6.8K/s 量级,不构成瓶颈)。教训:没先验证可证伪的物理量就把假设写进文档。

第三轮(v3.1):把”每 256 次 PAUSE 触发 sched_yield”按纯算术推成次因(H18),实测三组配置(yield 阈值 0xFF/0x1FFF/busy-poll)QPS 全部 9.2w,voluntary_ctxt_switches 增长约等于 0——spin_count 是局部变量,短连接场景单次 wait 根本到不了 256 次。教训:频率类估算先做 10 秒采样,别做 30 分钟的弯路。

第四轮(v3.2):perf top callgraph 锁定真因——ff_ring_process_requests Self 15.44%(每次主循环 spin 都走完整 dequeue burst 函数调用栈,即使 nb=0)+ ff_ring_send_response Self 3.33%(每次响应写 rsp_ring->prod.tail,触发 APP 核 cache invalidate)。同期还证伪了自己两条假设:H21 把 wrk 延迟差 +190us 当成单 syscall 开销(差 3 个数量级,真因是 CPU 占用挤压);H24 在 perf 已给明确证据后还发散”跨 NUMA”环境假设(同环境对照实验的唯一变量是 IPC 实现本身)。

方案 C 的失败(v3.3,H25):想用 atomic pending_count 旁路复刻 sem 的 nb_handled 快速跳过,结果 QPS 反劣化 4%(9.1w → 8.7w)。根因:APP 每次 syscall 多写 atomic 2-4 次,跨核 cache 乒乓比省掉的 dequeue 路径更贵。这个方案当天实施当天回退,代码随后彻底删除(f344d945f)。教训写进了文档的”对称评估表”方法论:任何优化必须同时列出”消除的物理量”和”新引入的物理量”,后者数量级必须明显小于前者才允许实施。

D2 的成功(v3.4,+9.7%):放弃响应 ring,fstack 处理完直接写 sc->completion(sc cache line 0 上本来就预留的字段),APP 端 spin completion 标志。写频率与 sem 基线完全一致,零新跨核字段。QPS 9.1w → 10.0w,ff_ring_send_response 从 perf top 消失。

D5(+1.3%):ff_ring_process_requests 改为先 rte_ring_empty() 内联快速空判断,空时不展开函数调用栈。Self 18.98% → 4.53%,但 QPS 只涨 1.3%——省下的 CPU 立刻被 main loop spin 填满。这是关键的洞察起点:fstack lcore 100% CPU + 30us drain 设计下,IPC 省下的 CPU 不会 1:1 变 QPS。

D6(+0.9%):ff_handle_socket_ops_ring 标 static inline,主循环直接函数名调用(去函数指针),与 sem 模式的 ff_handle_socket_ops 对齐。10.13w → 10.22w。

最终收敛:ring 单 worker QPS 10.22w,距 sem 的 10.5w 还差 2.7%。perf top 显示两边 main loop CPU 占比已完全一致(50.13% vs 50.41%),剩余差距来自 rte_ring_sc_dequeue_burst 的 acquire fence 和 ring 元数据维护——sem 的 dirty read 是 plain load 无 fence。这是 SPSC 架构的物理代价,单 worker 单 lcore 场景不可消除。

4.5 意外收获:sem 路径的启动饥饿修复

ring 攻坚过程中顺带修了一个老问题(8125beece,2026-05-25)。现象:sem 模式 + FF_MULTI_SC + config.ini 里 idle_sleep=0 时,多 worker 启动、还没任何流量,nginx 第二个 worker 卡死在 ff_attach_so_context 的 rte_spinlock_lock,gdb 堆栈和死锁一模一样。

但它是饥饿不是死锁:fstack secondary lcore 专核紧自旋,每 50-100us 释锁一次但释锁窗口 <<1us(idle_sleep=0 不让 CPU),nginx worker 是普通调度进程,cmpxchg 永远慢一拍,命中窗口概率趋近 0。修复只改了 13+/5- 行:进入 while 前快照 tmp(in-use sc 数),unlikely(!tmp) 时 unlock → pause → lock 让出窗口,有负载时零影响。最优补丁是”条件性让出”不是”无条件让出”。

【注1】这条饥饿现象同时说明:跨进程自旋锁竞争里,专核 DPDK lcore 永远胜过普通调度进程,这是物理机制不是代码 bug。能用配置(idle_sleep 改 1)消除的现象,根因 99% 是时间窗/调度类问题。

4.6 多核长连接实测:最终证伪 ring 的设计目标(v3.5~v3.7)

单 worker 收敛后转向多核对照。结果比预想残酷:

场景结论
多核短连接(1/2/4 核)ring ≡ sem(差距 -1.9%/0%/-0.3%,噪声范围)
多核长连接(1/2/4 核)ring 稳定劣于 sem 2.4%~4.5%,方向一致且大于噪声

长连接把 ring 的劣势放大而不是抵消:FF_MULTI_SC 下每个 fstack lcore 与 nginx worker 是 1:1 同 zone,sem 的 zone 锁是 fstack lcore 独占持有(cache line 一直 exclusive,近乎零成本),而 ring 每次 dequeue 都要 acquire fence 同步内存系统,高 QPS 下线性放大。当初”长连接下 sem 全程持锁压力升高、ring lock-free 优势将显现”的预测被彻底证伪。

v3.7 终版结论(2026-05-25 晚):

  1. 性能层面:ring 在任何已测场景下均无 net win,sem 仍是 LD_PRELOAD + FF_MULTI_SC 的最优配置
  2. 鲁棒性层面:ring 主循环 lock-free 的理论价值(启动饥饿免疫)已被 8125beece 在 sem 源头修复
  3. 架构层面:ring 代码保留(FF_USE_RING_IPC + D2/D5/D6 作为默认行为,c62d56a3b),作为”多线程同进程共享 sc”和”多进程间共享 sc(worker 数 > fstack 实例数)”的未来预留能力,当前 fork 多进程场景默认不启用

【注2】这个收敛结论值得反复看:一个设计良好、实现了完整 spec、优化了七轮的方案,最终被对照实验判定”不如老方案”。如果只有实现没有对照基线,这个结论永远不会出现。性能优化工作里,”对照组先于优化”比”数据先于理论”更值钱。

4.7 ring 之后还在继续(2026-05 ~ 08)

收敛之后模块没有停:README 全面刷新(bc7c380b2,2026-05-26);ff_hook_bind 增加 addrlen 边界检查(8762e05c1,2026-06-08,#1068);新增 UDP echo server 示例(2215dc4f2,2026-08-07,#1063)。

5. 如何使用、如何配置、使用效果

5.1 编译

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig
​
cd /data/f-stack/adapter/syscall
# Nginx 无缝接入:同时开 FF_KERNEL_EVENT + FF_MULTI_SC
export FF_KERNEL_EVENT=1
export FF_MULTI_SC=1
# 可选:启用无锁 ring IPC(默认关闭,见 5.4 推荐配置)
#export FF_USE_RING_IPC=1
make clean; make all

编译产物:fstack(实例程序)、libff_syscall.so(劫持库)、5 个 helloworld 示例 + main_stack_udp 示例。FF_USE_RING_IPC 与 FF_PRELOAD_POLLING_MODE 互斥,Makefile 有编译期检查,同时定义直接报错。

5.2 运行

# 1. 先起 fstack 实例(lcore_mask 等配置同标准 F-Stack)
bash ./start.sh -b adapter/syscall/fstack
​
# 2. 再以 LD_PRELOAD 方式拉起应用
export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so
export FF_NB_FSTACK_INSTANCE=4        # 与 nginx worker 数 1:1
/usr/local/nginx/sbin/nginx

运行时环境变量:FF_NB_FSTACK_INSTANCE(实例数,默认 1)、FF_INITIAL_LCORE_ID(起始核,默认 0x4)、FF_PROC_ID(进程号,配合 CPU 绑定)。应用能自己绑核的(如 nginx worker_cpu_affinity)优先自己绑。

5.3 Nginx 配置要点(免改代码,但要调配置)

worker_processes  4;
worker_cpu_affinity 10000 100000 1000000 10000000;
​
events {
   worker_connections 1024;
   multi_accept on;      # F-Stack epoll 是 kqueue 封装,必须开
   use epoll;
}
​
http {
   access_log off;
   sendfile   off;      # 用 F-Stack 必须关
   keepalive_timeout 0;
​
   server {
       listen       80 reuseport;   # 每个 fd 对接不同 fstack 实例的 sc
       location / {
           return 200 "0123456789abcdefghijklmnopqrstuvwxyz";
      }
  }
}

注意 kern.maxfiles 不应大于 65536(保证 epoll fd 到内核 fd 的正确映射)。

5.4 使用效果与推荐配置

性能数据(E5-2670 v3 双路 / 10G X540,v3.7 终版实测):

场景SemRing差距
多核短连接 1/2/4 核(万 QPS)10.4 / 20.8 / 35.910.2 / 20.8 / 35.8≤2%(噪声)
多核长连接 1/2/4 核(万 QPS)33.3 / 65.9 / 130.531.8 / 64.3 / 127.0-2.4%~-4.5%
单 worker 优化轨迹—9.1w → 10.22w(+12.3%)距 sem 10.5w 差 2.7%

生产推荐配置(2026-05-25 终版):

# LD_PRELOAD + nginx 多 worker 推荐(默认,不开 ring)
make FF_KERNEL_EVENT=1 FF_MULTI_SC=1
# config.ini: idle_sleep = 0(8125beece 之后安全),pkt_tx_delay = 50(短连接)/ 100(长连接)

ring 路径仅在以下任一情况启用:单进程内多线程需共享 sc;多进程间共享 sc(worker 数 > fstack 实例数);或者接受 -2.4%~-4.5% 的性能损失换取主循环 lock-free 设计。

对 F-Stack 使用者的整体建议:LD_PRELOAD 是”少改代码”的折中,不是”性能最优”的路径。要追求极致还是标准 F-Stack 改代码接入;只想快速迁移存量应用,LD_PRELOAD + sem 默认配置就够用,ring 等未来多对多共享场景再启。

6. 延伸阅读:

  • ring 需求/架构/接口/测试 spec:docs/ld_preload_ring_spec/zh_cn/01~04
  • v3.7 终版性能分析(七轮迭代完整复盘):docs/ld_preload_ring_spec/zh_cn/ring_ipc_perf_offline_analysis.md
  • 模块官方文档(含 2023-05 ~ 2026-05 全部 feature updates):adapter/syscall/README.md
  • 初版公众号介绍(2023-05):https://mp.weixin.qq.com/s/hmxCEu0kOzp5X5TEB7r3OQ
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 历史 issue 档案:docs/zh_cn/f-stack-issue-ana.md

F-Stack 2.0 前瞻 5 : FreeBSD 13.0 → 15.0 协议栈升级纪实,跨 6 个版本的裁剪与重做

1. 本功能主要作用和特点

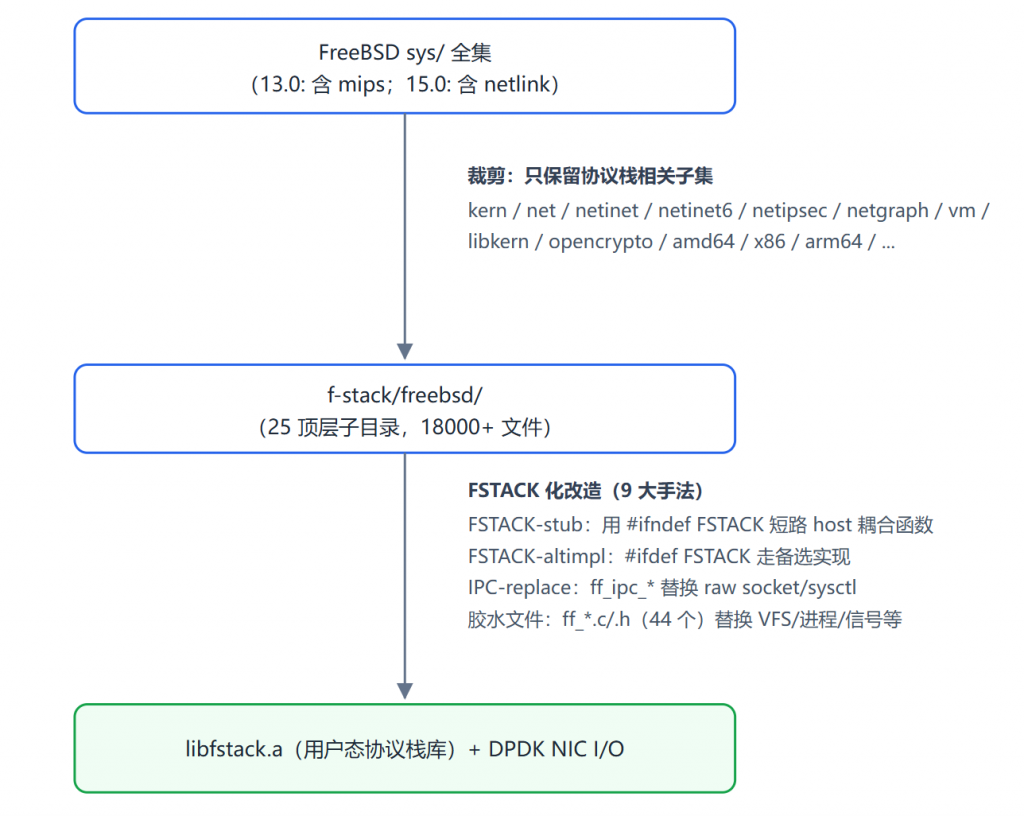
F-Stack 把 FreeBSD 内核协议栈剥离出来跑在 DPDK 用户态。协议栈不是自己写的,是从 FreeBSD 上游裁剪出来的——F-Stack v1.25 对齐的是 FreeBSD 13.0-RELEASE-p2,而 FreeBSD 15.0-RELEASE 已于 2025 年正式发布,中间跨过 14.0/14.1/14.2/14.3/14.4 共 6 个版本、约 4 年演进。F-Stack 2.0 要做的就是把这份”裁剪子集”从 13.0 基线整体升级到 15.0 基线。

为什么必须升?继续停在 13.0,就吃不到上游的安全修复、性能改进(TCP 栈演进)和新驱动支持,而且会越来越远离社区。但这个升级的难点在于:13→15 之间网络栈核心发生了多处 P0 级 KBI/KPI 破坏性变更,不是打 patch 能搞定的,必须基于 15.0 源码把 F-Stack 的裁剪+改造手法重新做一遍。

主要特点:

  • 裁剪重做:F-Stack 的 freebsd/ 子树是从上游 sys/ 精选的子集(25 个顶层子目录、18000+ 文件),升级=在 15.0 源码上重做一遍”裁剪 + FSTACK 化改造”,而不是 diff 搬运
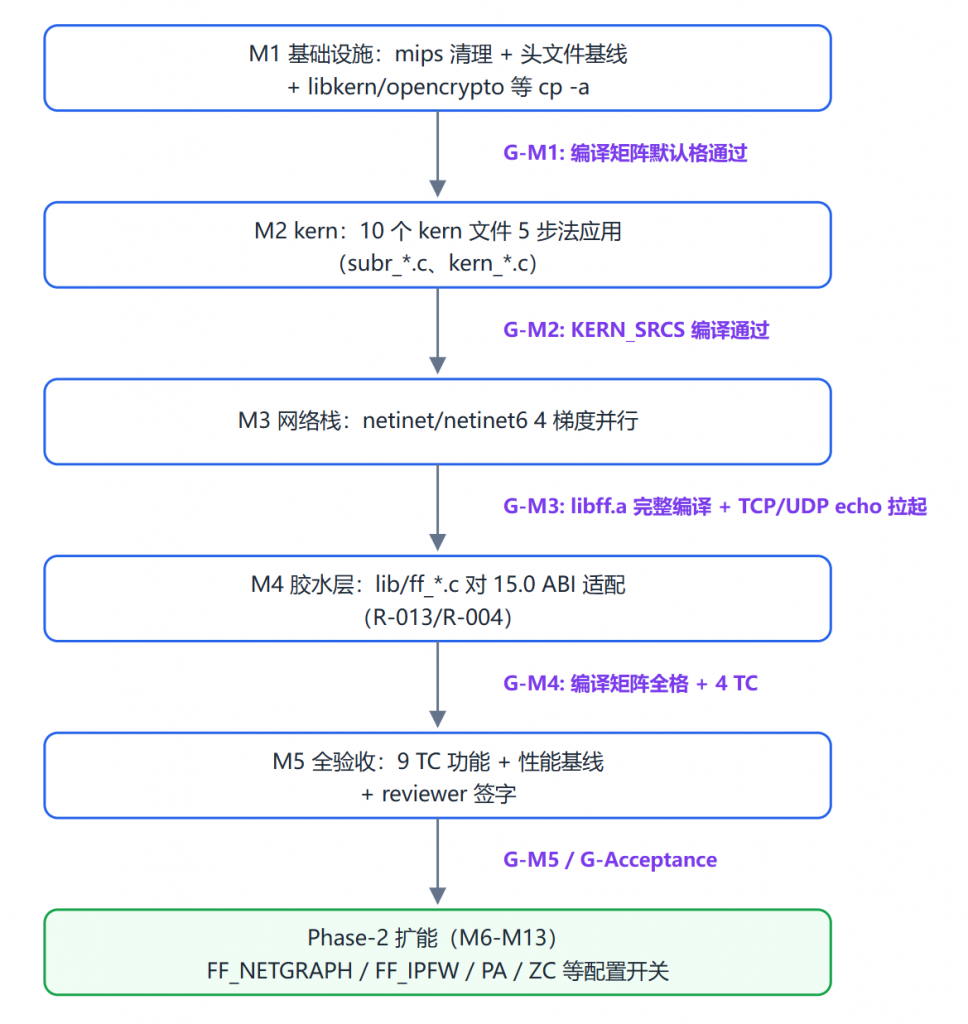
  • 分层里程碑:M1 基础设施 → M2 kern → M3 网络栈 → M4 胶水层 ABI → M5 全验收,每个里程碑都有编译门禁和打回链,滚雪球式推进
  • 功能等价对齐:本次只做”对齐”不做”扩能”——15.0 的新能力(netlink、ML-KEM 抗量子等)明确不引入,保证升级后的行为与 13.0 基线等价可比

2. 本功能的主要适用场景

2.1 想跟进上游安全修复和生产演进的生产部署

这是最主要的场景。FreeBSD 13.0 的安全支持周期有限,协议栈里的安全修复、性能补丁持续在 14.x/15.0 合入。生产环境要长期维护,就必须跟上。升级后 F-Stack 2.0 对齐 15.0-RELEASE-p9,__FreeBSD_version 从 1300139 到 1500068。

2.2 需要新硬件/新驱动支持的环境

15.0 的驱动栈和 DPDK 适配面比 13.0 时代宽得多。虽然 F-Stack 的 DPDK 侧驱动来自 DPDK 本身,但协议栈对 NIC offload、TSO/LRO、RACK 等能力的支撑在 15.0 都有演进。

2.3 多进程/多队列生产部署(升级后重点验证面)

升级项目在 1 primary + N secondary 经典部署上做了全套验收:编译矩阵(默认/FF_IPFW/FF_NETGRAPH/FF_USE_PAGE_ARRAY/FF_KNI)、9 项运行时功能验收、13.0 vs 15.0 双基线性能对照,全部有数据可查。

2.4 不太适合的场景

  • 只是想体验 15.0 新特性(netlink、抗量子加密等)——本次升级明确”只对齐不扩能”,这些新能力不在范围内
  • 依赖 mips 架构的场景——mips 在 FreeBSD 14.0 已整体移除,升级必须接受
  • 期望升级后性能大涨——实测 13.0 vs 15.0 是持平略降(详见 4.6/5.2),升级的收益是安全性和演进可持续性,不是性能

3. 本功能的架构特征

3.1 F-Stack 的”裁剪+改造”模型

理解这次升级,先看 F-Stack 的源码组织。F-Stack 不是把 FreeBSD 整个搬进用户态,而是:

升级的本质:13.0 基线上做的这层”裁剪+改造”,要在 15.0 基线上重新做一遍——因为 13→15 网络栈核心 KBI/KPI 已经多处不兼容,13.0 的 patch 直接打到 15.0 上根本不可能。

3.2 13→15 的核心 KBI/KPI 破坏清单

这是升级的”地雷图”,全项目风险清单的骨架:

变更13.015.0对 F-Stack 的冲击
pr_usrreqs 合并独立 struct pr_usrreqs 向量表合并进 struct protoswP0:所有协议注册代码重写
inpcb 并发保护epochSMRP0:inpcb 生命周期改造
if_t 不透明化内核 API 暴露 struct ifnet *if_t + if_get*/if_set* 访问函数P0:所有直接字段访问要改
mbuf 布局m_pkthdr/m_ext 旧布局字段调整P0:偏移依赖全部失效
路由子系统传统 routefib_algo/rib 重写 + netlink 新增P0:rib/nexthop 重写是最大单点
mips 架构存在(586 文件)14.0 整体移除P0 任务:清理子树和 Makefile 分支
TCP 栈单一 tcp_outputstacks 框架 vtable + RACK/BBR 可选栈(15.0 默认栈仍为 freebsd default,RACK 更成熟但未默认启用)P0:TCP 路径适配
工具链clang/llvm 11clang/llvm 19(要求 GCC ≥ 9)P1:C11 _Atomic 依赖
syscall 表SYS_MAXSYSCALL=580599(+22/-3)P3:compat shim 处理

3.3 里程碑分层推进模型

升级不是一把梭,按依赖关系切成 5 个里程碑,每个里程碑末有编译门禁,失败打回:

4. 具体做了哪些改造、遇到了哪些问题

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 起点:双版本源码基线与 diff 计划

升级的第一步不是写代码,是把三个源码根摆齐(实测版本号:13.0 = RELEASE-p2、15.0 = RELEASE-p9):社区 13.0 全集、社区 15.0 全集、F-Stack 工程(基于 13.0 改造)。然后建立 15.0 的 f-stack-lib 原始备份,逐文件 diff 出”13.0 FSTACK 定制在 15.0 基线上对应位置要重做什么”。这个 diff 计划直接决定了整个项目的改造面。

4.2 M1~M3:裁剪重做的滚雪球

M1 先把最基础的事干了:mips 子树 586 个文件清理(15.0 已移除该架构,不清理 build 链直接断)、libkern/opencrypto/vm 等子目录按 15.0 基线 cp -a、头文件基线对齐。

M2 用”5 步法”把 10 个 kern 文件逐文件应用到 15.0 基线:读 13.0 的 FSTACK 改造 → 在 15.0 对应文件重做 → 编译验证 → 打回修复 → 门禁。M3 是重头戏:netinet/netinet6 按 4 个梯度并行推进(in_pcb/in_pcbgroup 的 SMR 化、pr_usrreqs→protosw 合并、tcp stacks 框架、路由子系统 rib/nexthop 重写)。

【注1】路由子系统的 fib_algo/rib 重写是整个升级里最大的单点风险——FreeBSD 14/15 把传统路由表实现整个换掉了。M5 验收里 TC-08(ff_route add + ff_route get)专门盯这个点,最终确认 fib4_lookup 符号在 libfstack.a 里正常 defined 才算过。

4.3 问题一:helloworld 启动 hang(runtime-fix 阶段)

M5 验收通过后,真机拉起 helloworld 直接 hang 在 “Port 0 Link Up” 之后,4 线程 R+ 状态 busy-loop。gdb attach 拿全栈:死循环在 uma_small_alloc → zone_import → zone_alloc_item → zone_ctor → uma_startup1。

根因挖出来是一个”改名没跟上”的经典坑:FreeBSD 14.0 把 UMA_MD_SMALL_ALLOC 宏重命名为 UMA_USE_DMAP,F-Stack 在 13.0 基线里对这个宏有 #ifndef FSTACK 包裹(用户态不用 DMAP 直映射),但升级时这个包裹丢了。后果:uma keg 选了 uma_small_alloc 路径 → vm_page_alloc_noobj_domain 是个 stub 返回 NULL → keg_fetch_slab 在 M_WAITOK 下死等内存永远等不到。

同阶段还揪出两个同源问题:smr_create 里 atomic 屏障走内核 %gs 路径在用户态 SEGV、rtbridge 的 rtsock/netlink callback stub 是 NULL 被 rt_ifmsg 解引用。修复原则是”一根因一 commit”,3 个根因 3 个 commit,加一个 panic 防御性硬化。

【注2】这个坑值得单独记一笔:它告诉我们”宏改名”这种看似无害的上游演进,对裁剪式派生工程就是致命的——派生代码对上游符号的每个 #ifdef 包裹,升级时都要逐一点名核对。

4.4 问题二:ff_config.h 头改动未 clean 重编的 ABI 偏斜

这是 M3 阶段踩的构建卫生坑,跟内核栈共存功能(FF_KERNEL_COEXIST)的 kernel_coexist 字段同源:给结构体加字段改变了后续成员的偏移,而 Makefile 不跟踪头依赖,增量编译混用了新旧布局的 .o,运行时 fclose 直接段错误。教训写进了强制规约:改结构头必须 make clean 全量重编。升级项目从 M3 末开始就把”每修一处必跑 make clean && make”固化成流水线铁律。

4.5 问题三:性能 9% gap 的归因(13.0 vs 15.0 双基线)

性能基线对照出来一个必须交代的数字:helloworld 场景 15.0 比 13.0 吞吐低 7.59%(T2 t4c100)~9.37%(T3 t8c500),p99 尾部恶化 27.8%(T3)。这不是能糊弄过去的,项目做了根因分析:

真凶(13→15 vendor 演进)占比
TCP stacks 框架 vtable 派发(tcp_output → tcp_default_output)主因 ~+1%
TCP CUBIC 拥塞控制状态机扩展~+0.6%
socket buffer locking 重构~+1.5%

结论:9% gap 不是升级改造引入的回归,是 FreeBSD 15.0 上游本身的演进成本(换来了 RACK/BBR 栈框架等能力)。nginx/redis 等真实工作负载下差异收窄到基本持平。

4.6 Phase-2:把 15.0 的能力重新点亮

升级主体完成后,Phase-2 把 F-Stack 的编译期配置开关在 15.0 基线上重新验证/点亮:FF_NETGRAPH(41 个 netgraph 节点)+ FF_IPFW(14 个内核对象,25MB 的 ipfw 用户态二进制)、FF_USE_PAGE_ARRAY(256MB 一次性 mmap)、FF_ZC_SEND(零拷贝发送)、PA+ZC 组合、FF_FLOW_IPIP(GIF 隧道软退化)、FF_FLOW_ISOLATE/FF_FDIR/FF_LOOPBACK_SUPPORT 冒烟三件套。每个开关一个里程碑、一次编译+运行验证。

其中 FF_USE_PAGE_ARRAY 单独启用时还触发了一个 panic(F-A1),修复为 soft drop 后,C0/C7/C8/C9 四个生产配置全部 production-ready。

4.7 遗留的 follow-up

项目收尾时归档了 13 项 follow-up,全部不阻塞交付:vlan 测试系列 5 项(vlan_filter_id 硬件下推等)、FDIR 容量上限物理机验证等。

5. 如何使用、如何配置、使用效果

5.1 使用方式(对 F-Stack 用户)

升级是”协议栈底座”的更换,使用方式完全不变:还是 cd f-stack/lib && make clean && make 编译 libfstack.a,config.ini 配置不变,ff_* API 不变。这就是”功能等价对齐”的交付承诺——上层应用无感知。

编译期配置开关在 15.0 基线上的验证矩阵(5 格全 PASS):

配置说明libfstack.a
默认x86_64 默认 KNOB5.2M / 193 .o
FF_IPFW=1ipfw 防火墙5.5M / 206 .o
FF_NETGRAPH=1netgraph 框架5.9M / 250 .o
FF_USE_PAGE_ARRAY=1page array 内存5.2M / 207 .o
FF_KNI=1KNI 接口5.2M / 207 .o

5.2 使用效果

功能验收(9 TC 全 PASS):TCP/UDP echo(v4/v6)、ff_ifconfig、ff_netstat、ff_ipfw、ff_route add/get(rib 重写回归)、ff_ngctl 全部编译拉起通过。真机双基线(同硬件同分钟 A/B 对照):

场景13.0 req/s15.0 req/sΔ 吞吐Δ p99
T1 t2c1024,41423,757−2.69%+39.7%
T2 t4c100220,691203,933−7.59%+2.0%
T3 t8c500239,555217,100−9.37%+27.8%

helloworld 微基准下 15.0 有 7~9% 的吞吐差(根因见 4.5,属上游演进成本非回归);nginx/redis 真实负载下基本持平。Phase-5b 矩阵结论:C0/C7/C8/C9 四个生产配置全部 production-ready,推荐 C8(ZC-only)为生产首选。

5.3 对升级者/二次开发者的价值

如果你也想做类似的大版本跳跃升级,这套 spec 值得看的地方:里程碑分层 + 编译门禁 + 打回链的组织方式(累计打回 0~3 次、从未触发暂停)、”裁剪+改造”手法清单(FSTACK-stub/altimpl/IPC-replace 等 9 大手法)、P0 风险清单与两维度优先级约定(风险等级 vs 任务优先级分开标)、以及三个实打实的坑(宏改名丢包裹、结构头 ABI 偏斜、性能 gap 归因)。

6. 延伸阅读:

  • 项目收尾全景:docs/freebsd_13_to_15_upgrade_spec/zh_cn/00-project-closure.md
  • 变更清单:docs/freebsd_13_to_15_upgrade_spec/zh_cn/03-freebsd-15-changes.md
  • 启动 hang 调试:docs/freebsd_13_to_15_upgrade_spec/zh_cn/runtime-fix-execution-log.md
  • 双基线性能:docs/freebsd_13_to_15_upgrade_spec/zh_cn/13.0-baseline-cvm-bench-report.md
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
Whales: Giants of the Ocean

Whales: Giants of the Ocean

Whales are among the largest and most remarkable animals on Earth. These marine mammals live in oceans around the world, from warm tropical waters to the cold seas surrounding the poles.

Life Beneath the Surface

Although whales spend their lives in water, they breathe air through blowholes located on top of their heads. They must regularly return to the surface to breathe before diving again in search of food or traveling through the ocean.

Whales are warm-blooded, give birth to live young, and nurse their calves with milk. A thick layer of fat called blubber helps protect them from cold water and stores energy during long migrations.

Two Main Groups

Whales are generally divided into baleen whales and toothed whales. Baleen whales filter small animals from the water using flexible plates inside their mouths. This group includes blue whales, humpback whales, and gray whales.

Toothed whales use teeth to catch fish, squid, and other prey. Many of them also use echolocation, producing sounds and listening for returning echoes to understand their surroundings. Sperm whales, belugas, and orcas belong to this group.

The Blue Whale

The blue whale is the largest known animal to have ever lived. An adult can grow longer than a city bus and weigh well over one hundred tonnes. Despite its enormous size, it feeds mainly on tiny crustaceans called krill.

Communication and Migration

Whales communicate using clicks, whistles, pulses, and complex songs. Some sounds can travel across great distances underwater. Humpback whales are especially famous for their long, patterned songs.

Many species migrate thousands of kilometres each year. They often feed in cold, nutrient-rich waters before traveling to warmer regions where they mate and give birth.

Protecting Whales

Commercial hunting once caused severe declines in many whale populations. Today, whales also face threats from fishing gear, ship collisions, underwater noise, pollution, and changes to ocean ecosystems.

Conservation programs, safer fishing practices, protected habitats, and international cooperation can help whale populations recover. Protecting whales also supports healthier oceans because these animals play an important role in marine food webs and nutrient cycles.

F-Stack 2.0 前瞻 4 : F-Stack ff_rss_check 优化实践 2 – 从静态端口表到 rte_thash 反算,多队列客户端选源端口的三层加速

1. 本功能主要作用和特点

F-Stack 在多队列/多进程(share-nothing)部署下,进程作为客户端主动发起 TCP/UDP 连接时,必须选出一个”聪明”的本地源端口——让该连接的回包(SYN-ACK、响应数据)经网卡 RSS 哈希后落回发起连接的这个进程的接收队列。选错队列的后果是连接建立不起来或数据”串门”到别的进程,这在多进程架构下是致命的。这个选端口的活就是 ff_rss_check(lib/ff_dpdk_if.c)干的。

选端口有两个约束:既要保证回包落本队列(RSS 亲和),又要保证端口没被占用(四元组唯一)。原始实现是逐端口软算 Toeplitz hash 扫描,平均每次建连要几百个 tsc、且在高进程数下可能反复重试几十次,成为短连接场景的建连瓶颈。

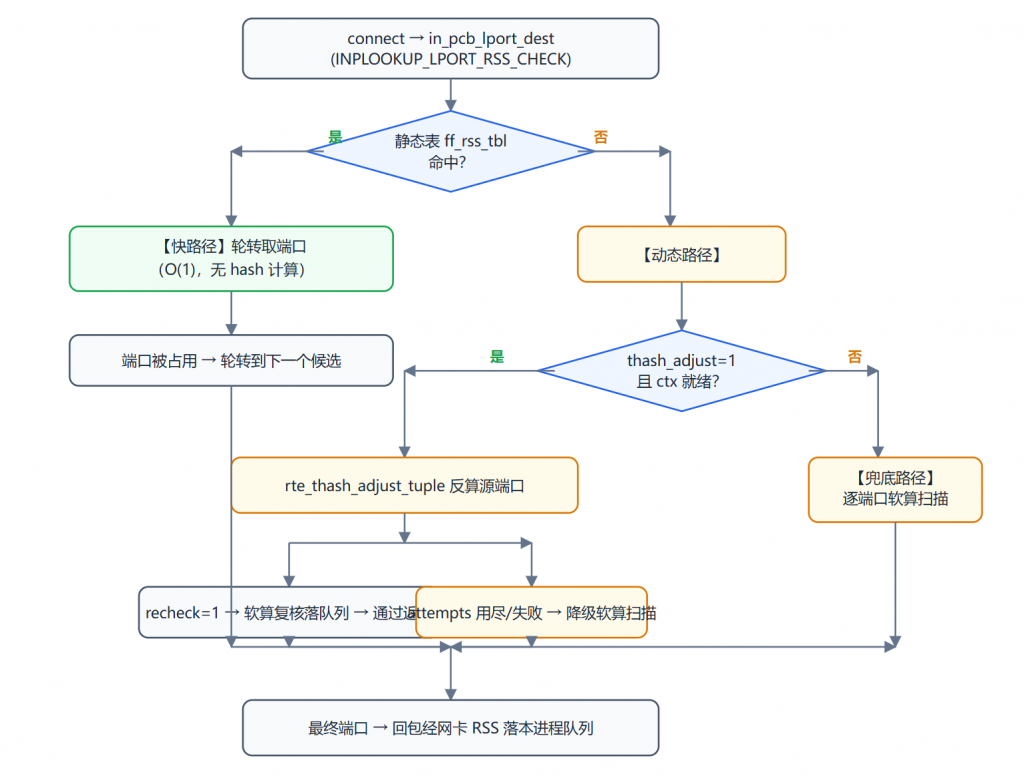
本功能围绕这条选端口路径做了三层优化:

  • 静态表快路径(上游 F-Stack 官方已有,commit e54aa4317,随 13.0→15.0 升级一度丢失后回迁):预先算好”对某个远端四元组,哪些本地端口落本队列”,建连时直接查表轮转取端口,省掉逐端口软算。
  • rte_thash 反算路径(本仓库超越上游的新增):静态表未命中时,用 DPDK 的 rte_thash_adjust_tuple() 按目标队列直接反算出满足约束的源端口,替代逐端口软扫描

【注意】thash反算可选端口范围受限(因为只是改动部分bit位),所以并发连接很大,所需端口很多时需要斟酌使用。

  • IPv6 全链路(上游也没有,全新增):把上面两条路径,以及最早的 ff_rss_check 完整扩展到 IPv6(16+16+2+2 的 36 字节 tuple)

另外还有两处配套:反算后的二次软算复核做成运行时开关(默认关,性能优先)、bind(addr,0) 后 connect 的端口延迟分配(对齐 Linux 的 IP_BIND_ADDRESS_NO_PORT 语义 + RSS 亲和)。

这套东西就一个特点:热路径分层降级、每层独立可用、错队列零容忍。静态表命中走最快路径,未命中走 thash 反算,反算失败回退软算扫描(端口都被占用不会回退),任何一层都保证最终选出的端口经独立软算确认落本队列(或按开关明示接受轻微分发不均)。

2. 本功能的主要适用场景

2.1 多进程/多队列部署下的客户端短连接

这是最典型的场景。F-Stack 经典部署是 1 primary + N secondary 共享网卡队列,每个进程只收自己队列的报文。进程做客户端(比如 nginx 反向代理连上游、网关主动探测)时,如果选出的源端口哈希不到自己的队列,回包就落错进程。连接越短、建连越频繁,选端口的开销占比越大,本功能收益越明显。

2.2 反向代理 / 网关类高频建连

nginx_fstack 反代场景:客户端用长连接打进来,nginx 作为客户端用短连接连上游。每一条上游连接都要走一次选端口,静态表对这种”远端地址相对固定”的场景命中率极高(上游规则里配好常用的 upstream 即可)。

2.3 需要精确控制回包落核的多队列应用

任何关心”回包落本核”的应用都适用——不只是性能问题,多进程架构下回包落错队列意味着功能不可用。

2.4 不太适合的场景

  • 纯服务端 listen + accept 的应用(选端口只发生在主动 connect,纯监听不触发),用不到本功能
  • 远端地址完全随机、无法预先配置静态表、且并发连接特别高的场景(静态表不命中,退化为 thash 反算(可选端口范围受限严重,斟酌使用)/软算,功能正确但收益打折)
  • 单队列部署(只有一个队列,选什么端口都”落本队列”,走的是零开销的短路路径)

3. 本功能的架构特征

3.1 选端口三层决策路径

一条 connect 进来,内核侧 in_pcb_lport_dest(freebsd/netinet/in_pcb.c)按下面的顺序选择源端口:

三层路径逐层降级、各自独立:静态表是纯查表(最快),thash 反算是数学反解(次快,单候选百 ns 级),软算扫描是全量 Toeplitz 计算(最慢但永远正确)。任何一层失败都不影响正确性,只是慢一点。

3.2 反算的核心:按”回包字段序”定位源端口

这里有个非常反直觉的设计点,是整个 thash 反算正确性的基石。

Toeplitz hash 是非对称的:hash(src, dst, sport, dport) ≠ hash(dst, src, dport, sport)。出向包(本地→远端)和回包(远端→本地)经网卡 RSS 落不同队列。我们反算源端口的目的是让回包落本队列,所以必须按回包的字段序构造 tuple:

出向包:srcIP=local  dstIP=remote  srcPort=local  dstPort=80
回 包:srcIP=remote dstIP=local   srcPort=80     dstPort=local ← 本地端口在 dstPort 字段!

因此反算的 helper 要加在回包 tuple 的 dstPort 字段位上:IPv4 tuple 12 字节,本地端口在 byte10 = bit80(不是出向包的 sport 字段 byte8 = bit64);IPv6 tuple 36 字节,本地端口在 byte34 = bit272(不是 bit256)。代码里 FF_RSS_THASH_V4_SPORT_OFF=80、FF_RSS_THASH_V6_SPORT_OFF=272(lib/ff_dpdk_if.c:176/187),注释里明确写了这个”回包 dstPort 字段”的理由。

【注1】这个设计不是一开始就对的。最早的实现按出向包 sport 字段反算(v4 offset=64),结果 listen 成功但连接不通——出向包落对了、回包落错了。修正成 dstPort 字段后才端到端打通。详见 4.5。

3.3 三方 key 对齐架构

thash 反算要成立,有个前置条件:反算用的 RSS key、软算复核用的 key、网卡实际用的 key 三者必须完全一致。架构上做了两件事保证:

  • ff_rss_thash_build_key(port_id, reta_size)(lib/ff_dpdk_if.c:3459)在 dev_configure 之前串行构造 v4→v6 的 thash ctx,并把构造产出的统一 key(KEY_FINAL)发布到全局 rsskey,由调用方在 dev_configure 时编程进网卡——三方从此共用同一把 key
  • secondary 进程走 rte_thash_find_existing 复用 primary 已建的同名 ctx,不再各自独立初始化(这也顺带解决了多进程下 ctx 重复初始化的 EEXIST 报错)

4. 具体做了哪些改造、遇到了哪些问题

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 起点:上游的静态表优化(e54aa4317)

这套机制的源头是 F-Stack 官方的一次优化(commit e54aa4317,官方 wiki 有介绍,公众号文章 https://mp.weixin.qq.com/s/x5wWecqEKWGdcVbhne78tw)。核心思路就是空间换时间:启动时按配置的 (本地地址, 远端地址, 远端端口) 规则,把”哪些本地端口会哈希到本队列”预先算好存进 ff_rss_tbl,建连时查表轮转取端口,把”动态计算”变成”静态查找”。官方实测:常规场景 QPS 提升约 2~6%,特殊场景(8/16 进程)提升可达 36.94% / 38.79%——某些进程数配置下原始实现的随机选端口次数远超数学期望(8 进程时实测要试 46~60 次,理论期望 8~12 次),查表直接把这部分开销干掉了。

4.2 问题一:13.0→15.0 升级把内核侧钩子丢了(R-A 回迁)

升级 FreeBSD 13.0 → 15.0 时,用户态接口(ff_rss_check、ff_rss_tbl_init/set/get_portrange 等)都完整保留了,但内核侧消费这些接口的 #ifdef FSTACK 钩子没有移植——15.0 的 in_pcb.c 里 INPLOOKUP_LPORT_RSS_CHECK 宏只剩一个没人用的 #define,整个 RSS 选端口机制在内核侧完全失效,退回原生随机选端口。

修复(commit 22462f58d):按 15.0 的代码结构重新回迁。15.0 相对 13.0 有三个适配点:in_pcb_lport_dest 形参变成了 const struct inpcb *(RSS 逻辑只动局部变量);in_pcbconnect_setup 被合并进 in_pcbconnect(ff_in_pcbladdr 的对接点跟着挪);lookup 系列调用统一多了 RT_ALL_FIBS 入参。回迁后真机实测:primary/secondary 各 connect 200 次,200/200 全部落本队列。

4.3 改造二:thash 反算替代逐端口扫描(R-B)

静态表命中是快路径,但未命中时仍要逐端口软算。用 DPDK 24.11.6 的 rte_thash_adjust_tuple() 反算可以把这个 O(端口数) 的扫描变成直接反解。关键是把”落本队列”精确翻译成反算的 desired_value:本仓库落队列判定是 ((hash & (R-1)) % Q) == queueid,所以 desired = queueid + (rand % ceil(R/Q)) * Q,让反算出的 hash 低位精确落进目标队列的集合。反算成功后再用软算 ff_rss_check 复核一遍(可选,用于DEBUG,默认关闭提升性能)。adjust_sport 内 attempts 用尽(如端口都被占用,因为反算端口范围有限)则返回 -1,由内核侧 in_pcb_lport_dest 的 do-while 全端口扫描 + ff_rss_check 软算兜底。

4.4 改造三:IPv6 全链路(R-C)

上游的静态表是 IPv4-only。按方案 A 全新增 v6 独立符号(ff_rss_check6、ff_rss_tbl6_*、ff_rss_adjust_sport6),不动 v4 任何结构和签名。内核侧在统一的 in_pcb_lport_dest 里加 AF_INET6 并行分支、in6_pcbladdr 对接。IPv4 零回归的证据是硬邦邦的:R-C 相对 R-B 的 git diff 里 in_pcb.c 是 +86/-0,纯新增无一行 v4 删除。

4.5 问题二:Toeplitz 非对称——反算要按回包字段序(c42340d5 / R-G)

thash 反算落地后,物理机上出现诡异现象:listen 成功但连接不通,IPv4 正常、IPv6 不行(后来确认是两版都有这个坑,先修的 v4 后对称修 v6)。根因就是 3.2 讲的 Toeplitz 非对称:最初按出向包的 sport 字段位反算(v4 offset=64、v6 offset=256),结果出向包落对了队列、回包 SYN-ACK 落错队列,握手当然完不成。

修复(IPv4 commit c42340d5,IPv6 对称移植 R-G):把 helper offset 改到回包 dstPort 字段位——v4 64→80、v6 256→272,tuple 按回包字段序填充,复核也按回包字段序调 ff_rss_check。修复后物理机端到端验证:v6 多队列主动 connect 的回包 100% 落本进程队列、0 落错,IPv4 零回归。

4.6 问题三:add_helper 改写 key 导致三方 key 不一致(R-F)

修复 offset 后单测里发现一个更隐蔽的问题:thash 反算的”单候选等价率”只有 ~22-27%(意味着反算出的端口大概率过不了软算复核,得重试 3~6 次)。排查到最后发现根因是 rte_thash_add_helper 会用 LFSR 原地改写 ctx->hash_key——于是 rte_thash_adjust_tuple 用改写后的 key 反算,而 ff_rss_check 软算和网卡硬件用的是原始 key,三方 key 不一致,那 22-27% 纯属巧合命中。

修复:ff_rss_thash_build_key 在 dev_configure 前串行构造 ctx、发布统一 KEY_FINAL 到全局 rsskey 并编程进网卡,三方对齐后等价率应达 ~100%。

4.7 改造四:recheck 复核默认关闭(R-D)

三方 key 对齐后,反算结果的可信度上来了,那道”反算成功后强制软算复核”的保险丝就成了纯开销——microbench 实测单次 ff_rss_check 复核约 99.4 ns/call,而 recheck=0 的热路径只要 ~0.31 ns/call,差了约 300 倍;换算到每连接(平均 3.9 次 adjust 调用)约省 390 ns,v6 reta=512 长尾场景每连接能省约 2 us。

于是把复核做成运行时开关 recheck(config.ini [rss_check] 段),默认 0(性能优先),debug/运维时开 1 维持零容忍硬门。失败兜底链(attempts 用尽 → 软算扫描)不受影响。

4.8 改造五:bind-then-connect 端口延迟分配(R-E)

还有一个漏网路径:应用先 bind(local_addr, 0) 再 connect(remote)。原生 FreeBSD 在 bind 阶段就分配了匿名端口,connect 时发现”端口已经有了”就绕过了 RSS 选端口逻辑,选出的端口不落本队列。这正好对齐 Linux IP_BIND_ADDRESS_NO_PORT 的语义——端口推迟到 connect 按完整四元组分配。

修复(commit ff9e3c449,+16/-1,全宏门控):v4 的 in_pcbbind 入 hash 块加 lport != 0 门控、in_pcbbind_setup 的端口分配加 #ifndef FSTACK 门控;v6 对称改造。bind 阶段不固化端口 → connect 天然进 RSS 选端口分支。另有一个有意思的坑:nginx 会先调 setsockopt(IP_BIND_ADDRESS_NO_PORT),这个选项的 Linux 数值 24 恰好撞上 FreeBSD 的 IP_BINDANY=24——v4 被静默误设成透明代理、v6 直接 EINVAL。在 syscall 转换层拦截(commit a2537e143)后彻底解决。

4.9 测试与验证情况

  • 单测:39 run / 36 PASSED / 3 SKIPPED(3 个 SKIPPED 是 DPDK EAL 在单测环境无法 init 的既有降级),v4/v6 full-loop 落队列 100% 硬断言全过
  • 真机(R-A 软算路径):primary/secondary 各 200 connect,200/200 落本队列
  • 物理机(v6 reverse-path):具备真实 v6 RSS 能力的网卡上端到端通过,0 落错
  • 本机 virtio reta_size=0:thash ctx 无法初始化,真机上走的是软算降级路径(这恰好验证了降级链的正确性),thash 路径的正确性由单测 reta=128/512 全量覆盖

5. 如何使用、如何配置、使用效果

5.1 配置

config.ini 的 [rss_check] 段(示例):

[rss_check]
# 总开关:1=启用静态 RSS 表选端口,0=关闭(默认)
enable=1
# debug 开关:1=thash反算成功后强制软算复核(默认 0,性能优先)
recheck=0
# thash 反算开关(与静态 RSS 表的 enable 解耦):1=多队列下启用反算(默认),0=只走软算扫描
thash_adjust=1
# 静态表规则:<网卡端口ID> <本地地址> <远端地址> <远端端口>,多条用分号分隔
rss_tbl=0 192.168.1.1 192.168.2.1 80;0 192.168.1.1 192.168.2.1 443

静态表规则建议配好常用的 upstream(远端地址+端口),命中率越高收益越大;同一 saddr/sport 二元组最多 16 个、同组最多 4 个 daddr,超出的配置被忽略。

5.2 使用效果

静态表路径(官方实测,e54aa4317 时代数据):

lcores原始动态 QPS静态表 QPS提升
138,09338,456+0.95%
273,56675,009+1.96%
4139,205142,325+2.24%
6196,471202,068+2.85%
8201,823276,368+36.94%
12371,362394,151+6.14%
16398,376552,894+38.79%

常规场景 2~6%,8/16 进程这种”原始实现随机重试爆炸”的场景 35%+。

thash 反算路径(本仓库实测):

  • recheck=0 热路径 ~0.31 ns/call vs recheck=1 的 ~99.5 ns/call(microbench,约 300 倍差距)
  • 每连接省约 390 ns(v4)、v6 reta=512 长尾省约 2 us
  • full-loop 落队列 100%(单测硬断言),错队列零容忍在 recheck=1 下由软算复核守护

5.3 注意事项

  • 静态表与 thash 反算是”加速层”,最终正确性由软算兜底链保证,任何一层失败自动降级,不需要手动干预
  • 在不支持RSS的环境(如本机 virtio 网卡) reta_size=0,thash 反算在真机会自动降级为软算——这是设计行为不是 bug

6. 延伸阅读:

F-Stack 2.0 前瞻 3 : F-Stack 用户态栈与内核栈自动双栈共存 – 一个 listen 同时服务 DPDK 网卡和本机回环

1. 这功能解决什么问题

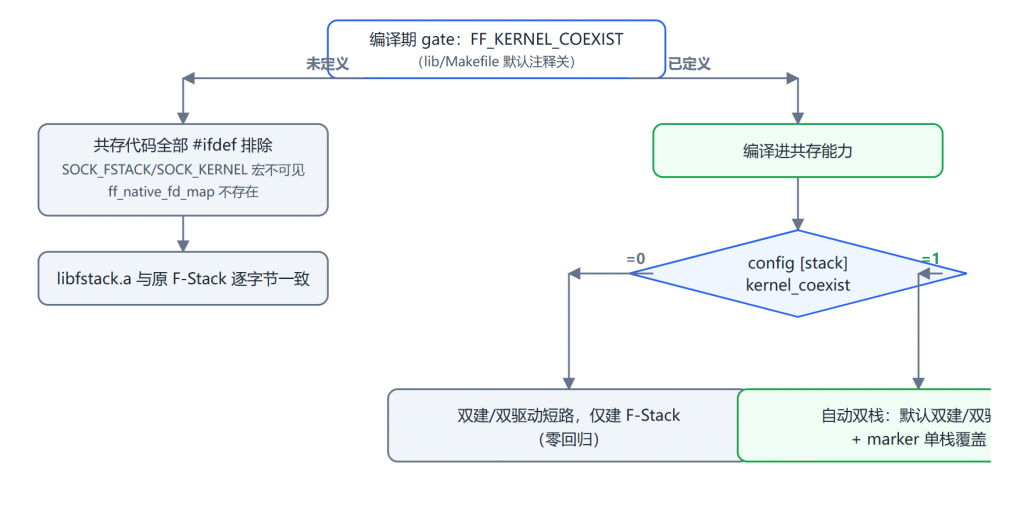
F-Stack v2.0(预计 2026.10 正式 release)引入的内核栈共存能力,解决 F-Stack 最经典的一个使用痛点——DPDK 接管网卡后,本机 curl 自己监听的服务会被内核报 Connection refused。

F-Stack 把网卡绑定给 DPDK 后,这张网卡上的流量完全绕过 Linux 内核协议栈,直接进 F-Stack 用户态 FreeBSD 栈。后果是:你在 F-Stack 里 listen 了 80 端口,从同网络另一台机器 curl 你的网卡 IP 能通,但在本机 curl 127.0.0.1 或 curl 本机 IP 会报 Connection refused——因为本机请求走的是 Linux 内核栈,而内核对 F-Stack 的这个 80 端口一无所知。

这个现象在 issue 里被反复问,官方给的标准答案一直是”从别的机器测”或者”用 KNI 回灌”。issue #511/#585/#741/#849 全是同一件事。

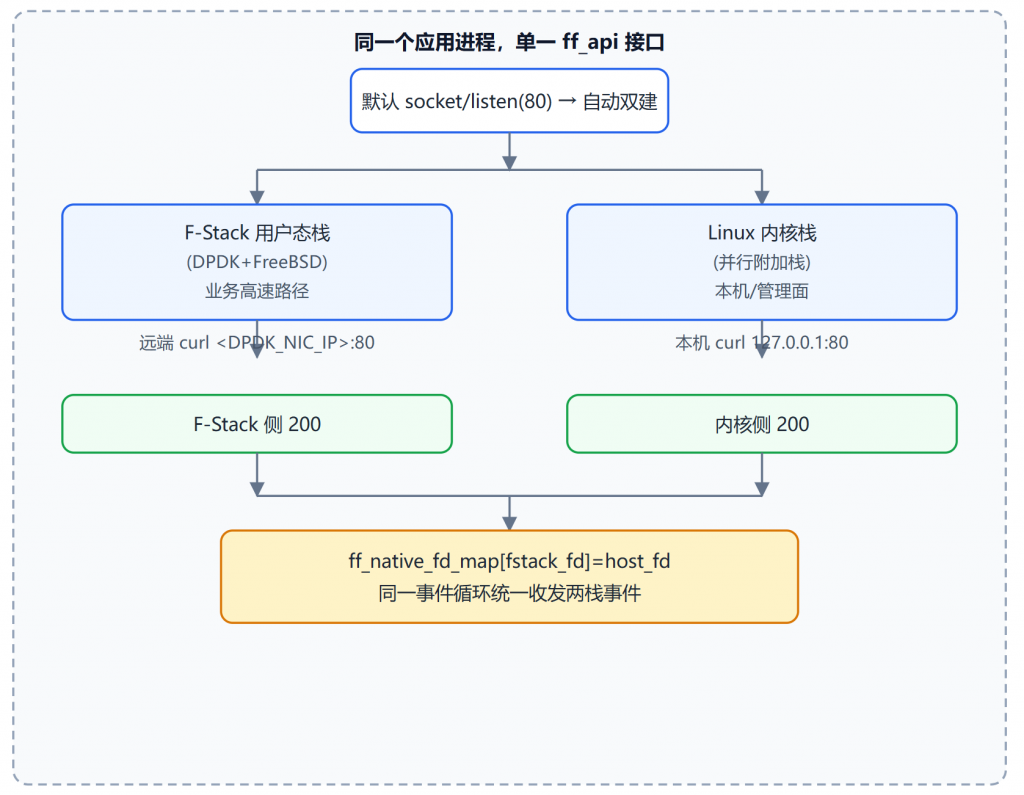
我们做的就是把这件事从”手动 workaround”变成”默认行为”:同一个 socket、同一个 listen(80),同时跑在 F-Stack 用户态栈(DPDK 网卡,业务高速路径)和 Linux 内核栈(本机回环/管理面)上。远端 curl 网卡 IP 走 F-Stack,本机 curl 127.0.0.1 走内核,两条路同时通,而且两栈的事件在同一个 epoll/kqueue 事件循环里统一处理。

【注意】F-Stack 用户态栈始终在位、始终承担业务高速路径,内核栈只是”并行附加”的第二条栈,用来承接本机/管理面/客户端访问,绝不是在旁路或替代 F-Stack。

这里先说清楚它不是什么,免得理解偏差:

  • 不是把 socket 旁路到内核(早期有个错误实现就是这么干的,后文 4.1 详述,已回退)
  • 不是”整进程默认走内核栈”(那是反 F-Stack 的,明确不做)
  • 不是 KNI 报文回灌(那是另一套独立机制,跟本功能无关)
  • 不是连接迁移/透明代理(一个 TCP 连接物理上只存在于收到 SYN 的那一栈,无法”双栈”)

2. 主要适用场景

2.1 本机直访自己监听的服务

这是最直接的场景。开发和运维时,你总想在本机 curl 一下自己刚起的服务确认存活,而不是每次都要开另一台机器。开了双栈后,本机 curl 127.0.0.1:80 直接通。

2.2 服务端双向可达

同一个 listen(80):远端经 DPDK 网卡访问 <DPDK_NIC_IP>:80 走 F-Stack 高速路径,本机经 127.0.0.1:80 走内核栈,一个 socket 两用,不用为内核侧额外开一个 SOCK_KERNEL socket,也不用写任何 marker。

2.3 客户端连内核服务

作为客户端要连本机或外部的内核服务(比如本机的某个守护进程、管理面 API),用双栈 connect 或纯内核的 SOCK_KERNEL 都能做到,不用绕道。

2.4 需要内核可见性的监控场景

F-Stack 监听端口在 Linux 的 ss/netstat 里是看不到的(那是用户态栈)。开了双栈后,ss 能看到内核侧的 80 监听,监控和健康检查都方便了。issue #593/#594 里官方也拿 kernel_coexist 当”让端口内核可见”的答案。

2.5 不太适合的场景

  • 需要真·双工于两栈的单条连接(一条 fd 上的数据要么走 F-Stack 要么走内核,不可能同时两栈都收发)——默认双栈 connect 只是”两栈各建一条、F-Stack 主”,纯内核客户端请用 SOCK_KERNEL
  • 用 select/poll 做多路复用的场景(后文 4.6 详述,内核 fd 装不进 fd_set,不共存)
  • 想省掉 F-Stack 只留内核的场景(本功能不提供”整进程默认内核”,那是旁路)

3. 架构特征

3.1 一个 listen 双栈服务

3.2 fd 三态路由

这是整个功能的核心模型。一个 fd 进来,按数值区间和映射表分成三种形态:

三类 fd 空间互不冲突:F-Stack fd < 65536,内核 encode fd ≥ 0x40000000,host fd 受 RLIMIT_NOFILE。

【注意】关键设计是”热路径不查 map”。accept 出来的连接 fd 一定是单栈的——F-Stack 侧连接返回原始 fd,内核侧连接返回 encode fd。之后 recv/send 只做一次 ff_is_kernel_fd 判断就路由了,不查映射表,数据热路径零额外开销。双建/双驱动只发生在 socket/bind/listen/close 这些一次性操作上。

3.3 双层开关保证零回归

三重零回归保证:编译宏关、运行期开关关、SOCK_FSTACK marker,三者任一满足就退化成纯 F-Stack。

4. 改造工作与遇到的问题

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 走过的弯路:v3 纯内核旁路(已回退)

这个功能不是一步到位的,中间踩过一个方向性的大坑。

最早一版(v3,commit 0748eff94)把 ff_socket(SOCK_KERNEL) 直接接到纯宿主的 socket(),完全绕开 F-Stack。看似解决了”本机能通”,但这是根本性错误——它旁路了 F-Stack,违背了”F-Stack 始终在位”的铁律。性能基线报告也坐实了这个问题:v3 测的 A/B 两版本都是纯内核,根本没测”共存”。

回退后重新按正确范式做:应用跑在 F-Stack 上,per-fd 用 SOCK_KERNEL 附加走内核栈,两者同进程共存。

【注3】这个弯路值得记住:共存不是”要么 F-Stack 要么内核”的二选一,而是”F-Stack 为主、内核并行附加”。一旦做成旁路,性能基线、稳定性评估全都会失真。

4.2 v5:编译宏门控 + per-fd 二选一

回退后第一版正确实现是 v5(commit ba148589d),做了两件事:

  • 用编译宏 FF_KERNEL_COEXIST 把全部共存代码包裹起来,lib/Makefile 默认关,保证宏关时 libfstack.a 与原 F-Stack 逐字节一致(nm 比对共存符号为 0)
  • per-fd 二选一语义:带 SOCK_KERNEL 建内核 fd(编码成 ≥0x40000000 的高位 fd),否则走 F-Stack 原路径

这一版已经实测可用,但语义是”每个 fd 自己二选一”。想本机也通,得额外写一个 SOCK_KERNEL 的 socket,麻烦。

4.3 v6:默认升级为自动双栈

v6(commit 13b418191)把默认语义从”二选一”升级为”自动双栈”:

  • 默认(无 marker)的 ff_socket 同时建 F-Stack fd + 内核 host fd,登记 ff_native_fd_map[fstack_fd]=host_fd,返回 F-Stack 原始 fd
  • ff_bind/ff_listen/ff_close 对该双栈 fd 同时驱动两栈
  • marker 变成”单栈覆盖”:SOCK_KERNEL 仅内核、SOCK_FSTACK 仅 F-Stack

核心新增是那张 65536 项的无锁映射表 ff_native_fd_map(仿 adapter 的 fstack_kernel_fd_map),以及 accept 的”单栈归属”——双栈 listen fd accept 返回单栈连接 fd,F-Stack 侧连接返回原始 fd、内核侧连接返回 encode fd。

4.4 踩到的坑:头改动没 clean 重编导致 ABI 偏斜

性能基线实测时踩了个构建卫生的坑:给 struct ff_config 的 stack 子结构加了 int kernel_coexist 字段后,改变了它后面 log 子结构(含 log.f)的偏移。而 lib 的 Makefile 不跟踪头依赖,增量构建残留了混用新旧 ff_config.h 布局的 .o——ff_log.o 用旧偏移读 log.f,读到了新布局里别的非零字段,fclose 直接段错误。

修复很简单:清掉全部 .o 和 libfstack.a 全量重编。但这暴露了一个规律——对 ff_config.h 这类结构头的改动,必须 clean 后全量重编 lib,增量编译会掩盖 ABI 偏斜。

4.5 踩到的坑:kqueue 模型应用感知不到内核侧事件

R7 落地后自动双栈对 ff_epoll_* 是完整的,但直接用 ff_kqueue/ff_kevent 的应用(比如 example/main.c 用的就是 kqueue 模型)感知不到内核侧连接。实测:内核 TCP 完成了握手、GET 进了内核缓冲并被 ACK(抓包 ack 73 吻合),但应用永不被唤醒去 accept 内核 listen fd,本机 curl 127.0.0.1:80 返回 http_code 000(6 秒超时)。

根因:ff_kqueue/ff_kevent 完全没有 FF_KERNEL_COEXIST 路由,只把 F-Stack listen fd 注册进 F-Stack kqueue,双栈 listen 的内核侧 host fd 从未进入任何事件后端。

修复(R9,commit 03f244ac1):对称仿 ff_epoll 做 kqueue 共存——ff_kevent 的 changelist 里,ident 为内核 fd 或双栈 fd 的 EV_ADD/EV_DELETE 映射到 host epoll_ctl(EVFILT_READ↔EPOLLIN、EVFILT_WRITE↔EPOLLOUT),eventlist 先取内核就绪再合并 F-Stack 就绪。

4.6 踩到的坑:IPv6 双建端口冲突

还是 R9 发现的。开了 -DINET6 后,默认 ff_socket(AF_INET6) 双建,host 侧 IPv6 socket 绑 [::]:80 时,因为本机 net.ipv6.bindv6only=0,[::] 连带占用了 IPv4,跟同进程 host 侧的 0.0.0.0:80 冲突,实测 errno=98 EADDRINUSE,进程直接起不来。

修复:给 host 侧 IPv6 socket 设 IPV6_V6ONLY=1,让它只处理 IPv6、跟 host IPv4 同端口共存。

4.7 收口:补齐剩余接口的内核路由

R8(commit 55a84f313)补齐了 sendmsg/recvmsg/getpeername/getsockname/shutdown 的内核 fd 路由;R10(commit c6f5918b8 + 2422d12eb)又补齐了 readv/writev/ioctl/dup/dup2。其中有几个值得说的点:

  • ioctl 的 request 编码在 Linux 和 FreeBSD 不同源,内核 host fd 必须用原始 Linux request 直传 host libc,不能经 linux2freebsd_ioctl 翻译
  • dup2 一端内核 fd 一端 F-Stack fd 的”混栈”语义不成立,明确拒绝 errno=EINVAL,不臆造
  • select 不共存:encode 内核 fd(≥0x40000000)远超 fd_set 的 FD_SETSIZE(1024),装不进去,硬限制
  • poll 也不共存:合并复杂度高、回归风险大,保守降级为文档限制

内核 fd 想多路复用,用 ff_epoll_* 或 ff_kqueue 就行。

4.8 性能无回归

这是最关心的点,实测数据(v6 双栈口径,真机 wrk):

档位共存关 A0双栈开 A1Δ
T1 (-t2 -c10)28,21627,729−1.73%
T2 (-t4 -c100)202,805206,219+1.68%
T3 (-t8 -c500)120,702127,784+5.87%

吞吐差异全落在 trial 噪声内,p99 基本相等。逻辑上也说得通——双建成本只在 listen socket 建立时一次性付出,keep-alive 连接的数据热路径单栈、不查 map,所以 F-Stack 业务快路径无可测量回归。

5. 如何使用、配置与效果

5.1 编译

默认编译不含共存代码,要开启得编译时加宏:

cd f-stack/lib && make clean && make FF_KERNEL_COEXIST=1 -j$(nproc)

应用侧如果想用 marker(SOCK_KERNEL/SOCK_FSTACK),编译应用时也要加 -DFF_KERNEL_COEXIST(否则这两个宏不可见)。只用默认双栈则不需要。

5.2 配置

config.ini 的 [stack] 段加 kernel_coexist:

[stack]
# 0=禁用(纯 F-Stack),1=启用(默认 socket 自动双栈)
kernel_coexist = 1

注意:这个运行期开关只在编译宏开了 FF_KERNEL_COEXIST 时才生效。编译宏关,或者这里设 0,都是纯 F-Stack,零回归。

5.3 用法

默认双栈(什么都不用加):

int s = ff_socket(AF_INET, SOCK_STREAM, 0);   /* 双栈:F-Stack fd + 内核 host fd */
ff_bind(s, &addr80, sizeof(addr80));           /* 双驱动:两栈各 bind 80 */
ff_listen(s, backlog);                          /* 双驱动:两栈各 listen */
ff_epoll_ctl(ep, EPOLL_CTL_ADD, s, &ev);        /* 双注册:kqueue + 内核 epoll */
​
/* 远端 curl <DPDK_NIC_IP>:80 走 F-Stack,本机 curl 127.0.0.1:80 走内核,皆可达 */

需要单栈时用 marker 覆盖:

int konly = ff_socket(AF_INET, SOCK_STREAM | SOCK_KERNEL, 0);  /* 仅内核 */
int fonly = ff_socket(AF_INET, SOCK_STREAM | SOCK_FSTACK, 0);  /* 仅 F-Stack */

5.4 效果

功能正确性(真机实测,commit 13b418191):

  • 单 listen(80):本机 curl 127.0.0.1:80 = 200(内核侧),远端 ssh → <DPDK_NIC_IP>:80 = 200(F-Stack 侧)
  • ss 能看到内核侧 80 监听,ff_netstat 能看到 F-Stack 侧 80 监听

零回归(三层保证):

  • 编译宏关:libfstack.a 共存符号为 0,与原 F-Stack 逐字节一致
  • kernel_coexist=0:双建/双驱动运行期短路
  • SOCK_FSTACK marker:仅 F-Stack

性能(第 4.8 节):T1/T2/T3 三档吞吐差异全在噪声内,热路径不查 map。

5.5 已知限制

  • select 不支持内核 fd(encode fd 装不进 fd_set),poll 也不共存——内核 fd 用 epoll/kqueue
  • 单条连接不能真双工于两栈——默认双栈 connect 是”F-Stack 主 + 内核并发建连备援”,纯内核客户端用 SOCK_KERNEL
  • 可观测统计(ff_stack_get_stats)当前未实现,两栈 fd 数/事件数看不了
  • IPv6 依赖 host 侧 V6ONLY,本机 bindv6only 相关行为已在 R9 处理

6. 延伸阅读

  • 完整 spec:docs/kernel_event_support_spec/zh_cn/(00-10 + plan-r9/plan-r10)
  • 三层架构:docs/zh_cn/F-Stack_Architecture_Layer1_System_Overview.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md(2A 节 FF_KERNEL_COEXIST delta)
  • 相关 issue:#511/#585/#741/#849(本机 curl connection refused 场景)

F-Stack 2.0 前瞻 2 : F-Stack 主进程瘦身 primary_slim – 把 primary 单点故障从紧急事故降级为计划内维护

1. 这功能解决什么问题

primary_slim 是 F-Stack v2.0(预计 2026.10 正式 release)引入的一个运行开关,解决 DPDK 多进程模式下 primary 进程是单点的问题。

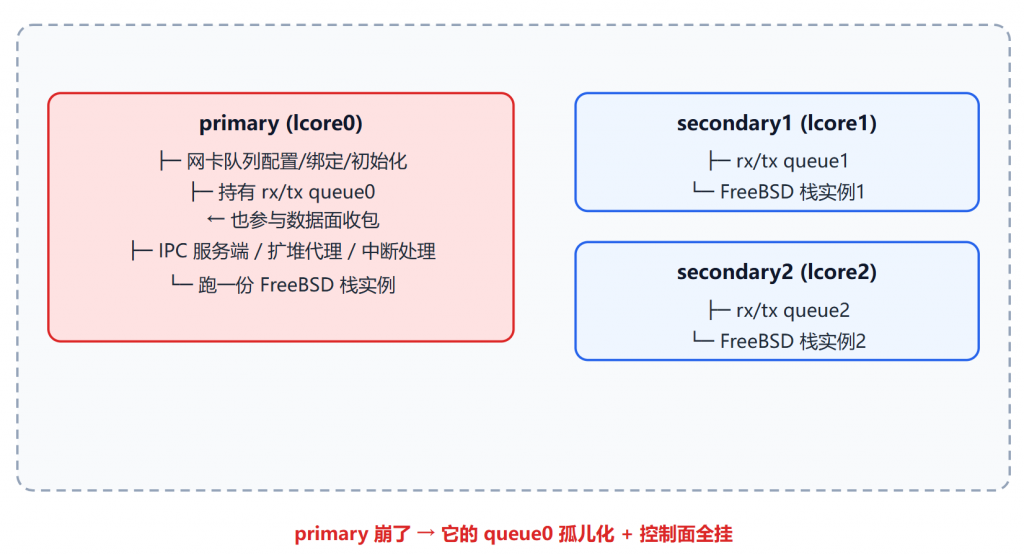
F-Stack 的标准多进程模式是 1 个 primary + N 个 secondary,每个进程独占一个 lcore 跑一份独立 FreeBSD 栈实例。secondary 崩了可以单独重启,不影响其他进程的队列和已建连接;但 primary 一旦异常退出,问题就大了——按照 DPDK 的设计,primary 是 IPC 唯一服务端、secondary 扩堆必须由 primary 代理、所有中断只在 primary 触发,所以传统认知是”primary 挂了整个进程组都得重启,所有连接受影响”。

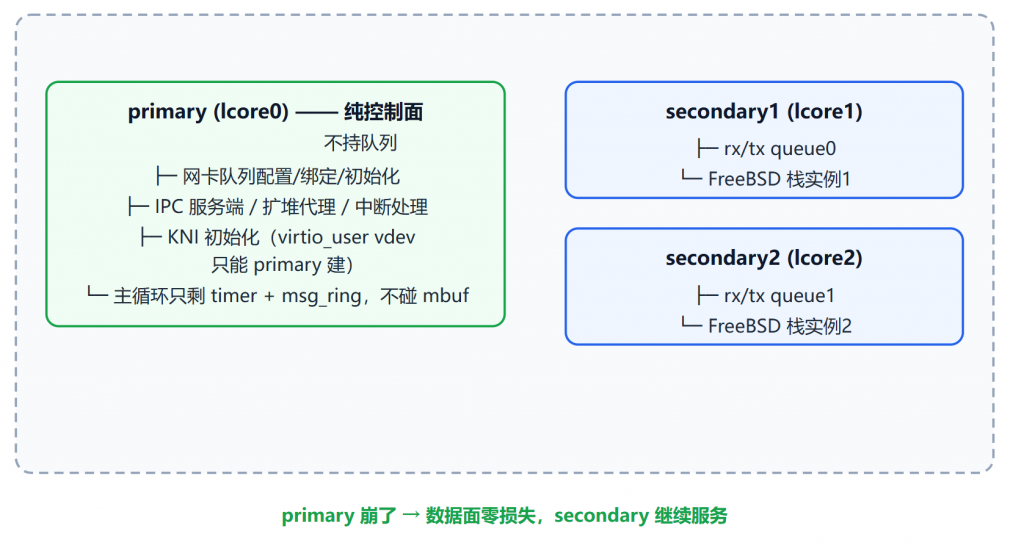
这个诉求来自上游 issue #1078(https://github.com/F-Stack/f-stack/issues/1078),作者提的想法很直接:把 primary 独立出来,只做网卡队列设置、绑定、初始化这类控制面工作,收包和后续处理全部下移 secondary,这样 primary 就不那么容易异常,对连接的影响范围也小。

primary_slim 干的就是这件事:

【注意】primary_slim 把”primary 崩溃 → 必须立刻全组重启 + 约 1/N 连接立即中断”变成”primary 崩溃 → 数据面零损失、业务继续跑、崩掉的 secondary 可原地重启、集群进入控制面降级态、在计划内维护窗口择机全组重启”。

说白了,是把紧急故障转化为计划内维护,重启时机从被动变成可控。

这里先说清楚它不做什么,免得期待过高:

  • 不承诺”完全无需重启”——控制面降级态无法就地修复,最终还是要择机全组重启
  • 不承诺”省一个 CPU 核”——瘦身后的 primary 仍会空转占满一核,除非开空闲休眠
  • 不承诺 primary 不再是结构性单点——只是降低异常概率、缩小影响面
  • 不承诺 secondary 崩溃时连接不丢——每进程独立 FreeBSD 栈,没有连接迁移这回事

2. 主要适用场景

2.1 对 primary 单点稳定性敏感的生产部署

如果你的业务在多进程模式下跑,primary 一旦挂了要拖累全组,primary_slim 能让 primary 退出时数据面零损失。实测数据(后文详述):杀掉瘦身 primary 后,已建连接 12/12 零中断(26 轮探测无一次失败),新建连接 12/12 正常。

2.2 需要控制面与数据面解耦、缩小故障爆炸半径

多进程模式里,primary 名下如果持有 rx/tx 队列,它崩了这些队列就变成没人 poll 的孤儿队列,落到上面的流量全部黑洞化。primary_slim 让 primary 不持任何队列,数据面能力全部留在 secondary,primary 退出不带走任何数据面能力。

【注意】因为使用virtio创建的tap的限制,kni依然由主进程处理,primary挂了后kni会失效。

2.3 已经有外部守护/编排,想要分层恢复能力的场景

配合外部守护,可以做到:secondary 崩了原地重启 → primary 崩了进入降级态告警 → 择机计划内全组重启。这比”primary 一挂就紧急全组重启”从容得多。

2.4 不太适合的场景

单进程多线程模式(thread_mode=1)下没有独立 primary 进程,这个特性语义不存在,所以 primary_slim 与 thread_mode 是互斥的,配置校验会拦掉。如果只有 1 个进程(nb_procs < 2),也没有瘦身的意义,同样会被校验拦截。

3. 架构特征

3.1 改造前后对比

改之前(标准多进程):

改之后(primary_slim=1):

3.2 为什么队列能自然收缩、不产生孤儿队列

这是整个方案成立的关键,也是调研阶段最反直觉的发现。一开始担心”把 primary 摘出 lcore_list 会导致队列数减 1、queueid 错位、RSS reta 错位”,逐行坐实后发现根本不成立:

  • nb_queues 来源是该 port 的 lcore_list 长度,不是 nb_procs(lib/ff_dpdk_if.c:836)
  • queueid 是本进程 lcore 在 lcore_list 里的下标,与 proc_id 完全解耦(lib/ff_dpdk_if.c:487-491)
  • set_rss_table() 按同一个 nb_queues 重算 reta

所以把 primary 摘出 lcore_list 后,队列数、queueid、RSS reta、dispatch_ring 一致收缩,孤儿队列在代码层面自然消失。这正好是维护者(本人)提示词设想的”复用 lcore_list”路线的根本依据。

3.3 KNI 场景下的数据通路(最复杂的情况)

primary_slim=1 且 KNI 开启时,数据通路是三条线,涉及一个关键竞态修复(后文 4.3 详述)。最终稳定形态:

ICMP 请求入站:
client → 物理网卡(Port0) → secondary rx_burst(q0)
  → ff_kni_enqueue → KNI ring
  → primary kni_process_tx → rte_eth_tx_burst(Port1=virtio_user0)
  → veth0(tap) → kernel 协议栈 → 生成 ICMP reply
​
ICMP 回复出站(inject ring 路径):
kernel → veth0 → virtio_user0
  → primary kni_process_rx → enqueue 到 kni_inject_rp ring
  → owner secondary 用自己的 tx_queue 发出
  → 物理网卡 → client

核心分工:secondary 负责数据面收包入队 KNI ring,primary 独占 virtio_user vdev 的 TX/RX(因为 vdev 只有 primary 能合法操作),KNI 收到的回复包经 kni_inject_rp ring 转发给 owner secondary 用自己的队列发出。这样既绕开了”secondary 不能操作 virtio_user vdev”的 DPDK 硬约束,又消除了跨进程共享 TX queue 的竞态。

4. 改造工作与遇到的问题

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 PoC 阶段:3 行代码验证核心命题

正式立项前先做了个最小 PoC,只改 3 行代码(_poc_primary_slim.patch,2 hunk):

  • lib/ff_dpdk_if.c:508-510:rte_exit 条件追加 && rte_eal_process_type() != RTE_PROC_PRIMARY,解除 B1 阻塞点(”lcore %u has nothing to do”)
  • lib/ff_dpdk_if.c:535:mbuf 池 RX 项去掉对本进程队列数的依赖,解除 B3 阻塞点(池规模归零)

配置是 lcore_mask=3 + [port0] lcore_list=1(primary 的 lcore0 不在列表内)。

3 行代码 + 1 项配置就验证了核心命题:瘦身 primary 崩溃后已建连接 12/12 零中断、新建连接 12/12、性能无回归。这也直接说明了为什么这个改动值得做——代价极小,收益是质变。

【注意】PoC 用 rte_eal_process_type() != RTE_PROC_PRIMARY 无条件放宽只是为了最小化 diff,正式实现改成了 primary_slim && RTE_PROC_PRIMARY 有条件门控,避免影响默认路径。

4.2 正式实现:从”自动推导”到”显式开关 + 校验链”

PoC 能用但不严谨(靠”自动推导”而非显式开关),正式实现补了完整的开关和校验链。核心提交是 1c28aaa2d(M1)+ f7961b083(M2~M4)。

交付的东西:

  • [dpdk] primary_slim=0/1 显式开关,默认 0,关闭时零回归
  • 开启后 primary 在 init_lcore_conf 里 early return,不分配 rx/tx 队列,不进收发包主循环
  • 配套 primary_slim_idle_sleep(默认 1000us)解决 CPU 空转
  • 三道校验:primary lcore 不得在 lcore_list(V2)、与 thread_mode 互斥(V4)、nb_procs >= 2(V5)
  • ff_is_slim_primary() API

4.3 踩到的坑:CPU 空转

这是实测发现的第一个负面问题。瘦身后的 primary 不持队列、不收包,但 ps -o pid,pcpu 一看还是 99.8% 占满一核。原因是 main_loop 仍在紧密空转(跑 timer 和 msg_ring 处理),而 config.ini 的 idle_sleep=0 意味着无空闲休眠。

【注意】primary_slim 的收益是稳定性,不包含 CPU 节省。如果用户期望”瘦身 = 省一个核”,这个预期必须纠正。正式实现引入了 primary_slim_idle_sleep(默认 1000us),否则在核数紧张的部署里就是白烧一个核。

4.4 踩到的坑:KNI 场景下的跨进程 TX 队列竞态

这是 post-implementation 阶段发现的最棘手的问题,分两阶段修复。

第一阶段(f23f1a464):primary_slim=1 + KNI 开启时,KNI 的 runtime TX/RX 应该由 primary 执行(因为 virtio_user vdev 只能 primary 操作)。但这样一改,primary 的 kni_process_rx 里调 rte_eth_tx_burst(Port0, queue_id=0) 把 kernel 回复包注入物理网卡,而 primary_slim=1 时 queue0 归属第一个 secondary worker0——两个进程并发操作同一个 TX queue,desc ring 会损坏、mbuf 会泄漏。DPDK 多进程模型里每个 TX queue 只能一个进程独占,没有进程级锁。

第二阶段(f250ad1ea):引入 kni_inject_rp 共享 ring 彻底消除竞态。primary 收到 KNI 回复包后不直接 TX Port0,而是 enqueue 到 inject ring,由 owner secondary dequeue 后用自己的 tx_queue_id 发出。方案选型时排除了另外两个:

  • 预留专用 queue(nb_queues+1,KNI 用最后一个 queue):本地 virtio 不支持 RSS,无法用 RETA 隔离额外 rx queue,vhost backend 会向所有启用的 qp 分发,额外 rx queue 无人 poll 会 desc ring 满导致 backpressure,不可行
  • rx!=tx 不等队列:virtio PMD 按 max(rx,tx) 分配 vq,未 setup 的 rx queue 会被后端写入导致 crash,不可行

inject ring 是唯一可行的路径。

4.5 踩到的坑:primary_slim=0 + owner_proc_id 误伤 KNI

实现 commit 1c28aaa2d 把 KNI 调用条件从 ff_kni_is_owner_thread() 改成了 ff_kni_is_runtime_owner(),但没考虑到 primary_slim=0 时 owner_proc_id 生效会导致 primary 不再处理 KNI,反而误伤了默认模式。修复(e075e534f)改成条件分支:primary_slim 时用 runtime owner 判定,否则用 owner thread 判定。

4.6 一个遗留问题:primary 退出清理其实效果有限

文档 14 专门分析了这个。跳过 rte_eal_cleanup() 的设计意图是保护 secondary 依赖的共享资源,但逐函数坐实后结论是实际效果几乎为零——hugepage 用 MAP_SHARED,primary 退出内核只 munmap 自己的映射不影响 secondary;config 文件不在 cleanup 里删除;mp_socket unlink 不影响 secondary(有自己的 fd)。

真正缺失的是没有通知 secondary 退出,primary 退出后 secondary 变成孤儿进程进入控制面降级态。但按设计哲学 primary 本来就不该正常退出,这个路径是”万一”的兜底。

【注意】这里对文档 10 里”避免 rte_eal_cleanup() 拆除共享资源”的说法做了修正——经源码坐实,rte_eal_cleanup() 实际上不拆除 secondary 依赖的共享资源,这个说法不完全准确。skip cleanup 的真正价值是保守策略:避免 cleanup 过程中 pthread_cancel 等操作的未定义行为。

4.7 issue 原文两处判断被实测修正

这个值得单独说,因为它是整个调研最有价值的部分——初始回复的两个前提假设,实测后都不准确:

  • “primary 一旦异常退出,整个进程组都得重启” → 部分不成立。其余进程继续服务,崩掉的 secondary 可原地重启(只要还有进程持有 /dev/uioX,uio refcnt >= 1),无需立即全组重启。但 primary 本身不能原地拉回(新 primary 会 EBUSY 失败,这是 EAL 的设计意图),所以还是要择机全组重启。
  • “所有连接都会受到影响” → 不成立。传统模式下只有哈希到 primary 队列的那部分流量受影响(2 进程约 1/2,3 进程约 1/3),瘦身后零影响。
  • “secondary 异常了可以重启,不影响其他进程” → 成立,E2d 实测验证。

5. 如何使用、配置与效果

5.1 配置

在 config.ini 的 [dpdk] 段加 primary_slim,在 [kni] 段加 owner_proc_id:

[dpdk]
lcore_mask=f             # primary(lcore0) + 1 个 secondary(lcore1)
primary_slim=1           # 0(默认)=关闭,1=primary 瘦身
primary_slim_idle_sleep=1000   # 默认 1000us,避免 primary 空转占满一核,后续因为kni还需要主进程处理,可以根据需要适当调整该值
​
[port0]
lcore_list=1-3             # 关键:primary 的 lcore0 不在列表内,队列全归 secondary
​
[kni]
enable=1
method=reject
owner_proc_id=1           # primary_slim=1 + KNI 时指定 runtime owner secondary
tcp_port=1-65535

配置校验会自动拦截三种非法组合:primary_slim 与 thread_mode 互斥、nb_procs 必须 >= 2、primary lcore 不得在 lcore_list 里。

5.2 启动

启动方式不变,还是 start.sh 管多进程:

./start.sh -c config.ini -b ./example/helloworld

5.3 效果

功能正确性(文档 05 实测):

  • 杀瘦身 primary 后已建连接 12/12 零中断,26 个探测轮次无一次失败
  • 杀瘦身 primary 后新建连接 12/12 正常
  • QPS:slim primary 存活时 122.4k(相对单进程基线 122.3k,+0.08%);slim primary 崩溃后 127.7k(+4.5%),均 0 失败请求

KNI 场景(文档 13 实测):

  • ping 5/5 0% 丢包,rtt 0.512~1.329ms
  • HTTP 200

结项验证(文档 15):

  • 物理机功能测试、性能压测通过
  • 默认标准多进程模式 10 分钟以上大流量回归压测零回归
  • 多线程模式(thread_mode=1)10 分钟以上大流量回归压测零回归

5.4 已知边界

  • 全部实测在 virtio 设备 + igb_uio 的虚拟化环境完成,物理机功能/性能压测已补做通过,但 VFIO 下的 refcnt 语义与设备运行态保持行为仍标注为未充分验证
  • primary 不可原地拉回,控制面降级后需择机计划内全组重启
  • 优雅退出未实测,primary 退出建议走强杀而非 rte_eal_cleanup()
  • 长期稳定性(小时级)未充分观测,10 分钟以上大流量回归通过

6. 延伸阅读:

  • 完整调研与实现文档:docs/primary_slim_spec/zh_cn/(00-15)
  • 结项报告:docs/primary_slim_spec/zh_cn/15-结项报告.md
  • 三层架构:docs/zh_cn/F-Stack_Architecture_Layer1_System_Overview.md
  • issue 原文:https://github.com/F-Stack/f-stack/issues/1078

F-Stack 2.0 前瞻 1 : F-Stack 原生多线程支持 – 单进程多线程多协议栈实例

1. 本功能主要作用和特点

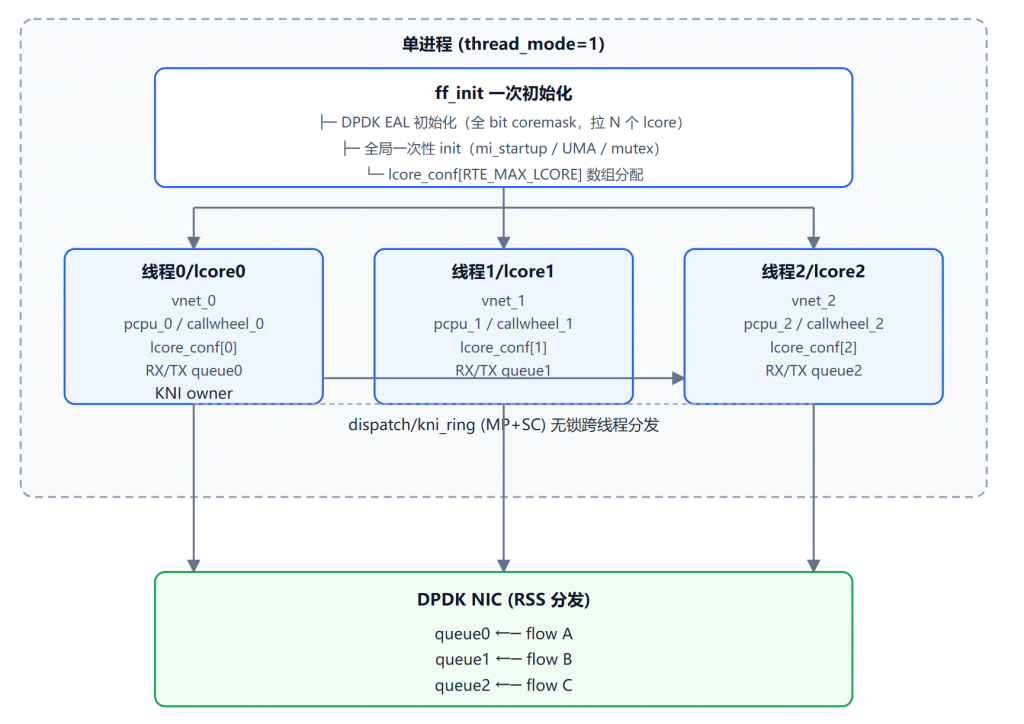
F-Stack 原生多线程支持(native-mt,thread_mode=1)是 F-Stack v2.0(预计2026.10正式release) 引入的一种新运行模式:在单进程内启动 N 个线程,每线程运行一份完全独立的 FreeBSD 协议栈实例,线程间 share-nothing、无锁,靠网卡 RSS 分队列做数据面分流,靠无锁 ring 做跨线程分发。

1.1 核心特点

特点说明
单进程多线程不再启动 primary + N 个 secondary 进程,改为一个进程内 N 个 lcore 线程
多协议栈实例每线程一份独立 vnet(VNET/VIMAGE 隔离),含独立 ifnet/PCB/路由表/端口分配
share-nothing 无锁数据面线程间无共享可变状态,无锁竞争,线性扩展
零回归 opt-inthread_mode=0(默认)时多进程模式逐字节不变
API 向后兼容ff_init/ff_run 签名不变,应用无需改动即可在新模式运行

1.2 与多进程模式的对比

维度多进程模式(默认)native-mt 模式
进程数1 primary + N secondary1 个进程
线程数每进程 1 个主线程N 个 lcore 线程
协议栈实例每进程一份每线程一份(VNET 隔离)
共享内存跨进程共享 hugepage/mempool同地址空间,直接访问
IPC 开销跨进程 IPC(如ring) 通信无跨进程 IPC,直接内存访问
进程管理需 start.sh 管理多进程单进程管理简单
容错隔离进程崩溃互不影响线程崩溃可能影响整个进程

2. 本功能的主要适用场景

2.1 单机多核部署的简化管理

多进程模型需要 start.sh 脚本启动 1 个 primary + N 个 secondary 进程,进程管理、信号处理、资源清理都较复杂。native-mt 模式只需启动一个进程,大幅简化部署运维。

2.2 减少多线程应用迁移成本

某些应用原本是多线程模式,迁移到原有的多进程 F-Stack 需要较大的迁移成本,native-mt 模式让应用在单进程内获得多核扩展能力,而不再需要 fork 或启动多个独立进程等迁移改造。

2.3 减少跨进程 IPC 开销

多进程模式下,某些应用的共享控制数据可能需要 IPC (如共享内存或ring等方式)才能在进行跨进程共享,native-mt 模式下这部分共享数据可直接在同进程内访问。

2.4 业界主流模型对齐

mTCP、Seastar 等高性能用户态网络框架普遍采用 thread-per-core + share-nothing 的单进程多线程模型。native-mt 让 F-Stack 与业界主流架构对齐。

3. 本功能的架构特征

3.1 整体架构

3.2 per-thread 隔离策略

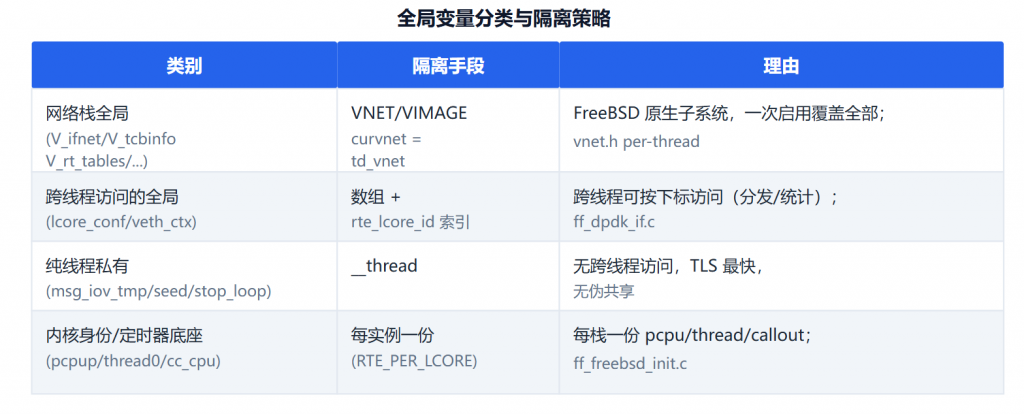
native-mt 的核心挑战是:FreeBSD 协议栈有数百个全局变量,如何在单进程内让每线程拥有独立副本?答案是分四类隔离:

3.3 数据面无锁通信

跨线程通信使用 DPDK 的无锁 ring,保持多进程模式已有的语义:

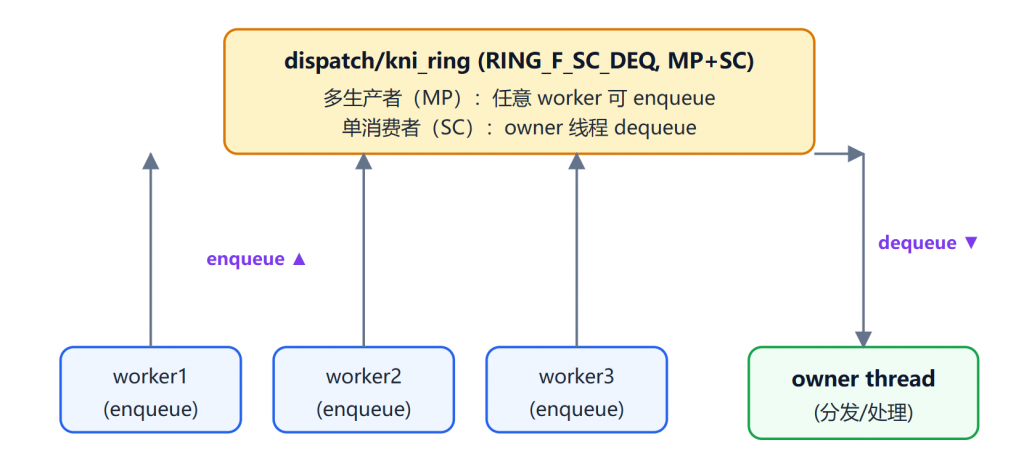
  • dispatch/kni_ring:保持 RING_F_SC_DEQ(MP+SC),多 worker 写、单 owner 读
  • msg_ring:已数组化 msg_ring[RTE_MAX_LCORE],每线程用自己 lcore 索引,SP+SC
  • mempool:按 NUMA socket 共享,DPDK per-lcore cache 开箱 MT-safe,无需改造

4. 改造工作与遇到的问题

后续比较枯燥,不需要深入研究实现过程的可以跳过本节。

4.1 改造里程碑总览

native-mt 的改造按危险度递增分 8 个里程碑(CM0-CM7):

里程碑目标危险度关键 commit
CM0低垂果实 + 脚手架低e79ceb9f0
CM1配置层 thread_mode 开关低3c31cc540
CM2lcore_conf per-lcore 化 + DPDK 拉 N lcore中e79ceb9f0
CM3底座全局 per-thread(pcpu/thread0/callout)高e79ceb9f0
CM4VIMAGE 可行性 PoC(关键卡点)高/存疑86e0f76b0
CM5初始化重构(per-thread 栈实例 init)极高717843004 + 7495e70c0
CM6KNI owner 线程 + msg_ring per-thread中6d74d59e0
CM7联调 + 回归 + 性能基线中fea49af6d + be4233709

4.2 CM0-CM3:per-thread 化基础

问题1:msg_iov_tmp 全局变量数据错乱

ff_syscall_wrapper.c 的 msg_iov_tmp/msg_iovlen_tmp 是全局数组,多线程并发调用 ff_readv/ff_writev 会互相覆盖。这是最低垂的果实——恢复 __thread 即可修复,多进程模式亦无害。

问题2:lcore_conf 全局单例

ff_dpdk_if.c:123 的 lcore_conf 是全局单例,30+ 引用点。改为 lcore_conf[RTE_MAX_LCORE] 数组,每线程用 rte_lcore_id() 索引自己的那份。同时引入 ff_cur_lcore_conf() 宏作为间接层,降低后续改动面。

问题3:pcpu/thread0/callout 底座全局

  • pcpup(ff_freebsd_init.c:69)→ 每线程一份 __thread struct pcpu
  • thread0/proc0(ff_init_main.c)→ 每实例一份
  • cc_cpu callout(ff_kern_timeout.c:180)→ __thread struct callout_cpu,CC_SELF() 返回本线程实例

4.3 CM4:VIMAGE 可行性 PoC(关键卡点)

这是整个项目最大的不确定项。VIMAGE 是 FreeBSD 原生的虚拟网络栈子系统,启用后 curvnet = curthread->td_vnet 按 per-thread 隔离数百个网络栈全局。但 f-stack 大量阉割了 FreeBSD 用户态代码,VIMAGE 能否跑通需实测验证。

PoC 结果:VIMAGE 可用(route B 验证通过)

  • opt_global.h 加 #define VIMAGE 1
  • 每线程 vnet_alloc() 创建独立 vnet 并设 td_vnet
  • VNET_SYSINIT 每 vnet 各跑一份,V_tcbinfo/V_rt_tables 成功隔离

4.4 CM5:初始化重构

问题4:mi_startup/SYSINIT 一次性机制

ff_init_main.c 的 mi_startup 跑完会打勾 SI_SUB_LAST,二次调用空转。需拆分:全局一次性 init(EAL/UMA/mutex/vnet0)+ per-thread 栈实例 init(vnet_alloc/td_vnet/VNET_SYSINIT/pcpu_i/thread0_i)。

问题5:worker cred 挂全局 prison0(R1 缺陷)

这是 native-mt 最隐蔽的 bug。症状:2 线程压测 0 req/s,client 反复重传 SYN,f-stack 从不回 SYN-ACK。

根因:worker 线程的 cred 挂在全局 prison0 上,而 FreeBSD socket 的 vnet 取自 cred 的 prison(CRED_TO_VNET(cred)),不是 curvnet。导致 worker 所有 socket/ifioctl 被静默重定向到 vnet0,worker vnet 无接口地址、无默认路由(ENETUNREACH),app listen 的 PCB 全建在 vnet0,而数据面在 worker vnet 查 PCB → 收到 SYN 不回 SYN-ACK。

修复:lib/ff_freebsd_init.c 新增 ff_worker_prison_init(),给每个 worker 分配独立 prison,使其 CRED_TO_VNET 指向自己的 vnet。

问题6:worker pcpu cpuid 越界(R2 缺陷)

修复 R1 后,worker vnet 的 PCB 表被真正使用,压测时 in_pcblookup_mbuf SIGSEGV。

根因:worker 的 pcpu_init() 传 rte_lcore_id()(=2)作 cpuid,但本 build 非 SMP(MAXCPU==1)、mp_maxid==0,UMA/SMR per-cpu 数组只按 1 CPU 分配 → zpcpu_get() 越界。

修复:ff_pcpu_thread_init() 改传 0(当时方案)。后续在文档 17 的 SMP-aware 改造中彻底修复——每线程拥有稠密、独立的 pcpu 槽位。

4.5 CM6-CM7:KNI/工具链归属与联调

问题7:KNI 归属

多进程模式下 KNI 由 primary 进程独占(virtio_user vdev 只能由 primary 创建)。native-mt 无 primary/secondary 概念,KNI 改由单一指定线程(线程 0)独占持有。现有 kni_rp/bitmap 已按 rte_lcore_id() 命名,天然可 per-lcore,改动集中在门控判定。

问题8:worker 时钟缺口

症状:2 线程吞吐从修复前的 0 提升到 557 req/s,但仍远低于 1 线程的 ~209k req/s。

根因:worker 线程的 FreeBSD 时钟从未被驱动。init_clock() 仅在主线程调用一次,worker 的 freebsd_clock(__thread)是零初始化(expire == 0),ff_hardclock_job 永不触发 → worker 的 callwheel 永不推进 → vnet_i 上 syncache 超时、TCP 重传、delayed ACK 全部瘫痪。

修复:新增 ff_hardclock_worker()(只推进本线程 callwheel,不触碰全局 ticks/timecounter)+ init_clock_worker()(worker 在 main_loop 中注册自己的定时器)。

4.6 后续优化:SMP-aware pcpu 视图与去全局锁

问题9:SMR per-cpu 槽位共享的 UAF 窗口

R2 修复后所有 worker 的 pc_zpcpu_offset 均为 0,共享同一份 SMR per-cpu 槽位。理论窗口:A 线程 smr_exit 置 SMR_SEQ_INVALID 可能清掉 B 线程的 read section 标记 → smr_poll 误判无读者 → PCB 提前回收(UAF)。

修复(commit c7996a94f):定义 SMP,设置 mp_ncpus/mp_maxid/all_cpus 为 nb_threads,每线程拥有稠密 pcpu id 和 per-thread curcpu,每线程独占不相交的 UMA/SMR per-cpu 槽位。

问题10:uma_crit_lock 全局自旋锁

f-stack 曾为保护 UMA per-cpu cache 加了全局自旋锁 uma_crit_lock(lib/include/vm/uma_int.h)。在每线程独占 per-cpu 槽位后,该锁已无必要。

修复(commit 57b612d16):移除 uma_crit_lock,critical_enter/critical_exit 变为 no-op,恢复 UMA per-cpu cache 的无锁快路径。

5. 如何使用、配置与效果

5.1 配置方法

在 config.ini 的 [dpdk] 段新增 thread_mode 配置项:

[dpdk]
# lcore_mask 指定使用的 lcore 集合,thread_mode=1 时每个 bit 对应一个线程
lcore_mask=0xf           # 4 个 lcore = 4 个线程
​
# thread_mode: 0=多进程模式(默认),1=单进程多线程多栈实例
thread_mode=1
​
# 其他配置项与多进程模式相同
idle_sleep=20
hz=100
​
[port0]
addr=<DPDK_NIC_IP>
netmask=<NETMASK>
broadcast=<BROADCAST_IP>
gateway=<GATEWAY_IP>
lcore_list=0,1,2,3       # 与 lcore_mask 对应,可以忽略

5.2 启动方式

native-mt 模式下只需启动一个进程(不再需要 start.sh 脚本管理多进程):

# 编译(make clean 后全量重编)
cd f-stack/lib && make clean && make -j$(nproc)
cd f-stack/example && make clean && make
​
# 启动(单进程)
./example/helloworld --conf config.ini --proc-type=primary --proc-id=0

5.3 使用效果

性能基线实测(virtio 网卡环境)

配置线程/进程数req/s延迟 (avg)说明
thread_mode=1, 2 线程2233,380—修复后多线程
thread_mode=0, 2 进程2231,570—多进程对照

关键发现:

  1. 多线程线性扩展:2 线程 233k req/s,与 2 进程 231k 持平,验证 share-nothing 无锁模型的线性扩展能力
  2. 60 秒 soak 稳定:400 连接持续 60 秒达 497k req/s、2983 万请求零错误
  3. 【注意】thread_mode=0时单进程程数据确认为当时噪声,不在本文展示,实际性能单进程和单线程都差不多

零回归保证

thread_mode=0(默认)时所有路径走既有 primary/secondary 分支,字节级不变。已通过 10 分钟以上大流量回归压测验证。

5.4 注意事项与限制

限制说明
fd 不可跨线程共享每个线程的 fd 表独立(VNET 隔离),同 fd 在不同线程含义不同,与多进程模式时单进程内的fd语义限制相同
KNI 单线程独占KNI 由线程 0 独占持有,其他线程不处理 KNI(其他线程需要kni处理的包通过kni_rp转发至线程0,流程与多进程模式相同)
工具链兼容优先保留外部工具进程(--proc-type=secondary)attach 方式,向后兼容
VIMAGE 依赖启用 VIMAGE 需完整编译,部分 f-stack 阉割的 FreeBSD 子系统可能不完整
物理网卡 RSS多线程真实扩展性依赖网卡 RSS 能力,无 RSS 网卡多线程扩展受限,与多进程模式相同

6. 参考资料

  • 三层架构文档:docs/zh_cn/F-Stack_Architecture_Layer1_System_Overview.md
  • native-mt spec:docs/native_mt_spec/zh_cn/(00-17 完整设计文档)
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • issue 汇总:docs/zh_cn/f-stack-issue-ana.md(#430/#571/#807/#855 等多线程相关 issue)
  • 代码提交:e79ceb9f0(CM0-CM3)→ 86e0f76b0(CM4 VIMAGE)→ 7495e70c0(CM5 多栈实例)→ 6d74d59e0(CM6 KNI)→ 82b409faf(worker 时钟)→ ff09a17b2(prison 隔离)→ c7996a94f(SMP-aware pcpu)→ 57b612d16(去全局锁)

F-Stack 2.0 前瞻0 : F-Stack 使用 CodeBuddy 开发工作流清空代办列表的实践

本文介绍 F-Stack 工程,通过在 CodeBuddy 使用自建 Skill + 知识库 + spec + harness 多 agent 门禁体系,2026 年大功能全由 AI 辅助完成的实践,主要完成或完善的大功能后续则会有 F-Stack 2.0 前瞻一系列系列的文章分别单独介绍。

1. 本功能主要作用和特点

AI 发展到 25 年底 26 年初之后,在实际项目中逐步可用了,从现网业务的单元测试、小功能逐步扩展到大工程的复杂任务(非 F-Stack,如 DNS 支持 io_uring 代替 epoll 性能总体提升 25% 左右),而我们在 F-Stack 上也从 2026年5月后开始用 CodeBuddy 做 AI 辅助开发,到今天已经把「怎么让 AI 在这个大 C 语言项目里干活干得靠谱」沉淀成了一套可复用的工作流——三个自建 Skill(f-stack-dev-rule / f-stack-info-search / f-stack-issue-process)+ 知识库(架构文档/知识图谱) + spec 文档驱动 + harness 工程化多 agent 流程 + 全链路门禁体系。这篇把这套工作流捋一遍:由哪些部分组成、每部分解决什么问题、2026 年实战效果如何。

从 5 月中旬至今 8 月中旬的 3 个月时间里,我们通过这套基于 CodeBuddy 的工作流由 AI 辅助完成的大功能清单(数据来自项目 iwiki 工作清单),成功将限于人力原因历史一直积攒的待办列表近乎清空,也算是为这段经历划上一个还算可以的分号(放心,F-Stack 后续会一直参与进行维护),当然 token 消耗也是杠杠的,单 F-Stack 这些功能大约消耗了 5-60 亿左右的 token 吧,且 7-80% 是 opus-4.6 ~ opus-5.0,公司的 token 额度支持是必不可少的。

【注意】耗时仅是功能开始和结束时间统计,中间会穿插做很多其他事情,不代表单独本功能实际 AI 辅助开发的用时,实际用时要更少,所以抛开实际上线流程,单纯讲开发自测流程,AI 的提效真不是盖的。

功能完成时间耗时
LD_PRELOAD 信号量 → 无锁 ring IPC2026.05.2510 天
FreeBSD 13.0 → 15.0 协议栈升级2026.06.0910 天
DPDK 升级到 24.11(dev 分支)2026.06.101 天
单元测试框架(Unity/CMocka)2026.06.112 天
接收零拷贝 ff_zc_mbuf_read2026.06.111 天
发送零拷贝原生化(去掉 MAGIC 魔改)2026.06.121 天
lib 库本地 socket 访问,后续考虑会移植到 1.21(LTS)2026.06.184 天
io_uring 对标调研,最终结论 F-Stack 当前不会去做 io_uring 对标2026.06.181 天
ff_rss_check 优化(IPv6 + rte_thash),后续会考虑部分移植到 1.21(LTS),rte_thash(DPDK-19.11不支持)需进一步调研2026.07.163 天
MTU 修改支持(jumbo frame),后续考虑会移植到 1.21(LTS)2026.07.223 天
LRO 支持 + TSO 完善,后续考虑会移植到 1.21(LTS)2026.07.231 天
基于 VIMAGE/VNET 的原生单进程多线程多协议栈(native-mt)2026.08.055 天
issue 批量处理 320 → 0,完全可以修改下复用到其他项目issue/工单的处理中2026.08.10持续

这些功能的统一分工模式是:所有代码由 AI 完成,人工只做提示词、spec 文档、plan、纠正方向、结果审核和测试验收(开发的虚拟机环境由 CodeBuddy 根据工作流自动进行单元测试和运行测试进行验收,人工额外做物理机的测试验收)。几个关键词:

  • 规约先行:AI 在 F-Stack 里干活的第一件事不是写代码,是加载 f-stack-dev-rule——13 节强制规约零容忍,把”AI 容易翻车的点”(rm/kill/chmod、增量编译、config.ini 污染、真实 IP 泄漏、注释风格)全部前置成规则
  • skill 分层:三个 skill 各管一段——dev-rule 管”怎么改”、info-search 管”怎么搜”、issue-process 管”issue 怎么处理”,另有一批通用 skill(spec 驱动、harness 工程、C 语言开发、单测等)可以对应安装,这篇不展开
  • harness 多 agent 门禁:大任务强制走”调研出中文 spec → 人工审核 → 多 agent 实现 → 门禁审核 → 里程碑提交”的完整链路,写审分离、单步打回上限 3 次

2. 本功能的主要适用场景

2.1 大功能开发(调研 + spec + harness 实现 + 验收)

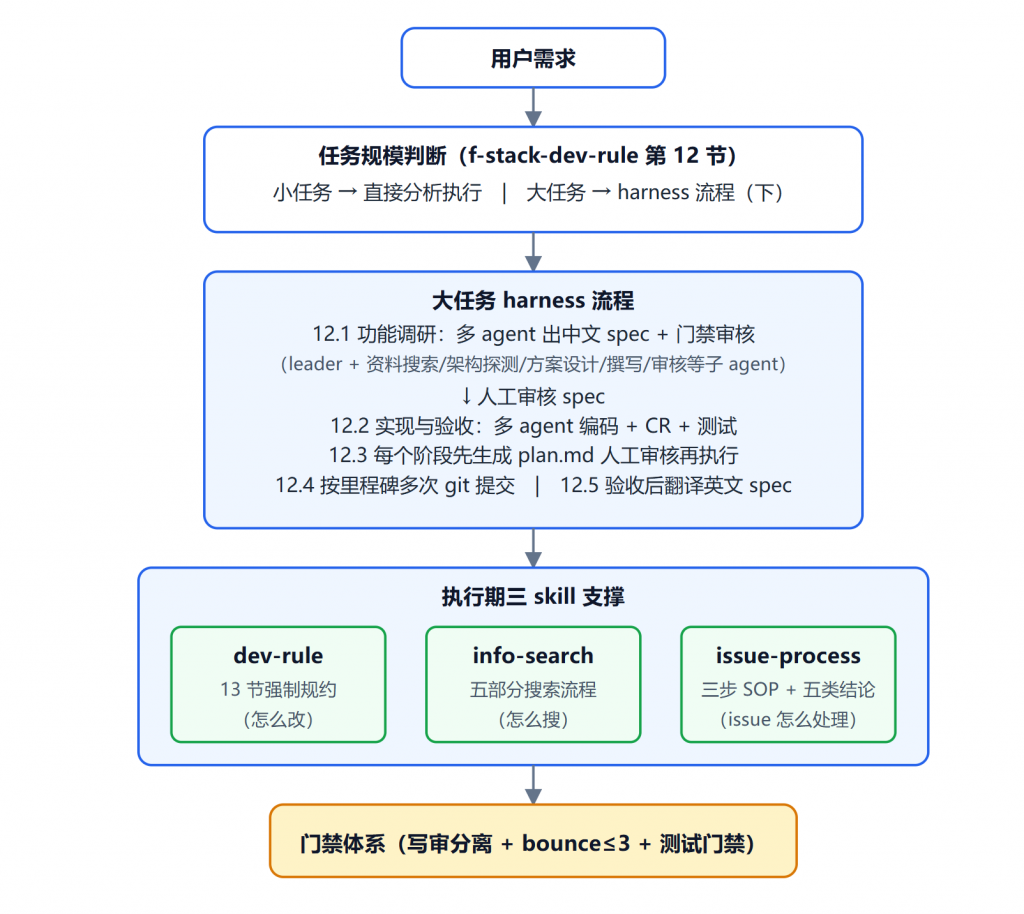
F-Stack 里凡是”一个新功能/一次大升级”级别的任务,都走 harness 流程:先多 agent 调研产出中文 spec 文档(放 docs/<FEATURE>_spec/zh_cn/,具体调研过程见 f-stack-info-search 这个skill),人工审核通过后另起多 agent 做实现和验收,按里程碑多次提交,验收完成后才翻译英文 spec,包括 freebsd 13→15 升级、native-mt、ff_rss_check 优化 等都是这么干的。

2.2 issue 分析与批量处理

f-stack-issue-process skill 定义了 issue 处理三步 SOP(读全文 → 搜资料 → 综合判断),配合五类结论模板。2026 年项目把 issue 从 320 个清理到 0 个,全程半自动化:AI 按 SOP 分析归档、人工确认或修复后回复关闭,处理了众多咨询类 issue,并对功能类 issue 修复和新增了很多问题或功能。

2.3 性能优化攻坚(需要对照实验的)

ring IPC 性能优化、RSS check 优化这类”优化”任务,AI 的价值不在写代码而在执行对照实验纪律:对照组先于优化、数据先于理论、每条假设配套可证伪的物理量。ring IPC 的 v1~v3.7 七轮迭代就是 AI 在规约约束下自我证伪的完整案例。

2.4 不太适合的场景

  • 一句话的小改动:直接说需求就行,别套 harness 流程(任务规模判断规约里小任务直接执行)
  • 需要物理环境验证且环境不齐的:规约要求”未实际执行不臆测”,环境不满足时 AI 只能如实标注「未坐实」,硬要结论反而有害
  • token 额度紧张时期:native-mt 这种”堪比重做一个小 f-stack”的任务消耗巨大(iwiki 原话),适合额度重置后再做

3. 本功能的架构特征

3.1 工作流总图

3.2 三个自建 Skill 的分工

f-stack-dev-rule(怎么改):F-Stack 工作区一切任务的强制规约合集,13 节零容忍。核心几条:Shell 操作必须走 rm_tmp_file.sh/kill_process.sh/chmod_modify.sh 三个脚本(严禁直接 rm/kill/chmod);改代码先 make clean 再完整编译(增量编译不作为依据);config.ini 本地测试值不入库;文档严禁真实 IP 用占位符;commit message 英文 1-3 句;lib 最小注释;多 agent 写审分离/bounce≤3/leader 轮询不提前退出;所有调研类任务必须用 info-search 搜资料;任务规模判断与 harness 流程;代码改动必须过单测和运行时回归测试。

【注意】即使有了这些限制规则,Agent 也是会经常跑偏,或者不遵守规则限制的,所以人工的值守和纠偏目前依然是不可或缺的

f-stack-info-search(怎么搜):一切提问/分析/调研类任务的资料搜索 SOP,五部分:查三层架构文档与知识图谱(docs/ 下 LAYER1/2/3 + KNOWLEDGE_GRAPH_WIKI)→ 查代码提交记录(本地 git log + DPDK 上游)→ 查关联 issue/PR(先查本地 issue 分析档案再 gh search)→ 查公开资料(DPDK Bugzilla/Patchwork/邮件列表)→ 内外网技术资料(博客/公众号/iWiki,中英双语关键词)。核心纪律是三方证据收敛:内部文档 + 外部资料 + 实际代码,不一致处以实际代码为准。

f-stack-issue-process(issue 怎么处理):三步 SOP——读 issue 全文(含全部评论,不可只看标题)→ 调 info-search 搜资料 → 综合判断。五类结论模板(已修复/有上游 patch 未合入/未修复/有 workaround/非 bug),关键约束是不可自动操作 issue:分析完必须人工确认后才能评论关闭,回复用英文只讲核心结论。每次处理后同步更新中英文 issue 分析档案(f-stack-issue-ana.md,可以不断增加新的知识点供后续的issue分析和问题调研使用)。

3.3 门禁体系(AI 干活的刹车)

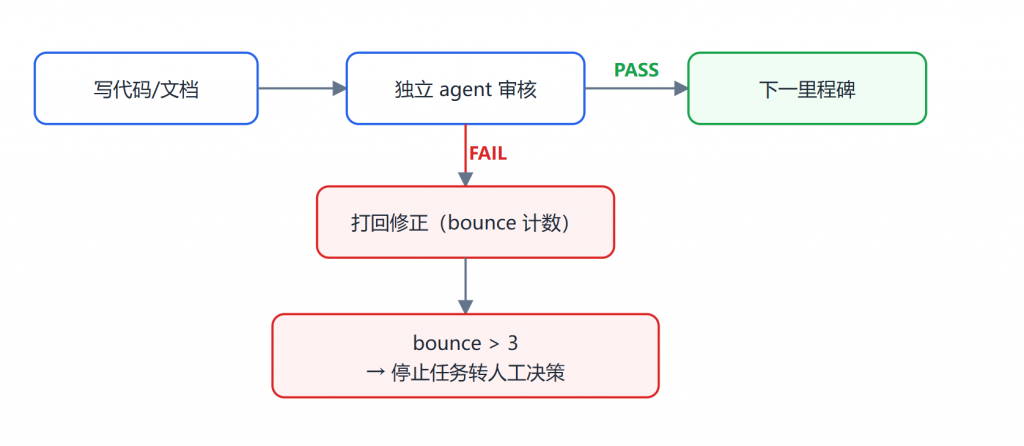
  • 写审分离铁律:写代码/文档与审核必须不同 agent,leader 严禁自写自审;纯调研/探测/汇总等单一角色可由 leader 兼任
  • leader 轮询:子 agent 全部完成前 leader 严禁提前退出;禁止无超时死等,旁路探测(读落盘文件、git 状态)优先于消息探测,否则 CodeBuddy 等 Agent 经常出现子进程因为各种原因异常退出导致的整个任务中断,需要人工继续任务的情况。
  • 异常回退:子 Agent 超时/卡死时 leader 接管或 spawn 新 agent 重做,但不得违反写审分离
  • 测试门禁:代码改动必须完成单测和运行时回归测试,同样受门禁规则限制

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 skill 体系是怎么长出来的(从零散规则到三个 Skill)

这套体系不是一次设计出来的,是被实战问题逼出来的。从最早的裸奔,在 AI 开发过程中逐步踩坑晚上,并在后期整理合并成 f-stack-dev-rule 一个 skill 统一加载(13 节),替代分散的十余条分条规约。info-search 和 issue-process 则是从 issue 处理实战中提炼的:issue 处理要先搜索资料再下结论、搜索有固定的五部分流程、结论有五类模板、档案要中英同步——这些”怎么做对”的经验固化成了 skill。

skill 的落地方式是”库 + 源”双份:安装到 ~/.codebuddy/skills/ 供 CodeBuddy 加载,同时在 docs/zh_cn/skills/ 保留一份源码,规约明确”安装前若 use_skill 不可用,直接读取 docs/zh_cn/skills/ 下对应 SKILL.md 全文作为规约执行”。零容忍条款一旦违反任务直接打回。

【注意】规约里有一条值得单独说:rm_tmp_file.sh/kill_process.sh/chmod_modify.sh 三个脚本不是形式主义——2026 年 6 月 ZC-recv 实测期间就发生过一次误用 rm -rf 的违规(M2 报告里记录并修复)。规约约束的是 AI 最常见的危险动作,脚本带审计日志(chmod 快照到 /tmp/.trash/、审计到 /tmp/.chmod_audit.log),出了问题可回查。

4.2 实战问题一:AI 会”看起来很对,实际全错”

本地 socket 访问功能(2026.06.18,4 天)是典型的反面案例——iwiki 原话:”本功能 AI 表现不好,人工打回返工多次才最终完成”。这说明流程里最值钱的是”人工审核”和”打回”这两个环节,而不是 AI 一次写对的能力。对应到规约里就是 bounce≤3 的打回链:门禁失败必须打回上一步修复,同一单步打回超 3 次立即停止转人工决策,不许带病放行。

4.3 实战问题二:AI 会臆测,必须用”实事求是规约”压住

规约第 9 节(实事求是)和第 10 节(资料搜索)专门治这个:所有行动必须实际执行,严禁未执行就猜测给结果;代码/文档/外部数据源交叉验证,不一致处以实际代码为准;无法静态坐实或环境不满足的项,如实标注「未坐实/未执行」。ring IPC 性能分析的 v1~v3.7 七轮迭代是这个规约的最好注脚:v1 的单边代码分析错误、v2 的未验证假设、v3.3 的方案 C 实测劣化 4% 当天回退——每一步错误的证伪都靠实测数据,最终收敛出”ring 无 net win、生产推荐 sem”这个反直觉但正确的结论。

4.4 实战问题三:编译卫生和增量陷阱

AI 写 C 代码最常见的坑是增量编译:FF_ZC_* 开关切换后 make 按时间戳跳过 .o 重编译,导致内核 hook 缺失、http=000 的诡异现象(ZC M2 报告)。规约把”改代码先 make clean、编译验证以 clean build 通过为准、增量编译通过不作为依据”写死,还附了本机两个已知坑的规避(IDE safe-delete hook 拦截 make clean 用 PATH 前缀规避、make -j16 竞态先 make machine_includes)。freebsd 13→15 升级踩的”宏改名丢包裹”坑(UMA_MD_SMALL_ALLOC → UMA_USE_DMAP)和”结构头改动未 clean 重编 ABI 偏斜”坑,也都沉淀成了规约条款。

4.5 实战问题四:token 消耗与任务切分

native-mt 的 iwiki 备注很诚实:”本功能超级复杂,堪比重做一个小 f-stack,消耗 token 较多”,残留风险如实记录后暂停,等 token 额度重置后继续。这说明 harness 流程还有一层现实约束:任务要按 token 预算切里程碑,做不完的宁可如实留档(残留风险清单),也不要糊弄收尾。issue 批量处理 320→0 则是另一个方向的实践——用内网版 OpenClaw/Hermes 按 SKILL 的 SOP 半自动化处理,穿插在 token 紧张期(因为内网版 GLM-5.2不计算额度)。

【注意】截止目前(2026.08.17)大任务初始的调研、架构文档、任务拆分等任务依然推荐使用高级模型(额度消耗非常非常大,需要特别注意,主要是目前其他部分模型在大任务的调研分析和架构设计上表现的依然一言难尽,就不实际举例了),完成任务拆分后实际的代码编写等小任务或具体任务可以交由较轻量模型(但也应使用 GLM-5.2 以上模型)执行。

4.6 2026 年各功能沉淀的文档资产

每个大功能都按 harness 流程留下了完整文档:freebsd_13_to_15_upgrade_spec、zc_stack_user_spec、ld_preload_ring_spec、mtu_change_spec、lro_tso_spec、native_mt_spec、rss check 优化 spec 等,加上三层架构文档(LAYER1/2/3)和知识图谱(KNOWLEDGE_GRAPH_WIKI)。这些文档反过来又成了 info-search 的搜索源——文档 → 代码 → 决策形成了闭环。

【注意】新功能更新后应该对应更新架构文档和知识图谱,否则 info-search 的搜索源会失真,后续调研拿到的是过期结论。更新可以靠流程约束(里程碑里带文档更新项),也可以靠自动化——比如 git 操作自动触发知识图谱重建(此前每次提交后 GitNexus 在后台更新知识图谱即是此类机制)。

5. 如何使用、如何配置、使用效果

5.1 Skill 安装与加载

三个 skill 都装在 ~/.codebuddy/skills/(f-stack-dev-rule / f-stack-info-search / f-stack-issue-process),CodeBuddy 会话中用 use_skill 按需加载。F-Stack 工作区的任何任务第一步先加载 f-stack-dev-rule;提问/分析/调研类任务必须加载 f-stack-info-search;issue 分析处理加载 f-stack-issue-process(其搜索环节内部调用 info-search)。

5.2 配套通用 Skill(对应安装,这篇不展开)

spec 驱动开发(spec-driven)、harness 工程(harness-engineering)、C 语言开发/单测(c-pro、c-unittest-expert 等)、C 精准外科手术式修改(c-precision-surgery)等通用 skill 与 F-Stack 自有三个 skill 组合使用——自有 skill 管”F-Stack 特有约束”,通用 skill 管”通用工程方法”。

5.3 使用效果(2026 年实测数据)

维度数据
AI 辅助完成大功能13 个
最大单任务FreeBSD 13→15 升级(编译矩阵 5 格全绿)
issue 清理320 → 0(2026.08.10 清零)
编译基线lib error 0 / warning 51(既有 baseline,新改动零新增 warning)
文档资产7 个功能 spec 目录 + 三层架构文档 + 知识图谱 + 中英双语 issue 档案
博客文章F-Stack 2.0 前瞻系列 8 篇(含中英文版),后续将陆续发出。

5.4 对使用者的建议

  • 先把规约读一遍再让 AI 动手:dev-rule 的 13 节每条都是实战换来的,AI 违反任何一条任务都会被人工打回
  • 大任务别跳过 spec 环节:中文 spec + 人工审核是成本最低的方向纠偏点,本地 socket 功能的返工证明”跳过调研直接写代码”更贵
  • 信任门禁不信单次输出:AI 写的东西必须过独立 agent 审核,bounce 是正常流程不是失败
  • 让 AI 如实说”不知道”:环境不满足就标「未坐实」,这比硬给结论值钱得多

6. 总结

虽然 CodeBuddy 还是存在不少问题吧,比如 Loop 总是中断,总是需要人工去提醒他继续,即使加了各种限制规则依然不能避免该问题,但是这个“Buddy”确实极大幅度的提升了我们功能开发的效率,还是需要非常非常感谢。

7. 延伸阅读:

  • 开发强制规约:docs/zh_cn/skills/f-stack-dev-rule/SKILL.md
  • 资料搜索技能:docs/zh_cn/skills/f-stack-info-search/SKILL.md
  • issue 处理 SOP:docs/zh_cn/skills/f-stack-issue-process/SKILL.md
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 历史 issue 档案:docs/zh_cn/f-stack-issue-ana.md
  • 2026 年各功能 spec:docs/<FEATURE>_spec/(freebsd_13_to_15_upgrade_spec、zc_stack_user_spec、ld_preload_ring_spec、mtu_change_spec、lro_tso_spec、native_mt_spec 等)