1. 本功能主要作用和特点
F-Stack 在多队列/多进程(share-nothing)部署下,进程作为客户端主动发起 TCP/UDP 连接时,必须选出一个”聪明”的本地源端口——让该连接的回包(SYN-ACK、响应数据)经网卡 RSS 哈希后落回发起连接的这个进程的接收队列。选错队列的后果是连接建立不起来或数据”串门”到别的进程,这在多进程架构下是致命的。这个选端口的活就是 ff_rss_check(lib/ff_dpdk_if.c)干的。
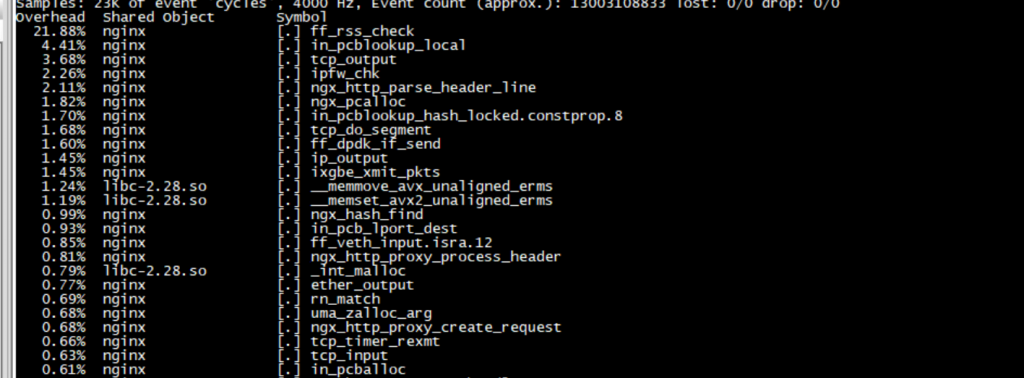
选端口有两个约束:既要保证回包落本队列(RSS 亲和),又要保证端口没被占用(四元组唯一)。原始实现是逐端口软算 Toeplitz hash 扫描,平均每次建连要几百个 tsc、且在高进程数下可能反复重试几十次,成为短连接场景的建连瓶颈。
本功能围绕这条选端口路径做了三层优化:
- 静态表快路径(上游 F-Stack 官方已有,commit e54aa4317,随 13.0→15.0 升级一度丢失后回迁):预先算好”对某个远端四元组,哪些本地端口落本队列”,建连时直接查表轮转取端口,省掉逐端口软算。
- rte_thash 反算路径(本仓库超越上游的新增):静态表未命中时,用 DPDK 的
rte_thash_adjust_tuple()按目标队列直接反算出满足约束的源端口,替代逐端口软扫描
【注意】thash反算可选端口范围受限(因为只是改动部分bit位),所以并发连接很大,所需端口很多时需要斟酌使用。
- IPv6 全链路(上游也没有,全新增):把上面两条路径,以及最早的
ff_rss_check完整扩展到 IPv6(16+16+2+2 的 36 字节 tuple)
另外还有两处配套:反算后的二次软算复核做成运行时开关(默认关,性能优先)、bind(addr,0) 后 connect 的端口延迟分配(对齐 Linux 的 IP_BIND_ADDRESS_NO_PORT 语义 + RSS 亲和)。
这套东西就一个特点:热路径分层降级、每层独立可用、错队列零容忍。静态表命中走最快路径,未命中走 thash 反算,反算失败回退软算扫描(端口都被占用不会回退),任何一层都保证最终选出的端口经独立软算确认落本队列(或按开关明示接受轻微分发不均)。
2. 本功能的主要适用场景
2.1 多进程/多队列部署下的客户端短连接
这是最典型的场景。F-Stack 经典部署是 1 primary + N secondary 共享网卡队列,每个进程只收自己队列的报文。进程做客户端(比如 nginx 反向代理连上游、网关主动探测)时,如果选出的源端口哈希不到自己的队列,回包就落错进程。连接越短、建连越频繁,选端口的开销占比越大,本功能收益越明显。
2.2 反向代理 / 网关类高频建连
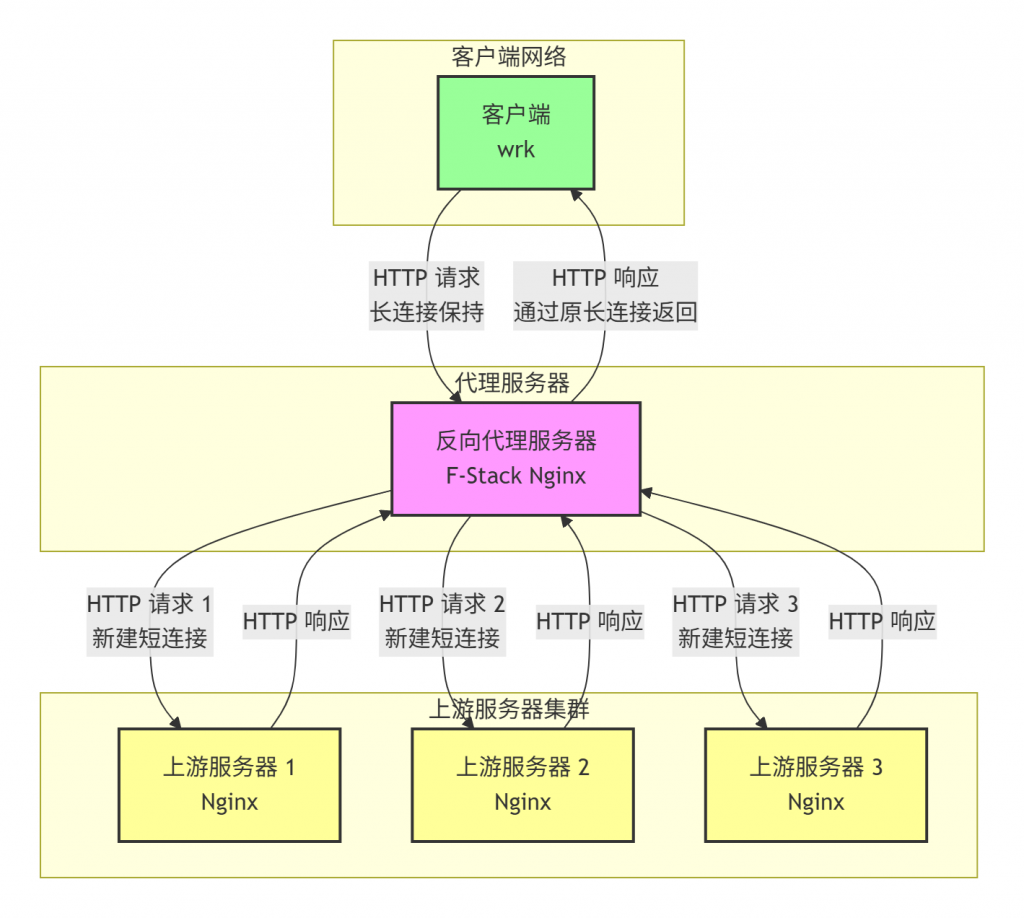
nginx_fstack 反代场景:客户端用长连接打进来,nginx 作为客户端用短连接连上游。每一条上游连接都要走一次选端口,静态表对这种”远端地址相对固定”的场景命中率极高(上游规则里配好常用的 upstream 即可)。
2.3 需要精确控制回包落核的多队列应用
任何关心”回包落本核”的应用都适用——不只是性能问题,多进程架构下回包落错队列意味着功能不可用。
2.4 不太适合的场景
- 纯服务端 listen + accept 的应用(选端口只发生在主动 connect,纯监听不触发),用不到本功能
- 远端地址完全随机、无法预先配置静态表、且并发连接特别高的场景(静态表不命中,退化为 thash 反算(可选端口范围受限严重,斟酌使用)/软算,功能正确但收益打折)
- 单队列部署(只有一个队列,选什么端口都”落本队列”,走的是零开销的短路路径)
3. 本功能的架构特征
3.1 选端口三层决策路径
一条 connect 进来,内核侧 in_pcb_lport_dest(freebsd/netinet/in_pcb.c)按下面的顺序选择源端口:
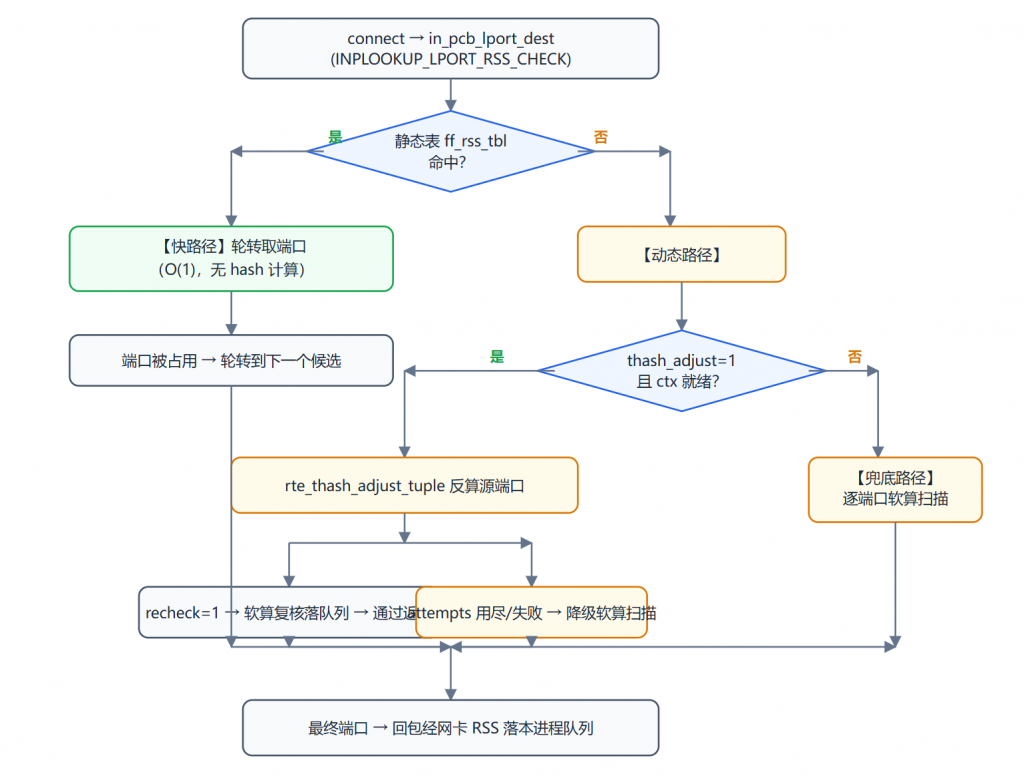
三层路径逐层降级、各自独立:静态表是纯查表(最快),thash 反算是数学反解(次快,单候选百 ns 级),软算扫描是全量 Toeplitz 计算(最慢但永远正确)。任何一层失败都不影响正确性,只是慢一点。
3.2 反算的核心:按”回包字段序”定位源端口
这里有个非常反直觉的设计点,是整个 thash 反算正确性的基石。
Toeplitz hash 是非对称的:hash(src, dst, sport, dport) ≠ hash(dst, src, dport, sport)。出向包(本地→远端)和回包(远端→本地)经网卡 RSS 落不同队列。我们反算源端口的目的是让回包落本队列,所以必须按回包的字段序构造 tuple:
出向包:srcIP=local  dstIP=remote  srcPort=local  dstPort=80
回  包:srcIP=remote dstIP=local   srcPort=80     dstPort=local  ← 本地端口在 dstPort 字段!
因此反算的 helper 要加在回包 tuple 的 dstPort 字段位上:IPv4 tuple 12 字节,本地端口在 byte10 = bit80(不是出向包的 sport 字段 byte8 = bit64);IPv6 tuple 36 字节,本地端口在 byte34 = bit272(不是 bit256)。代码里 FF_RSS_THASH_V4_SPORT_OFF=80、FF_RSS_THASH_V6_SPORT_OFF=272(lib/ff_dpdk_if.c:176/187),注释里明确写了这个”回包 dstPort 字段”的理由。
【注1】这个设计不是一开始就对的。最早的实现按出向包 sport 字段反算(v4 offset=64),结果 listen 成功但连接不通——出向包落对了、回包落错了。修正成 dstPort 字段后才端到端打通。详见 4.5。
3.3 三方 key 对齐架构
thash 反算要成立,有个前置条件:反算用的 RSS key、软算复核用的 key、网卡实际用的 key 三者必须完全一致。架构上做了两件事保证:
ff_rss_thash_build_key(port_id, reta_size)(lib/ff_dpdk_if.c:3459)在dev_configure之前串行构造 v4→v6 的 thash ctx,并把构造产出的统一 key(KEY_FINAL)发布到全局 rsskey,由调用方在 dev_configure 时编程进网卡——三方从此共用同一把 key- secondary 进程走
rte_thash_find_existing复用 primary 已建的同名 ctx,不再各自独立初始化(这也顺带解决了多进程下 ctx 重复初始化的 EEXIST 报错)
4. 具体做了哪些改造、遇到了哪些问题
后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。
4.1 起点:上游的静态表优化(e54aa4317)
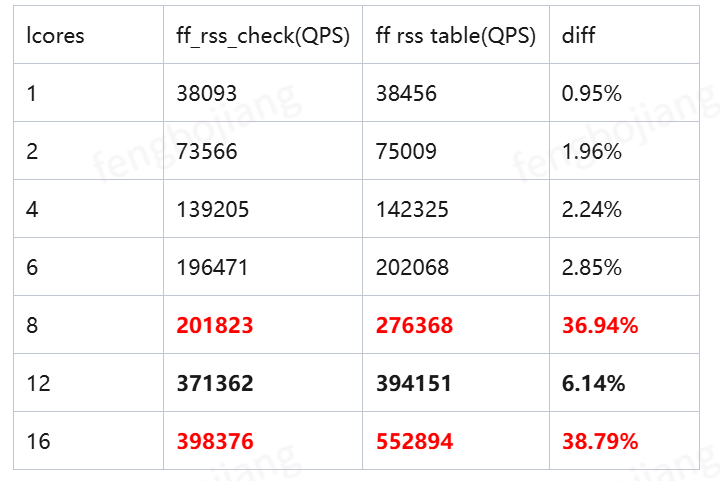
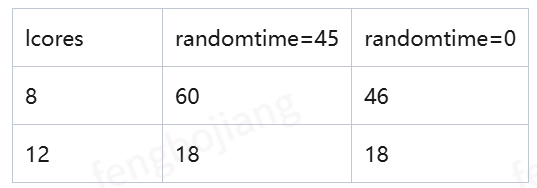
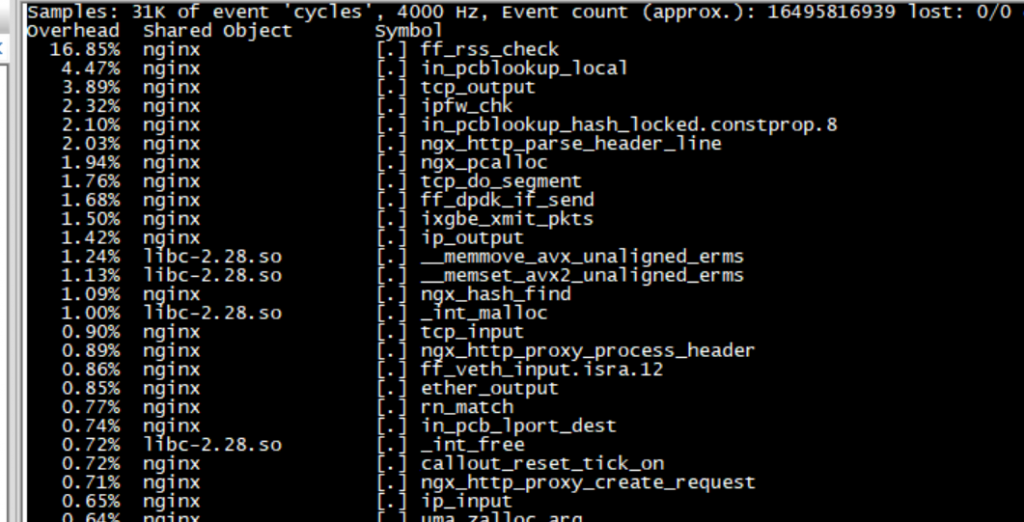
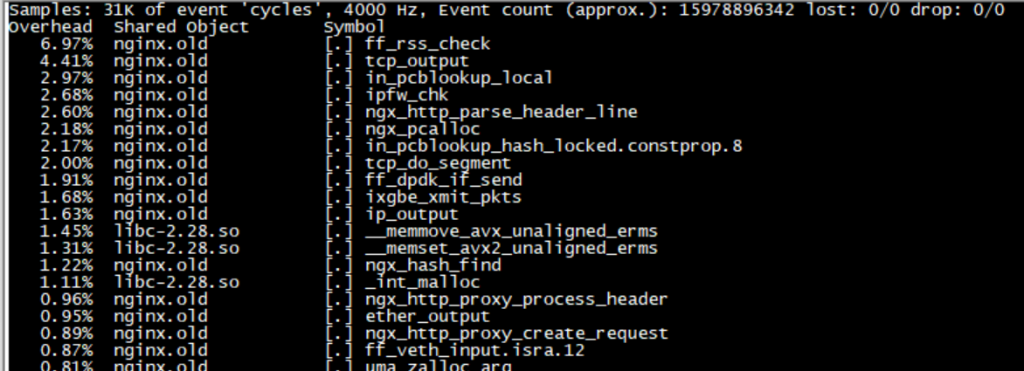
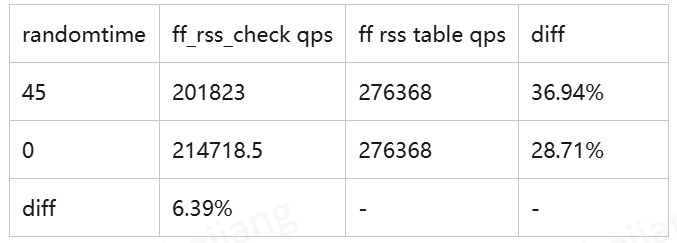
这套机制的源头是 F-Stack 官方的一次优化(commit e54aa4317,官方 wiki 有介绍,公众号文章 https://mp.weixin.qq.com/s/x5wWecqEKWGdcVbhne78tw)。核心思路就是空间换时间:启动时按配置的 (本地地址, 远端地址, 远端端口) 规则,把”哪些本地端口会哈希到本队列”预先算好存进 ff_rss_tbl,建连时查表轮转取端口,把”动态计算”变成”静态查找”。官方实测:常规场景 QPS 提升约 2~6%,特殊场景(8/16 进程)提升可达 36.94% / 38.79%——某些进程数配置下原始实现的随机选端口次数远超数学期望(8 进程时实测要试 46~60 次,理论期望 8~12 次),查表直接把这部分开销干掉了。
4.2 问题一:13.0→15.0 升级把内核侧钩子丢了(R-A 回迁)
升级 FreeBSD 13.0 → 15.0 时,用户态接口(ff_rss_check、ff_rss_tbl_init/set/get_portrange 等)都完整保留了,但内核侧消费这些接口的 #ifdef FSTACK 钩子没有移植——15.0 的 in_pcb.c 里 INPLOOKUP_LPORT_RSS_CHECK 宏只剩一个没人用的 #define,整个 RSS 选端口机制在内核侧完全失效,退回原生随机选端口。
修复(commit 22462f58d):按 15.0 的代码结构重新回迁。15.0 相对 13.0 有三个适配点:in_pcb_lport_dest 形参变成了 const struct inpcb *(RSS 逻辑只动局部变量);in_pcbconnect_setup 被合并进 in_pcbconnect(ff_in_pcbladdr 的对接点跟着挪);lookup 系列调用统一多了 RT_ALL_FIBS 入参。回迁后真机实测:primary/secondary 各 connect 200 次,200/200 全部落本队列。
4.3 改造二:thash 反算替代逐端口扫描(R-B)
静态表命中是快路径,但未命中时仍要逐端口软算。用 DPDK 24.11.6 的 rte_thash_adjust_tuple() 反算可以把这个 O(端口数) 的扫描变成直接反解。关键是把”落本队列”精确翻译成反算的 desired_value:本仓库落队列判定是 ((hash & (R-1)) % Q) == queueid,所以 desired = queueid + (rand % ceil(R/Q)) * Q,让反算出的 hash 低位精确落进目标队列的集合。反算成功后再用软算 ff_rss_check 复核一遍(可选,用于DEBUG,默认关闭提升性能)。adjust_sport 内 attempts 用尽(如端口都被占用,因为反算端口范围有限)则返回 -1,由内核侧 in_pcb_lport_dest 的 do-while 全端口扫描 + ff_rss_check 软算兜底。
4.4 改造三:IPv6 全链路(R-C)
上游的静态表是 IPv4-only。按方案 A 全新增 v6 独立符号(ff_rss_check6、ff_rss_tbl6_*、ff_rss_adjust_sport6),不动 v4 任何结构和签名。内核侧在统一的 in_pcb_lport_dest 里加 AF_INET6 并行分支、in6_pcbladdr 对接。IPv4 零回归的证据是硬邦邦的:R-C 相对 R-B 的 git diff 里 in_pcb.c 是 +86/-0,纯新增无一行 v4 删除。
4.5 问题二:Toeplitz 非对称——反算要按回包字段序(c42340d5 / R-G)
thash 反算落地后,物理机上出现诡异现象:listen 成功但连接不通,IPv4 正常、IPv6 不行(后来确认是两版都有这个坑,先修的 v4 后对称修 v6)。根因就是 3.2 讲的 Toeplitz 非对称:最初按出向包的 sport 字段位反算(v4 offset=64、v6 offset=256),结果出向包落对了队列、回包 SYN-ACK 落错队列,握手当然完不成。
修复(IPv4 commit c42340d5,IPv6 对称移植 R-G):把 helper offset 改到回包 dstPort 字段位——v4 64→80、v6 256→272,tuple 按回包字段序填充,复核也按回包字段序调 ff_rss_check。修复后物理机端到端验证:v6 多队列主动 connect 的回包 100% 落本进程队列、0 落错,IPv4 零回归。
4.6 问题三:add_helper 改写 key 导致三方 key 不一致(R-F)
修复 offset 后单测里发现一个更隐蔽的问题:thash 反算的”单候选等价率”只有 ~22-27%(意味着反算出的端口大概率过不了软算复核,得重试 3~6 次)。排查到最后发现根因是 rte_thash_add_helper 会用 LFSR 原地改写 ctx->hash_key——于是 rte_thash_adjust_tuple 用改写后的 key 反算,而 ff_rss_check 软算和网卡硬件用的是原始 key,三方 key 不一致,那 22-27% 纯属巧合命中。
修复:ff_rss_thash_build_key 在 dev_configure 前串行构造 ctx、发布统一 KEY_FINAL 到全局 rsskey 并编程进网卡,三方对齐后等价率应达 ~100%。
4.7 改造四:recheck 复核默认关闭(R-D)
三方 key 对齐后,反算结果的可信度上来了,那道”反算成功后强制软算复核”的保险丝就成了纯开销——microbench 实测单次 ff_rss_check 复核约 99.4 ns/call,而 recheck=0 的热路径只要 ~0.31 ns/call,差了约 300 倍;换算到每连接(平均 3.9 次 adjust 调用)约省 390 ns,v6 reta=512 长尾场景每连接能省约 2 us。
于是把复核做成运行时开关 recheck(config.ini [rss_check] 段),默认 0(性能优先),debug/运维时开 1 维持零容忍硬门。失败兜底链(attempts 用尽 → 软算扫描)不受影响。
4.8 改造五:bind-then-connect 端口延迟分配(R-E)
还有一个漏网路径:应用先 bind(local_addr, 0) 再 connect(remote)。原生 FreeBSD 在 bind 阶段就分配了匿名端口,connect 时发现”端口已经有了”就绕过了 RSS 选端口逻辑,选出的端口不落本队列。这正好对齐 Linux IP_BIND_ADDRESS_NO_PORT 的语义——端口推迟到 connect 按完整四元组分配。
修复(commit ff9e3c449,+16/-1,全宏门控):v4 的 in_pcbbind 入 hash 块加 lport != 0 门控、in_pcbbind_setup 的端口分配加 #ifndef FSTACK 门控;v6 对称改造。bind 阶段不固化端口 → connect 天然进 RSS 选端口分支。另有一个有意思的坑:nginx 会先调 setsockopt(IP_BIND_ADDRESS_NO_PORT),这个选项的 Linux 数值 24 恰好撞上 FreeBSD 的 IP_BINDANY=24——v4 被静默误设成透明代理、v6 直接 EINVAL。在 syscall 转换层拦截(commit a2537e143)后彻底解决。
4.9 测试与验证情况
- 单测:39 run / 36 PASSED / 3 SKIPPED(3 个 SKIPPED 是 DPDK EAL 在单测环境无法 init 的既有降级),v4/v6 full-loop 落队列 100% 硬断言全过
- 真机(R-A 软算路径):primary/secondary 各 200 connect,200/200 落本队列
- 物理机(v6 reverse-path):具备真实 v6 RSS 能力的网卡上端到端通过,0 落错
- 本机 virtio
reta_size=0:thash ctx 无法初始化,真机上走的是软算降级路径(这恰好验证了降级链的正确性),thash 路径的正确性由单测 reta=128/512 全量覆盖
5. 如何使用、如何配置、使用效果
5.1 配置
config.ini 的 [rss_check] 段(示例):
[rss_check]
# 总开关:1=启用静态 RSS 表选端口,0=关闭(默认)
enable=1
# debug 开关:1=thash反算成功后强制软算复核(默认 0,性能优先)
recheck=0
# thash 反算开关(与静态 RSS 表的 enable 解耦):1=多队列下启用反算(默认),0=只走软算扫描
thash_adjust=1
# 静态表规则:<网卡端口ID> <本地地址> <远端地址> <远端端口>,多条用分号分隔
rss_tbl=0 192.168.1.1 192.168.2.1 80;0 192.168.1.1 192.168.2.1 443
静态表规则建议配好常用的 upstream(远端地址+端口),命中率越高收益越大;同一 saddr/sport 二元组最多 16 个、同组最多 4 个 daddr,超出的配置被忽略。
5.2 使用效果
静态表路径(官方实测,e54aa4317 时代数据):
| lcores | 原始动态 QPS | 静态表 QPS | 提升 |
|---|---|---|---|
| 1 | 38,093 | 38,456 | +0.95% |
| 2 | 73,566 | 75,009 | +1.96% |
| 4 | 139,205 | 142,325 | +2.24% |
| 6 | 196,471 | 202,068 | +2.85% |
| 8 | 201,823 | 276,368 | +36.94% |
| 12 | 371,362 | 394,151 | +6.14% |
| 16 | 398,376 | 552,894 | +38.79% |
常规场景 2~6%,8/16 进程这种”原始实现随机重试爆炸”的场景 35%+。
thash 反算路径(本仓库实测):
- recheck=0 热路径 ~0.31 ns/call vs recheck=1 的 ~99.5 ns/call(microbench,约 300 倍差距)
- 每连接省约 390 ns(v4)、v6 reta=512 长尾省约 2 us
- full-loop 落队列 100%(单测硬断言),错队列零容忍在 recheck=1 下由软算复核守护
5.3 注意事项
- 静态表与 thash 反算是”加速层”,最终正确性由软算兜底链保证,任何一层失败自动降级,不需要手动干预
- 在不支持RSS的环境(如本机 virtio 网卡) reta_size=0,thash 反算在真机会自动降级为软算——这是设计行为不是 bug
6. 延伸阅读:
- spec:docs/ff_rss_check_opt_spec/zh_cn/(00-10 + plan,五项需求 0.1~0.5 的完整设计与验证)
- 官方初版博客:https://mp.weixin.qq.com/s/x5wWecqEKWGdcVbhne78tw
- 官方 wiki:ff_rss_check() Optimization(对应 commit e54aa4317)
- DPDK Toeplitz Hash Library:https://doc.dpdk.org/guides/prog_guide/toeplitz_hash_lib.html
- 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md(ff_dpdk_if.c 一节)