F-Stack 2.0 前瞻9 :Nginx 优雅重载支持,从「reload 必断流」到两代进程共存的分流架构

本篇文章是F-Stack 2.0 前瞻系列的第十篇,也是最后一篇,2.0 版本将在几天内正式发布。

本篇的 Nginx reload 功能在当前的 F-Stack 架构下相对来说非常复杂的,单独 spec 架构设计文档就 review 修改了很多轮,开发、功能完善、bug修复、测试、审核同样进行了很多轮,预计 token 使用量在百亿左右(Codebuddy + HY4 preview/GLM-5.3/Opus-5/Opus-5.5/GPT-6-Astra),总算达到了算是基本完善的版本,当然肯定还是会存在一些未知 bug 或遗留问题的,非常欢迎各位开发者试用并提出发现的问题,如果直接提交修复 PR 则更加感谢。

1. 本功能主要作用和特点

在历史版本上,F-Stack Nginx 一直不支持优雅重载,-s reload 无论怎么调都会造成短暂服务中断,原因其实也不复杂:F-Stack 的 Nginx master 进程本身就是 DPDK primary,独占网卡;reload 一来 worker 全部退出重建,进程更替的空档里网卡队列没人收包,流量必丢。

有不少开发者也希望支持(可以参考 issue #528(重复 #1036)的历史回复),但是一直没有实际去做。社区里唯一的先例是 #547 里的那套 DPDK 18.11 时代的专用接收核补丁,和现在的版本架构早就对不上了,目前也并未开放到社区,回退版本使用也存在一定的开发门槛。

这次把 reload 整个补齐了。在配置文件中开启graceful_reload=1 之后:

  • HUP 无损 reload:新旧两代 worker 并存,新代接管网卡收包并逐包分流,旧代继续服务存量连接直到排空退出。TCP 长传输跨 reload md5 不变、0 停顿;UDP 新流立刻归新代,旧流留在旧代直到空闲
  • USR2 二进制升级 + WINCH:换二进制文件发版也走同一套交接协议,旧 master 的 worker 在活跃 UDP 流排空前先继续提供服务,不会一交接就把旧流扔下
  • 反向代理对称支持:两代主动连上游的临时端口按奇偶分代,新代发起的 TCP/UDP 上游连接,应答不会被误送给旧代
  • KNI/内核共存不受影响:绑内核端口的流量经 KNI ring 由归属代 worker 送内核,reload 前后 veth、SSH、控制面照常工作
  • 可观测:master 打每一步 FSM 迁移和完成统计,worker 打排空与 UDP linger 日志。

关键词:常驻 slim primary(网卡不再跟着 Nginx 重启)、按代分流(软件流表 + UDP 发布表决定每个包归谁)、有限收敛(排空有硬上限,不会无限等下去)。

2. 本功能的主要适用场景

2.1 长连接业务的高频发布

推送、IM、网关 keepalive 这类业务最怕 reload:原生 F-Stack 一 reload 全断重连。两代共存后存量连接不断,新配置对新建连接立刻生效。实测多条并发流跨 HUP,md5 全部一致、0 停顿。

【注1】当前如果重载时的流量压力特别大的话不能保证所有流100%不中断,还是可能会存在部分流中断或失败,建议先降低负载再进行 reload 操作。

2.2 反向代理

proxy 场景有个隐蔽的坑:新代主动连上游,SYN-ACK 回来在流表里查不到,被当成旧流转给了旧代,窗口内新建上游连接全部 504。UDP 代理更惨,修复前 worker 在第一个代理数据报上就 SIGSEGV。现在 TCP/UDP 的临时端口都按代奇偶划分,两代上游四元组不会撞,各自的应答各回各的。

【注2】本地主动外访的本地源端口新旧进程可能选择到相同的源端口导致旧流的流量也路由到新 worker 上导致异常,当前是按代奇偶划分选择本地源端口的方案,但源端口可选范围会降低一半。另一种可选的方案是重载时导出旧 worker 上所有在用源端口到新的 worker 上,选到旧 worker 在用端口则重选。

2.3 DNS / UDP 服务,给 QUIC 打底

UDP 没有 SYN,没法照抄 TCP 的流表判断方法,单独做了一套「发布表」机制。DNS 这种一问一答的业务 reload 无感;持续发包的 UDP 流在窗口内保持归属,直到空闲或到超时上限。支持了 UDP 则有了对 HTTP/3 的支持的基础,但目前仅是简单的四元组分流,尚未支持连接 ID 路由等功能,对 QUIC 必然还存在一些适用范围的限制,目前写进了文档,留待后续版本支持和测试。

2.4 二进制热升级

改了代码要发版,USR2 + WINCH 走同一套交接协议,升级期间服务不断。但也有个限制要注意:老 master 还活着时,新 master 会拒绝继续 HUP,日志写明原因——不挡这一下,两代变三代,类似端口奇偶这类不变量就全乱了。

2.5 不太适合的场景

  • 指望 QUIC 连接迁移 / NAT 重绑定后还保持旧连接:四元组一变就归新代,原连接断开;CID 路由没做
  • 依赖 IP 分片的大 UDP 应答:分片报文一律留在新代(和 TCP 的处理一致)
  • 想把 reload 完成时间精确控制在亚秒级:旧流没排空时,完成时间由旧连接何时结束决定,上限是 worker_shutdown_timeout(不配默认 90 s)

3. 本功能的架构特征

3.1 进程模型与共享结构
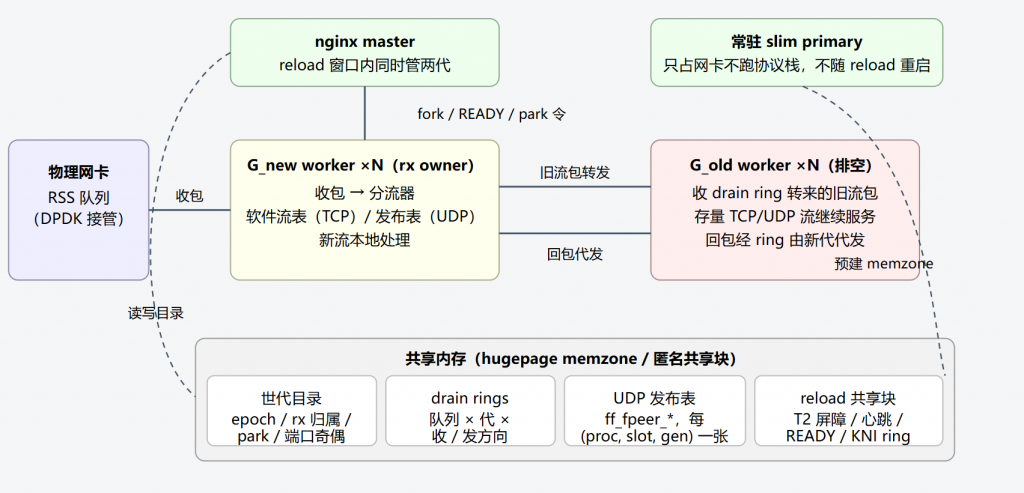
几件事还需要单独注意一下:

  • slim primary 只占 PCI 设备、不初始化协议栈,Nginx 的所有进程(master 和 worker)都是 secondary。reload 只动 Nginx 自己,primary 原地不动,网卡队列永远有人
  • primary 不是无脑常驻:按 pid/comm 判活复用,同时比对启动时的配置摘要。设备侧配置(网卡绑定、队列数、mtu_enable 这类)变了,说明复用不安全,HUP 直接拒绝并给出原因
  • 世代目录(ff_reload_gendir,hugepage memzone)是跨 master 的协调点:epoch 单调递增、4 个槽位记录每轮升级的 master、rx 归属字、端口奇偶标记都放在这里。HUP 是同一个 master 内两代交替,USR2 是两个 master 各占一个槽,两套场景共用一份结构

3.2 HUP 的六步状态机

master 侧把一次 reload 建模成 T0~T5 的状态机:
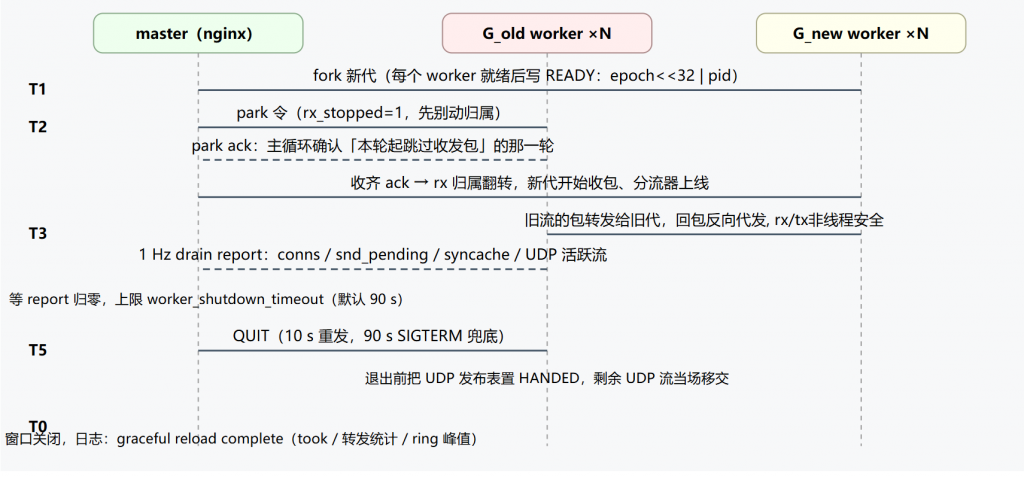
T2 是整个交接里最重要的一步。master 下 park 令之后不能直接翻归属,必须等旧代每个存活的 worker 在自己的主循环里确认「这一轮开始跳过收发包」并 ack——没有这个屏障,网卡队列可能出现两个消费者,或者一个都没有。另一个配套机制是心跳:rx owner 每轮主循环递增共享块里的 heartbeat,其他进程采样它就能发现接收方卡死(reload_heartbeat_timeout_ms),不至于对着一个假 owner 空等。

3.3 分流器:每个包归谁

窗口打开后,新代 worker 的收包路径先进分流器(ngx_ff_flow_map_dispatcher),TCP 和 UDP 走两套规则:
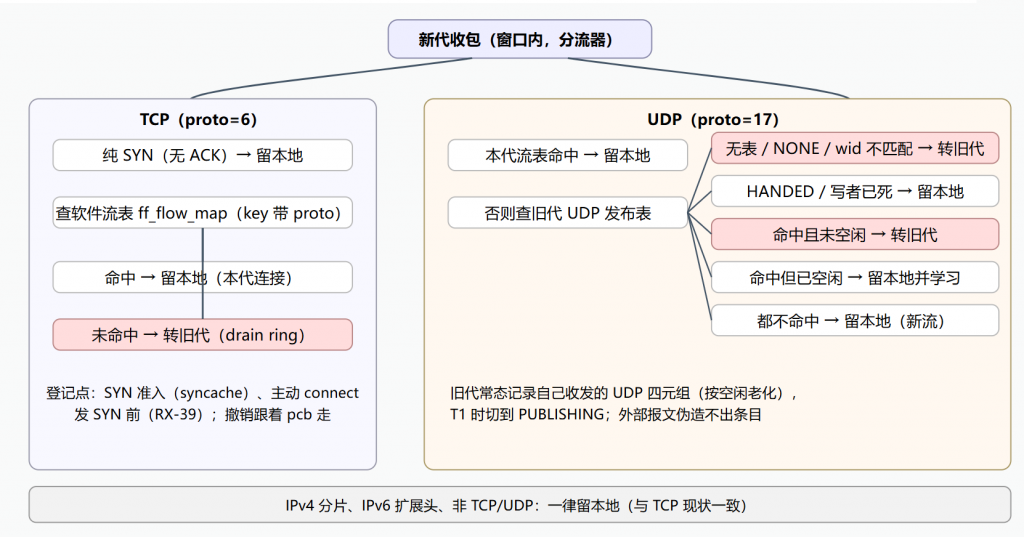
TCP 这套在初期版本有个问题:流表只有 syncache 一个登记点(被动建连),主动 connect 发出的 SYN 没人登记,上游回的 SYN-ACK 查表 miss 被转给旧代,窗口内新建上游连接全 504。修法是主动 connect 在发 SYN 前登记、撤销跟着 pcb 走(RST/关闭/drop 都覆盖),再加上两代临时端口按奇偶划分,四元组从根上就不会撞。

UDP 没法照抄:没有 SYN,也没有可靠的「新流」信号,而且 G_new 的流表里只有本代的条目,服务端的新旧判断需要的是「旧代有什么」。所以反过来做——旧代把正在服务的 UDP 四元组发布出来,新代查这张表决定转还是留。表头是个三态机:

进程挂接     → NONE         还没开始:新代按老行为转发(对端是旧二进制时就是这个状态,兼容)
窗口开始(T1) → PUBLISHING   常态记录的四元组整表可见;表头带窗口身份 wid,防上一轮的旧表被误认
进程退出     → HANDED       新代此后全部本地处理,不再转给退出中的旧代

条目按 reload_udp_idle_ms 空闲老化(默认 10 s):一条流只要还在收发包就一直续着;旧代已经没人在服务的流,空闲到期后新代本地接管并学习进本代流表。

3.4 排空怎么收敛

旧代每秒上报一次 drain report:TCP 连接数(UDP socket 不再计入,否则配了 listen ... udp 每轮 reload 都被钉死在 deadline)、发送队列积压、半开连接数,再加上发布表里未老化的 UDP 流数。master 的 T3 等这个数归零,上限 worker_shutdown_timeout(不配默认 90 s),到点强制推进,剩余 UDP 流当场移交。USR2 没有 master 侧 T3,走 worker 自己的 linger:交接后旧 worker 收到 QUIT 时如果还有活跃 UDP 流,先留着监听继续服务,流空闲或到上限(配了 worker_shutdown_timeout 取该值,否则 30 s)再走退出流程。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 把 primary 从 Nginx 里拆出来

这是整个功能的地基。原生的模型是「Nginx master 即 DPDK primary」,worker 是 secondary——master 一退出,网卡就没人管了。改造后多出一个常驻的 slim primary:只做 DPDK EAL 初始化、占住 PCI 设备、建好共享 memzone(drain ring、世代目录这些都归它预建),协议栈一概不碰。Nginx 的 master 和全部 worker 都是 secondary,进程随便杀随便换。

配套的东西不少:secondary 直接引用 primary 地址的指针转换(fp/gp/va 三套布局)、primary 按 pid/comm 判活复用、启动配置摘要比对(设备侧 key 变了必须整体重启)、以及 Nginx -s stop 时连带停掉 primary,不然它就成孤儿了(人工测试验收发现的问题,这里不具体展开了)。

4.2 交接屏障、READY 和心跳

T2 的 park 屏障前面说过,这里再补充两个细节。一是新代 worker 起来后要写一个 READY 字(epoch 高 32 位 + pid),master 等所有worker的 READY 等齐了才进入 T2——listen 都没建好的新代接管网卡就是事故。二是心跳:rx owner 每轮主循环加一,采样方发现心跳停了就不等它,按异常路径走。这两个都是「不信任对端一定活着」的防御兜底机制(一般是中止重载,保持或回退到旧 worker 继续服务),整个 reload 过程中里这类防御到处都是,毕竟两个 master 十几个进程谁崩了都不能把别人拖死。

4.3 问题一:主动 connect 的回包被转给旧代

现象是反代场景窗口内新建上游连接 100% 超时,error.log 里一片 upstream timed out (110: Connection timed out) while connecting to upstream。抓包看很清楚:上游 SYN、SYN-ACK 都在,但 SYN-ACK 之后代理侧没有任何回应——SYN-ACK 带着 ACK 位,被分流器当成「已建立的旧流」转给了旧代,而旧代的流表里同样没有它,包进了旧代黑洞。修复就是 3.3 里说的主动登记 + 端口奇偶,外加一条防线:老 master 还在时新 master 拒绝 HUP,防止三代并存破坏奇偶不变量。修复后窗口内 20/20 请求 200,上游端口奇偶 0→1 干净分代。

4.4 UDP 的三个坑

设计上借鉴了 Cloudflare udpgrm 的 FLOW 模式(旧实例在收发路径登记、条目老化、查不到的流给新实例),也记住了 Envoy hot restart 的教训——它把窗口内的新 UDP 包全经父进程转发,envoy#47833 记录过这条转发通道阻塞导致父子进程互相死锁。所以这里只转发「旧代已发布且活跃」的流,新流一律本地,转发面收得越小越好。实现过程中被三任审核各打回来一次,三个坑都值得记:

坑一:只在发布期记录,第二轮 HUP 的表是空的。 最初的设计是「窗口开始(T1)才记录」,T1 时顺带快照一次存量会话。实测第二轮 HUP 时 T3 只用了 1 秒就宣布排空完成,长流被提前移交。原因是第二轮的旧代在上一轮是「新代」,它服务的流都是经分流器本地的,而 UDP 的 return 会话一问一答即结束,快照抓不到东西;T1 之后第一个报文到来之前,活跃流数就是 0。改成常态记录:worker 挂接后每个 UDP 收发包都记(哈希加最多 32 次探测,约 256 KB 的表),T1 只把表头切到 PUBLISHING。代价是 graceful 模式下常态每包多一次哈希,换来的正确性值得。

坑二:跨进程比时钟,无符号差把「未来」判成「已老化」。 写者(旧代)和读者(新代)各自在自己主循环开头取一次 CLOCK_MONOTONIC 毫秒。写者这轮的取样经常比读者晚 1 ms 左右,于是读者算 now - last 得到 0xFFFFFFFF,无符号比较大于任何超时,活跃流被当成已老化、直接被新代抢走。改成有符号差 (int32_t)(now - last) > (int32_t)idle,顺手把配置上限压到 1 小时防止真溢出。单测里专门加了一个「写者晚 5 ms 仍判活」的用例。

坑三:park 令把发布开始的门关上了。 USR2 多 worker 场景,旧 master 发现新 master 后下 park 令;某个兄弟 worker 把目录里的 rx_stopped 置 1 之后,还没开始发布的 worker 一看「我不是 rx owner 了」,按原来的门控(还持有 rx 才开始发布)就永远不发布了——它会照常 ack park,但表停在 NONE,新代只能按老行为转发。根因是「还持有 rx」这个判定把 park 令也算进去了。改成只看 block 里的 rx_owner_gen 是否已经翻转:park 是「准备交」,翻转才是「真的交了」,ack 那一轮之前开始发布是完全安全的。

4.5 UDP linger 和既有上限叠加,排空最长翻倍

最早的写法是 QUIT 来了先 linger 等 UDP 流,linger 结束再走原有退出流程——而原有流程里 shutdown timer、监听关闭(30 s cap)、发送队列等待是各自起算的。叠起来最坏情形接近两倍上限,master 那边 T5 的 90 s SIGTERM 都可能先到。改成一份预算:linger 开始就启动 shutdown timer(之后不再重复启动),linger 结束进入退出流程时,监听关闭和发送队列的起算点回拨到第一次 QUIT 的时刻。USR2 的 linger 上限也和 worker_shutdown_timeout 对齐,同一时刻到期。

4.6 顺手修的原有的 UDP 反代 crash 问题

stream udp 反向代理修复前根本跑不起来:ngx_udp_sendmsg_chain 里 F-Stack 改过的条件先取 c->listening->belong_to_host 再判 c->listening 是否为空,而经 ngx_event_connect_peer 建立的上游连接没有 listening,第一个数据报就 SIGSEGV。gdb 栈一行定位,三处(sendmsg chain 一处、QUIC 输出两处)统一改成先判空。这个 bug 在 F-Stack 的 Nginx-1.28 移植里从合入起就在,只是没人用 UDP 代理所以没炸过。

4.7 测试矩阵

25 个集成用例(harness test_graceful_reload.sh),reload 相关的核心几个:rt01/rt02(TCP 长传输跨 HUP,md5、停顿计数)、rt12(KNI 管理面)、rt25(循环 HUP)、rt27~rt29(primary 复用/停止/MTU 拒绝)、rt32(TCP 反代)、rt33(UDP 服务端,2 worker,v4+v6)、rt34(UDP 反代)、rt35(USR2+WINCH)。单测覆盖流表 key 的协议隔离、发布表的记录/查找/老化/时钟回绕、端口奇偶、HUP/USR2 的开始与放弃条件。修复前后的对照数据都存了档,第 5 节挑重点列。

5. 如何使用、如何配置、使用效果

5.1 配置

f-stack 配置(config.ini / f-stack.conf):

[dpdk]
lcore_mask=7         # 注意:primary_slim=1 时需要比 worker 数量多配置一个 lcore,只要配置两个lcore
​
graceful_reload=1     # 总开关,缺省 0,行为与旧版完全一致
primary_slim=1       # 必须,常驻 slim primary(graceful 的前提)
reload_udp_idle_ms=10000 # UDP 流空闲多久算结束:100..3600000,默认 10000
                    # 改它不用重启 primary(不在配置摘要里)
[port0]
lcore_list=1,2       # 注意:primary_slim=1 时需要多配置跳过 primary 所在的 lcore
​
[kni]
owner_proc_id=1       # 注意:开启 kni 且 primary_slim=1 时需要配置接管 kni 包代发的子进程 ID

Nginx 侧建议配一个 worker_shutdown_timeout,它同时是 HUP 的 T3 上限和 USR2 的 linger 上限,不配默认 90 s,多数场景太长:

worker_shutdown_timeout 25s;

UDP 服务和 UDP 代理就是标准 stream 写法,没有新增指令:

worker_processes  2;              # worker 数量为 f-stack.conf 配置的核心数减1
​
stream {
   server {
       listen 5353 udp;          # DNS 类一问一答
       return "pid=$pid";
  }
   server {
       listen 5354 udp;          # UDP 反代到上游
       proxy_pass <UPSTREAM_IP>:53;
       proxy_responses 1;
       proxy_timeout 5s;
  }
}

5.2 日常操作与日志

nginx -s reload                    # HUP:日常配置变更,无损
kill -USR2  $(cat Nginx.pid)       # 二进制升级:新 binary 接管
kill -WINCH $(cat Nginx.pid.oldbin)# 旧 master 的 worker 开始排空
Nginx -s stop                      # 停止(常驻 primary 一并退出)

master 的 error.log 会把整个过程说清楚,几个关键行:

graceful reload fsm: T2_HANDOVER -> T3_DRAIN (transition 3, elapsed 155 ms)
graceful reload complete: generation 1 now active (took 1297 ms: handover 1 ms,
  drain 1000 ms, drain forwarded 41 / relayed 41 pkts, ring peak rx 0 / tx 0)

worker 侧的排空与 UDP 日志:

ff drain: started (drain generation, conns=0 syncache=0)
reload: publishing UDP flows (HUP), 3 in the snapshot
reload: UDP dispatch: 258 forwarded, 2 kept, 0 taken over, 0 without a peer table
ff drain: UDP linger over after 18200 ms, 0 flow(s) still active

排空卡住时看 T3 stalled 日志(conns/snd_pending/syncache 各是多少一目了然),UDP 则看发布表还剩几条活跃流。

5.3 使用效果(实测)

项修复前修复后
rt33 UDP 服务端:窗口内新流归属(2 worker,v4/v6)8 条新流 6 条被旧代应答新流 240/240 全新代,旧流 592/592 全旧代,0 丢包
rt33 reload 完成时间每轮都钉死在 90 s deadline旧流空闲后 15 s 完成(配的上限 25 s);不停发的长流到上限移交一次、0 丢包
rt34 UDP 反代worker 在第一个代理数据报上 SIGSEGV(约 3 s 内 8 次)上游端口奇偶 0→1 分代,旧流 493/493、新流 120/120,26 s 完成
rt35 USR2+WINCH交接后新流 24/24 无应答,旧流丢 63/259新旧分干净、0 丢包;旧 worker linger 18.2 s 后 0 流退出
rt32 TCP 反代窗口内新建上游连接全 504窗口内 20/200,上游端口奇偶 0→1
rt01/rt02 TCP 长传输—跨 HUP md5 一致,36 流 0 停顿
回归—25 用例全绿,含 KNI 管理面(rt12)与 IPv6

5.4 限制与建议

  • 临时端口常态减半:graceful_reload=1 时两代共存要求 TCP/UDP 临时端口按奇偶分代,每代可用约一半(默认范围约 2.7 万/目的四元组),显式 bind 端口不受约束。端口用量极大的业务要评估
  • QUIC 连接迁移 / NAT 重绑定:四元组一变就归新代,原连接断开;要做 CID 路由是后续工作
  • IP 分片、多播/广播、ICMP 差错:窗口内一律由新代处理,包括旧代已连接上游返回的分片大应答(比如大 DNS 应答)
  • UDP 发布表容量:每进程 16384 项,探测窗口内找不到空槽的流不记录(计数为 not recorded),窗口内按新流处理。一问一答的 DNS 不受影响;超高并发长活 UDP 流要留意
  • 写者判活有约 1 s 粒度:旧代崩溃后,新代最多 1 s 内还往它转;旧代被 SIGKILL 留下的表由同坐标后继进程复位
  • 多 worker 反代依赖 RSS:上游回包要落回发起 worker 的队列,没有 RSS 的机器反代只能单 worker 跑(服务端多 worker 不受影响)
  • 建议:UDP 业务都配上 worker_shutdown_timeout,收敛时间可控;DNS 类一问一答不需要任何特殊配置

6. 延伸阅读:

  • 方案设计与问题登记(中文,权威):docs/Nginx_reload_spec/zh_cn/06-solution-design.md(§10.5 TCP 主动登记、§10.9 RX-39、§10.10 RX-40/RX-41)
  • 测试矩阵与全部实测数据:docs/Nginx_reload_spec/zh_cn/08-testing.md
  • 用户手册(graceful 模式行为与限制):doc/F-Stack_Nginx_APP_Guide.md
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md、03-LAYER3-FUNCTIONS.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 相关 issue:#528 / #1036(官方确认 reload 不支持)、#547(DPDK 18.11 接收核补丁)
F-Stack 2.0 前瞻8 :用户态/协议栈间的零拷贝,从魔改到 FreeBSD 原生 sosend 对称架构

1. 本功能主要作用和特点

本篇只讲 F-Stack 的用户态与协议栈之间一直有的”最后一公里”的内存拷贝问题,不涉及其他层的零拷贝,这篇把零拷贝从 2018 年到 2026 年的演进捋一遍——早期双向都有内存拷贝,2022 年有了发送方向的魔改方案,2026 年 6 月终于收敛成”双向对称、纯原生”的完整用户态零拷贝栈。

拷贝发生在哪先搞清楚。数据包在服务器的处理分接收和发送两个方向:

  • 接收方向:网卡 → DPDK hugepage 是 DMA,天然零拷贝;但应用调 ff_read() 把数据从协议栈 mbuf 搬到用户 buffer 有一次拷贝(issue #407 官方确认,这是设计如此)
  • 发送方向:有两处拷贝——应用层调用 socket 发送接口时数据从应用层拷到 FreeBSD 协议栈(应用 → 协议栈),以及协议栈把数据拷到 DPDK rte_mbuf(协议栈 → 网卡)

2026 年 6 月之前,F-Stack 零拷贝的版图是这样的:接收方向零拷贝(FF_ZC_RECV)只有空接口,未实际实现,在2026-06-11通过FreeBSD源生接口实现了接受方向零拷贝的实际实现(commit b87f5f0d2);发送方向零拷贝(FF_ZC_SEND)用的是 FSTACK_ZC_MAGIC 哨兵 + m_uiotombuf 内核魔改的 workaround——能跑但有 GPF 风险、大数据量发送 crash、FreeBSD 升级时维护成本高。2026-06-12 的原生化重构(commit b6ce5884c)把发送方向也换成了 FreeBSD 15.0 原生的 sosend(top) 路径,至此形成完全对称的双向零拷贝栈。几个关键词:

  • 双向对称:ZC-send(kern_zc_sendit + sosend top)与 ZC-recv(kern_zc_recvit + soreceive mp0)在内核入口、用户态 API、生命周期、错误路径、ABI 增量五个维度全镜像
  • 纯原生:直接复用 FreeBSD 15.0 上游能力——sosend(9) 手册原文就写着”Data may be sent as an mbuf chain via top, avoiding a data copy”,f-stack 只是补了一个把 top 贯通进 sosend 的入口
  • 拆除魔改:FSTACK_ZC_MAGIC 哨兵 + m_uiotombuf 魔改共 17 处触点全部拆除,m_uiotombuf 回归 vanilla 15.0 版本,内核 patch 从”5 处魔改”变成”只新增 1 个函数”

2. 本功能的主要适用场景

2.1 大块数据收发场景

这是零拷贝最实在的收益场景。M2 实测已经证明:小包 echo(256B 请求/438B 应答)下 ZC 与普通 read/write 持平——小请求的 uiomove 拷贝开销相对 TCP 处理 + syscall + 调度可以忽略,且 f-stack 用 UIO_SYSSPACE,uiomove 本就是同地址空间 memcpy,已经很廉价。真正的收益在 4KB/64KB/1MB 级 payload:大文件下载、大 body POST、块存储类业务。

2.2 代理转发场景(收到即转发)

转发类应用(代理、网关)收到数据后原样发出去,传统路径是 recv 拷进用户 buffer 再 send 拷回协议栈,两趟拷贝;ZC 路径下 recv 拿到 mbuf 链、send 直接投递 mbuf 链,全程零拷贝。这是 spec 里明确标注的优先收益场景。

2.3 与 FF_USE_PAGE_ARRAY 的关系(要说清)

FF_USE_PAGE_ARRAY 是 2020 年 PR #364 贡献的”协议栈 → DPDK”方向零拷贝(mmap + mlock + virt2phy 查找),与这篇讲的应用层零拷贝是两段不同的拷贝。它至今仍是实验性特性:issue 档案确认它在 i40e 下会静默丢包,官方不建议启用;Phase-2 实测还触发过 panic(F-A1,已修复为 soft drop)。三者开关完全独立,可任意组合。

2.4 不太适合的场景

  • 小包 echo 类负载:实测零收益,直接开还会多一层 API 复杂度
  • 依赖增量编译的快速迭代环境:FF_ZC_* 开关切换后必须 make clean,否则会踩 M2 的 http=000 坑(见 4.3)
  • 期待性能翻倍的:2022 年官方公众号文章就说过,性能提升”并不一定很明显,比如只有 2-3% 左右的提升”——零拷贝省的是 memcpy,不是协议栈本身的开销

3. 本功能的架构特征

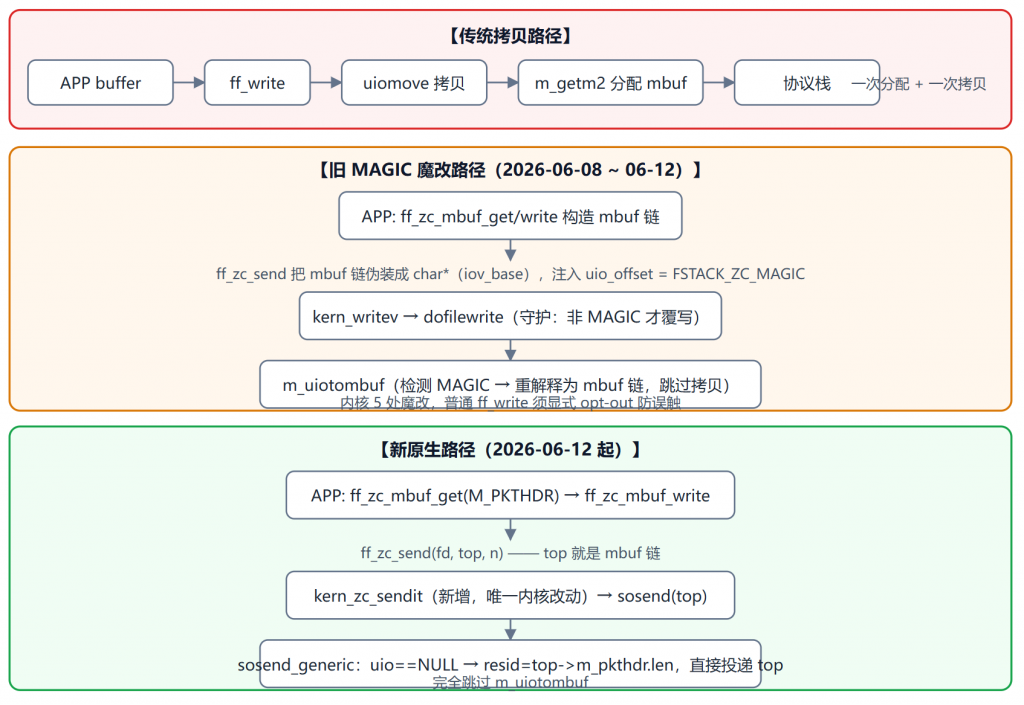
3.1 三条发送路径对比(核心图)

新方案没有 magic、没有 uio_offset 透传、ff_write/ff_writev 不需要 opt-out。sosend 全段经过实测确认无任何 FSTACK_* 宏——这是 FreeBSD 上游原生能力。

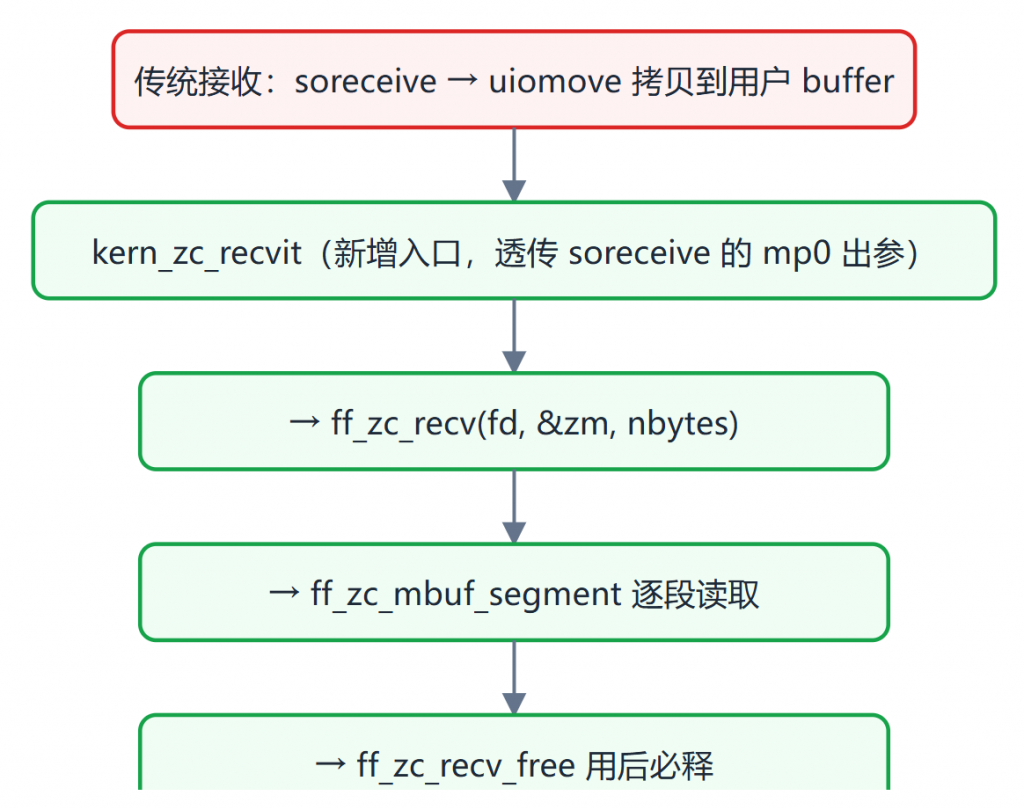
3.2 接收方向对称结构

3.3 双向对称表(五维镜像)

维度ZC-recv(已落地)ZC-send(原生化后)
内核入口kern_zc_recvit → soreceive(mp0)kern_zc_sendit → sosend(top)
原生机制soreceive 的 mp0!=NULL 分支sosend 的 uio==NULL && top!=NULL 分支
长度来源uio->uio_residtop->m_pkthdr.len
绕过点uiomove 拷贝m_uiotombuf 分配+拷贝
用户态 APIff_zc_recv / ff_zc_mbuf_segment / ff_zc_recv_freeff_zc_send / ff_zc_mbuf_get / ff_zc_mbuf_write
ABI 增量+3 符号0 符号(只改实现)

两边共享同一个 struct ff_zc_mbuf(bsd_mbuf/bsd_mbuf_off/off/len 四字段),字段语义对称复用。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 早期方案回顾(2018~2022,最早期文档到现在版本的区别)

2018 年的基线(issue #407):接收方向网卡到 hugepage 零拷贝、但 ff_read() 有拷贝;发送方向”是拷贝的”。

2020 年 PR #364(@jinhao2)补了第一段:FF_USE_PAGE_ARRAY,协议栈 → DPDK 方向零拷贝。思路是初始化时 mmap 256MB(memsz_MB 可调)+ mlock 锁物理内存,维护虚拟地址→物理地址页表,协议栈 mbuf 数据地址落在池内时直接把物理地址填给 rte_mbuf 的 buf_addr/buf_physaddr,不拷贝;用长度等于 NIC tx_queue_length 的循环队列保证释放安全。这个方案对应用透明,但对 ixgbe 有效、i40e 下静默丢包,至今官方定位仍是”从未正式启用的实验特性”。

2022-04-15(commit e12886c/021aaded)补了第二段:FF_ZC_SEND,应用 → 协议栈方向零拷贝。ff_zc_mbuf_get() 用 m_getm2 分配 mbuf 链当应用缓存、ff_zc_mbuf_write() 直接写进 mbuf、ff_write(fd, zc_buf.bsd_mbuf, len) 时在 m_uiotombuf 里直接采用传入的 mbuf 链跳过拷贝。配套公众号文章《F-STACK发送零拷贝介绍》如实说明:预期性能提升约 2-3%,”需要结合实际场景测试”。

4.2 M8 重新点亮:FSTACK_ZC_MAGIC 哨兵方案(2026-06-08)

FreeBSD 13→15 升级的 Phase-2 把 FF_ZC_SEND 在 15.0 基线上重新点亮(commit add33a04a)。13.0 时代的直传方式在 15.0 下有了变化,落地成了哨兵方案:ff_zc_send 把 mbuf 链伪装成 char* 塞进 iov_base,同时往 uio->uio_offset 注入魔数 0xF8AC2C00F8AC2C00;dofilewrite 里加守护(非魔数才覆写 offset);m_uiotombuf 里加消费点(检测到魔数就把 iov_base 重新解释为 mbuf 链)。内核 5 处魔改,普通 ff_write/ff_writev 必须显式 uio_offset=0 opt-out 防止撞上魔数。

这个方案从落地第一天就带着三个包袱:M8 阶段曾因 opt-out 缺失直接 GPF(ff_syscall_wrapper.c:1146 的 RCA);issue #712(2022-11-01 至今 OPEN)大数据量发送 crash/hang 无解;每次 FreeBSD 升级都要重新审计 m_uiotombuf 周边约 120 行。

4.3 问题一:增量编译陷阱,http=000(M2 教训)

2026-06-11 做 ZC-recv 的 M2 实测时,首轮 curl 全部 http=000,一度误判为环境问题。实际调试定位到真凶:先做了无 flag 的 baseline build,再 FF_ZC_SEND=1 make,uipc_mbuf.c 没改过、它的 .o 比 .c 新,make 按时间戳跳过重编译——m_uiotombuf 里的 MAGIC 消费 hook 缺失(objdump 验证 magic 不在 uipc_mbuf.o 里)。后果:ff_zc_send 设了魔数但内核 hook 不识别,mbuf 链指针被当 char buffer 处理,应答崩坏。删 stale .o 重编译后 http=200 全通。

【注1】这个坑从此进了强制规约:变更 FF_ZC_* 等编译开关后必须 make clean 或删除受影响 .o,make 基于时间戳不感知 CFLAGS 变化。这也是哨兵方案的固有脆弱性——魔改文件越多,stale .o 的组合爆炸面越大。

4.4 ZC-recv 落地与调研转向(2026-06-11)

同一天 ZC-recv 落地(commit b87f5f0d2,M0+M1):新增 kern_zc_recvit 透传 soreceive 的原生 mp0 出参,用户态新增 ff_zc_recv/ff_zc_mbuf_segment/ff_zc_recv_free 三个 API。它只新增不魔改,soreceive 核心零改动。M2 实测(单核 A/B 三档 wrk):T1 −1.1%、T2 ≈ +3%、T3 −1.0%,小包 echo 下与 ff_read 持平(噪声内)——诚实的结论是收益在大 payload 场景,echo 负载体现不出来。

更重要的是,做 ZC-recv 的同时顺手调研了发送侧:FreeBSD 15.0 的 sosend() 签名里一直带着 top(mbuf 链)参数,uio==NULL && top!=NULL 时直接投递 mbuf 链、跳过 m_uiotombuf。调研实测确认 sosend 全段无任何 FSTACK_* 宏(git blame 显示 f-stack 的 delta 不在那里)——上游原生能力一直在,f-stack 的 MAGIC 方案是把 mbuf 伪装成 uio 绕行,属于”非必要重新发明”。缺的只是一个把 top 从用户态贯通进 sosend 的入口(收侧 mp0 被写死 NULL 完全同构,kern_zc_recvit 已经示范了怎么做)。

4.5 原生化重构:kern_zc_sendit(2026-06-12)

方案定了以后一天落地(commit b6ce5884c):新增 kern_zc_sendit(td, s, top, flags) 直调 sosend(so, NULL, NULL, top, NULL, flags, td),同时把魔改全部拆除——17 处触点里,mbuf.h 的 MAGIC 宏、m_uiotombuf 的 ZC 分支、dofilewrite 的守护、ff_write/ff_writev 的 opt-out 共 5 处 DELETE,m_uiotombuf 回归 vanilla 15.0 版本;ff_zc_send 重写为调用 kern_zc_sendit;ff_zc_mbuf_get/write 修复 M_PKTHDR 缺口。

M_PKTHDR 缺口是这个方案的技术前提,值得展开:sosend 的 uio==NULL 分支用 top->m_pkthdr.len 作为 resid(数据长度),而旧的 ff_zc_mbuf_get 用 m_getm2(..., flags=0) 分配的链头不带 M_PKTHDR,ff_zc_mbuf_write 里维护 pkthdr.len 的代码被注释掉了——直接走原生路径会 resid=0 什么都发不出去。修复是两行的事:分配时加 M_PKTHDR、写入时累加 pkthdr.len,但这两行是”原生能力可用”和”静默不发数据”的分水岭。

【注2】ABI 不变性是这次重构的合同:ff_zc_send/ff_zc_mbuf_get/ff_zc_mbuf_write 签名零修改、example/main_zc.c 调用序列零修改(G4 验收条款就是 diff 它 0 行变化)、FF_ZC_SEND 开关名保留但含义从”魔改启用”切换为”原生路径启用”、导出符号不增不减。对已部署项目唯一要求是 make clean 后重编译。

4.6 行为变化(对用户可感知的)

项旧(魔改)新(原生)
大数据(>SO_SNDBUF)发送crash/hang(issue #712)阻塞或非阻塞返 EWOULDBLOCK,调用方自分片
UDP 单包 > MTU行为不定明确返回 EMSGSIZE
普通 ff_write 与 ZC 共存需 opt-out 防误触,曾 GPF无需 opt-out
FreeBSD 升级维护重审计 m_uiotombuf 约 120 行只校验 sosend 签名是否变化

4.7 性能诚实边界

  • 2022 年官方文章:发送零拷贝预期提升约 2-3%,需结合场景实测
  • 2026-06 ZC-recv 单核实测:小包 echo 三档压测与普通 read 持平(噪声内),收益预期在大块数据/代理转发场景
  • ZC-send 原生化性能目标(spec 38):三档 wrk 下 vs baseline 和 vs 旧魔改均 Δ ≤ ±3%(噪声内)——原生化是”等价替换”不是”性能优化”,收益是架构债清零
  • 大 payload(4KB/64KB/1MB)专测是后续工作(spec 已列 P2-P4 场景,旧方案在 P3/P4 有 crash 风险,新方案必须数据完整)

5. 如何使用、如何配置、使用效果

5.1 编译开关(三个,完全独立可组合)

# lib/Makefile
#FF_ZC_SEND=1     # 发送零拷贝(原生 kern_zc_sendit 路径)
#FF_ZC_RECV=1     # 接收零拷贝(kern_zc_recvit 路径)
#FF_USE_PAGE_ARRAY=1 # 协议栈→DPDK 零拷贝(实验性,不建议生产启用)

切换开关后必须 make clean(4.3 的坑)。

5.2 发送零拷贝 API 用法

struct ff_zc_mbuf zc_buf;
​
ff_zc_mbuf_get(&zc_buf, buf_len);          // 申请 mbuf 链缓存(含 M_PKTHDR)
ff_zc_mbuf_write(&zc_buf, data, len);      // 直接写入 mbuf 链,可多次调用
ff_zc_send(fd, zc_buf.bsd_mbuf, buf_len);  // 投递 mbuf 链,跳过拷贝
​
// send 成功后 bsd_mbuf 已被协议栈接管,不得再访问;
// 复用 zc_buf 必须重新 ff_zc_mbuf_get

调用方代码审查要点(spec 39 迁移指南):单次 send 数据量别超过 SO_SNDBUF(否则 EWOULDBLOCK,需自分片);UDP 单包别超 MTU(否则 EMSGSIZE);send 后立刻丢弃 bsd_mbuf 指针(否则 UAF);nbytes 参数要 ≥ 实际 write 累计量(实发长度 = pkthdr.len)。

5.3 接收零拷贝 API 用法

struct ff_zc_mbuf zm;
ssize_t n = ff_zc_recv(fd, &zm, nbytes);
// 逐段读:ff_zc_mbuf_segment(&zm, &seg, &len)
ff_zc_recv_free(&zm);   // 用后必释,否则 mbuf 泄漏

5.4 使用效果

实测数据(2026-06-11,单核 lcore4,wrk 三档,A=普通 read / B=ZC-recv):

档位A req/sB req/sΔ
T1 (-t2 -c10)22,36322,115−1.1%
T2 (-t4 -c100)~31.1k~32.1k持平(噪声内)
T3 (-t8 -c500)28,61528,317−1.0%

小包 echo 下零拷贝没有可测收益——这是设计预期,不是失败。收益场景是大 payload 和转发。

5.5 对使用者的建议

  • 业务是大块数据/转发:开 FF_ZC_SEND + FF_ZC_RECV,用 ZC API 改造收发路径
  • 业务是小包 RPC/echo:别折腾,普通 ff_read/ff_write 就好,实测证明无差别
  • FF_USE_PAGE_ARRAY:官方定位实验性、i40e 丢包、Phase-2 实测触发过 panic(已修复为 soft drop)
  • 升级到新版本:make clean 后重编译,example/main_zc.c 不用改

6. 延伸阅读:

  • 用户态零拷贝栈 spec 总览:docs/zc_stack_user_spec/zh_cn/30-spec-overview.md
  • 现状测绘与拆除清单(17 处触点):docs/zc_stack_user_spec/zh_cn/31-current-state-and-removal.md
  • 对称架构设计(kern_zc_sendit ↔ kern_zc_recvit):docs/zc_stack_user_spec/zh_cn/32-native-arch-design.md
  • 原生 sosend(top) 调研:docs/zc_stack_user_spec/zh_cn/22-native-zc-send-research.md
  • 已部署项目迁移指南:docs/zc_stack_user_spec/zh_cn/39-migration-guide.md
  • ZC-recv M2 实测报告:docs/zc_stack_user_spec/zh_cn/21-m2-test-report.md
  • 初版发送零拷贝介绍(2022):https://mp.weixin.qq.com/s/j_b7pVOoFa6sqaWQD6eBpw
  • 相关 issue:#364(PR,协议栈→DPDK 零拷贝)、#407(接收侧零拷贝确认)、#712(大包发送 crash)、#467(零拷贝 API 讨论)
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md

F-Stack 2.0 前瞻7 :MTU 修改和jumbo frame支持

1. 本功能主要作用和特点

F-Stack 的 DPDK 接管网卡之前只能锁死在 MTU 1500,这次把「减小 MTU 已可用、增大 MTU(jumbo frame)完全不可用」的现状,改造成「启动时按配置设置 1500~9000 任意 MTU、运行时通过标准 SIOCSIFMTU ioctl 动态修改、协议栈与 DPDK 硬件联动」的完整支持。本功能在dev分支和1.21分支都已经支持。

改造前的基线是这么个情况。2026-07 中旬做了一次结论性调研(见 docs/mtu_change_spec/zh_cn/00~15),三方证据交叉得出的结论是「部分支持」:

  • 减小 MTU(≤1500):开箱可用。ff_ioctl(SIOCSIFMTU) 走 FreeBSD ether_ioctl,对 ≤ETHERMTU 的值直接写入 if_mtu 即生效
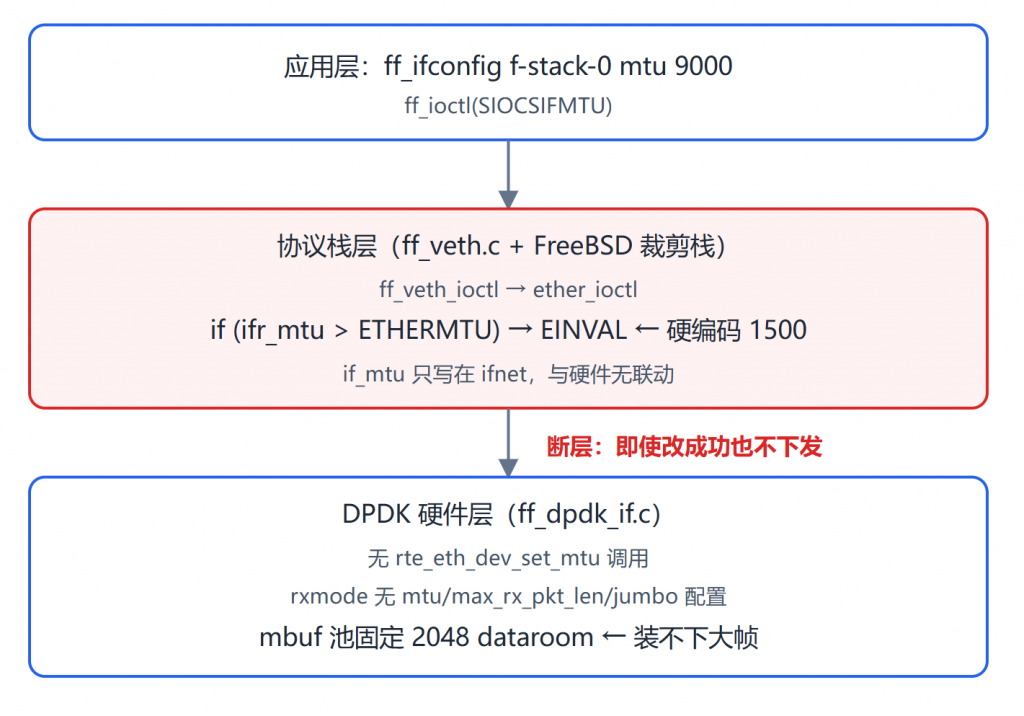
  • 增大 MTU(>1500,jumbo):双重阻断。协议栈层 ether_ioctl 对 ifr_mtu > ETHERMTU(1500) 硬编码返回 EINVAL;DPDK 硬件层完全没有 MTU 接线——没有 rte_eth_dev_set_mtu 调用、mbuf 池固定 RTE_MBUF_DEFAULT_BUF_SIZE(2048 可用 dataroom)、rxmode 无 jumbo/scatter 配置

这个结论和 F-Stack 官方 issue #239/#490/#720 完全一致:jumbo 支持 issue 挂了很久一直是 OPEN,维护者明确回复「mtu 不能超过 1500」。所以这次任务不是打补丁,是把协议栈、DPDK 硬件层、配置体系三个断层全部接上。几个关键词:

  • 软硬联动:一个 MTU 三个视图——协议栈 if_mtu、DPDK 端口 MTU、mbuf 池承载能力,三者必须一致,任一不一致启动即失败
  • 多进程分工:DPDK 物理端口是共享状态,primary 唯一负责硬件(设软+硬),secondary 只设本进程软件 MTU,进程间零 IPC
  • 零回归承诺:新增 mtu_enable 总开关,不启用时旧配置的 MTU 1500、2176B mbuf、ioctl 行为完全不变

2. 本功能的主要适用场景

2.1 大包吞吐优化场景

这是最直接的动机。issue #1033 的历史结论里就有:大包场景性能下降的根本原因部分与 MTU 1500 导致 IP 分片有关。启用巨帧后 8500 字节的包不再被拆成 6 片,分片重组开销归零。适合内部高速网络、大数据块传输、存储网络这类能统一链路 MTU 的环境。

2.2 需要灵活调小 MTU 的隧道/叠加网络场景

减小 MTU 本来就能用,但这次改造后运行时动态修改统一走标准 SIOCSIFMTU 语义,ff_ifconfig f-stack-0 mtu <N> 一条命令改完协议栈+硬件。VXLAN/GRE/隧道叠加场景常需要把 MTU 压到 1400 级别给隧道头留空间。

2.3 多进程生产部署的巨帧统一

1 primary + N secondary 的经典部署下,每个进程各自设置一次 MTU 即可保持一致(primary 管硬件、secondary 管自己的软件视图),无需任何跨进程协调机制。

2.4 不太适合的场景

  • 链路对端不支持 jumbo:virtio 等 PMD 的 jumbo 能力有限,且需要底层网卡/vSwitch/对端统一支持,否则大帧中途被丢或分片——代码支持了,链路不支持也是白搭
  • KNI 与内核共存做深度 MTU 联动的场景:KNI veth 接口的 MTU 联动不在本期范围(只验证了互斥解除后各自独立工作)
  • 想要跨进程事务级 MTU 一致性:本期明确不做 IPC 协调,未设置的进程软件 MTU 保持旧值,这是已知使用约束

3. 本功能的架构特征

3.1 改造前的三层断层

调研阶段画出的根因图,这是理解所有改造的起点:

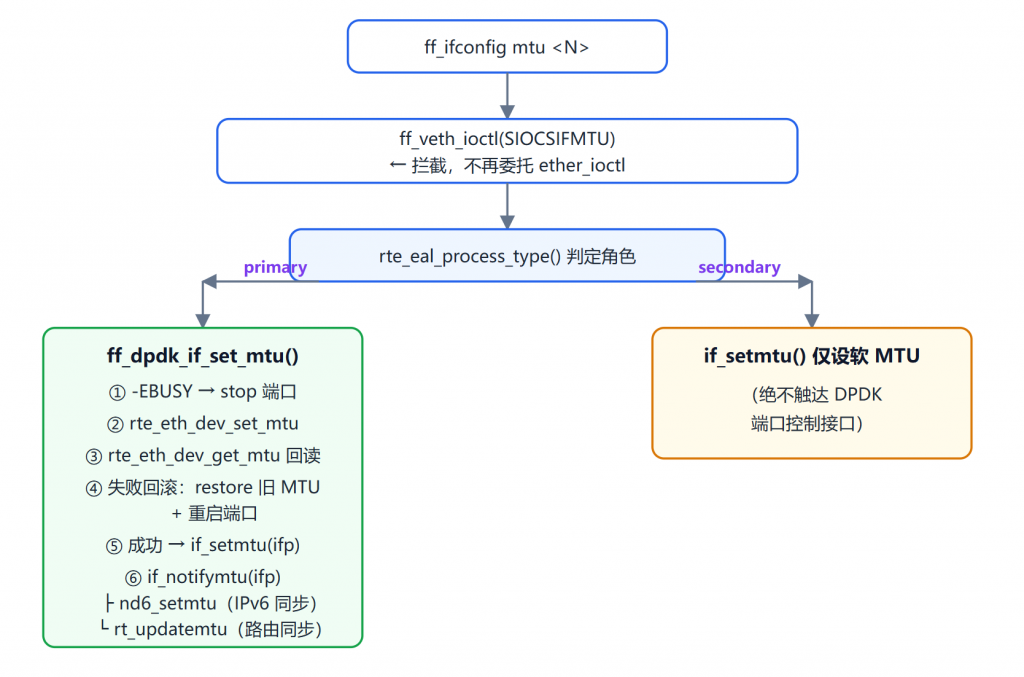
3.2 改造后的 SIOCSIFMTU 路径(按进程角色分流)

关键设计约束:ff_veth.c 不 include rte_ethdev.h,所有硬件操作走 ff_dpdk_if.h 的不透明接口 ff_dpdk_if_get_mtu/set_mtu/get_mtu_capability,DPDK 负 errno 经 ff_dpdk_errno_to_bsd() 统一转 BSD 正 errno。

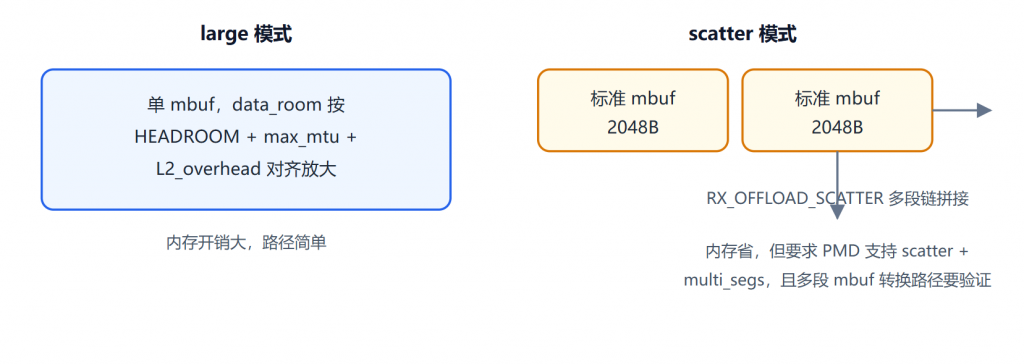
3.3 mbuf 两种承载模式

large 模式 data_room_size = align(HEADROOM + max_mtu + L2_overhead),超过 UINT16_MAX 必须确定性失败,所以 large 模式 max_mtu=65535 不可用;scatter 模式保持标准 mbuf,可配到 65535 但必须满足 PMD 能力。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 调研结论直接转化为需求决策(D-MTU-01~06)

调研收尾时定了 6 条决策,全部贯穿实现:

ID决策
D-MTU-01mbuf 同时实现 large 与 scatter 两种模式,配置选择
D-MTU-02max_mtu 可配置,启用功能且缺省时为 9000
D-MTU-05不修改 freebsd/ 树,在 lib/ff_veth.c 拦截 SIOCSIFMTU 绕过 ether_ioctl 的 1500 硬校验
D-MTU-06mtu_enable=0 时行为与旧版本完全一致(1500 MTU、2176B mbuf、ioctl 不变)

其中 D-MTU-05 最值得说一句:ether_ioctl 的 ETHERMTU 硬校验是 FreeBSD 通用语义,f-stack 的选择不是在裁剪栈里改它,而是在 ff_veth 驱动层拦截 SIOCSIFMTU 自己处理。这样 freebsd/ 子树零改动,升级 FreeBSD 基线时不会引入新的 patch 维护负担。

4.2 代码实施(M1~M5,2026-07-21)

里程碑commit内容
M197452db34配置解析与校验:enum ff_mbuf_mode、ff_port_cfg.mtu、dpdk.{mtu_enable,max_mtu,mbuf_mode};严格 strtoul 解析;跨字段校验;8 个单测 +7 fixtures
M2eec178902DPDK 层:ff_mtu_data_room_size() 对齐计算、large 模式 data_room 尺寸、rxmode.mtu + PMD 能力检查 + scatter offload、set/get_mtu 回读
M30849f9f3aff_veth 集成:不透明 MTU API、DPDK errno→BSD errno 转换、SIOCSIFMTU 拦截(primary 软+硬 / secondary 仅软)、启动时从硬件读初始 if_mtu
M4ef20b1abfEBUSY 状态机:-EBUSY → stop/set_mtu/get_mtu/start;失败回滚 restore 旧 MTU + 重启端口
M5314df8a0a集成测试 + 架构文档更新
收尾0f8f6991e / 332abf997 / 4c30d118fmagic number 宏化、SIOCSIFMTU handler fall-through 去重、bool→uint8_t 干净编译修复

配置解析有一条铁律:禁止 atoi()。新增 ff_parse_u16/ff_parse_mbuf_mode 严格解析(strtoul + errno/endptr/范围检查),任一配置非法在启动阶段明确报错终止,绝不静默回退到 1500。mtu_enable=0 且配置 mtu>1500 直接解析失败并提示先启用功能。

4.3 问题一:IPv6 巨帧回包被按 1448 分片(最大的坑)

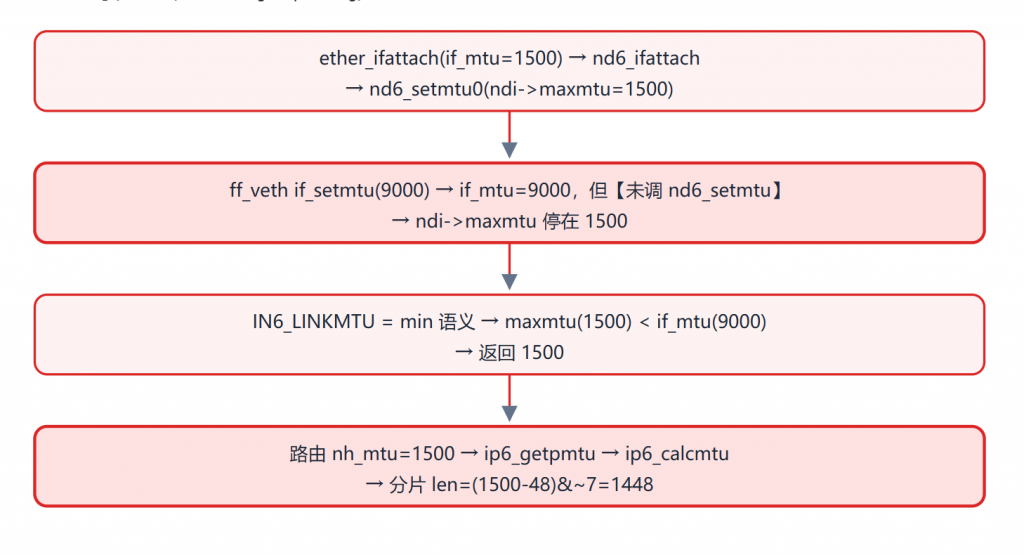
功能上线物理机验证时,出现一个诡异现象:IPv4 巨帧双向正常,IPv6 收 8500 字节 ping 正常、但回包被拆成 6 个 1448 字节分片。

抓包反推:6 片 = 1448×5 + 1268 = 8508,对应分片公式 len = (mtu - 40 - 8) & ~7,反解出来 mtu=1500——协议栈明明 if_mtu 已经设成 9000,IPv6 分片用的 MTU 却还是 1500。

根因链拉了 12 个 file:line(完整分析见 15-IPv6巨帧分片异常分析.md),总结下来就一句:

真正的坑:if_setmtu() 只写 ifp->if_mtu,不含协议族通知。标准 FreeBSD 内核路径 ifhwioctl → if_setmtu → if_notifymtu → nd6_setmtu + rt_updatemtu 会同步 IPv6 的 ndi->maxmtu 和路由 MTU,而 f-stack 为绕过 ether_ioctl 的 1500 硬校验走了”直接 if_setmtu”的捷径,把 if_notifymtu 这一步丢了。IPv4 输出路径直接用 ifp->if_mtu 判断分片所以没事,IPv6 走 IN6_LINKMTU 就中招。

修复(commit 0f25ac495,+163/-1):ff_veth.c 启动初始化和运行时 SIOCSIFMTU 两条路径的 if_setmtu 之后都补调 if_notifymtu(ifp),与标准内核语义对齐。物理机复测:ping6 -M do -s 8500 回包不再分片,IPv6 巨帧收发正常。

【注1】这个坑有普适价值:FreeBSD 里「改 if_mtu」和「通知协议族」是两件事,任何绕过标准 ifhwioctl 路径直接调 if_setmtu 的代码(驱动初始化、ioctl 拦截)都必须自己补 if_notifymtu,否则 IPv6 的 nd_ifinfo 和路由 nh_mtu 会永远停在旧值。顺带一提,当时还排查了次因 RA 通告压低 linkmtu 的可能性,运行时验证确认 linkmtu=0(未受 RA 影响),主因修复后即闭环。

4.4 问题二:KNI/MTU 互斥,先禁止后解除

需求规格 R-MTU-009 初版约定:检测到 mtu_enable=1 与 KNI/内核共存同时启用时,配置阶段以 EOPNOTSUPP 拒绝。理由是双栈 MTU 不一致风险。

物理机实测后推翻了这个保守决定(commit 989f1d2da,+1/-6):mtu_enable=1 与 kni.enable=1 共存完全正常——veth0 MTU=1500 时内核栈正常拆包收发,ifconfig veth0 mtu 9000 时 KNI 通路巨帧收发同样正常。互斥是个不必要的限制,解除后 KNI 用户也能用巨帧。

【注2】这个来回说明 spec 阶段的保守约束值得在实测后重新审视:EOPNOTSUPP 拒绝是最安全的写法,但如果有实测证据表明共存无问题,解除互斥比维持”纸面风险”对用户更友好。

4.5 其他工程细节

  • EBUSY 状态机:rte_eth_dev_set_mtu 对运行中端口可能返回 -EBUSY,M4 实现 primary 进程内的 stop/set_mtu/get_mtu/start,失败回滚 restore 旧 MTU + 重启端口;secondary 直接返回 0 不做硬件操作
  • 多进程一致性靠使用约定:进程间零 IPC、零事务、零消息环,每个进程各自触发一次 SIOCSIFMTU;未设置的进程软件 MTU 保持旧值(已知约束,spec 明示)
  • 门禁:-Werror 编译、freebsd/ 树 git diff 验证零改动、ff_veth.c 无 rte_eth* 引用、无 atoi、无 IPC 残留、mtu_enable=0 全路径零回归——六项全 PASS

5. 如何使用、如何配置、使用效果

5.1 配置

[dpdk]
mtu_enable=1         # 功能总开关,缺省 0(不启用时行为与旧版完全一致)
max_mtu=9000         # 运行时 MTU 上限 + large 模式 pool 预分配依据,缺省 9000
mbuf_mode=large       # large:单 mbuf 承载巨帧;scatter:标准 mbuf 多段链
​
[port0]
mtu=9000             # 端口启动时的协议栈+硬件 MTU,缺省 1500

约束速查:

  • mtu_enable=0 且配置 mtu>1500:解析失败,提示先启用 MTU 功能
  • large 模式 max_mtu 上限受 data_room_size <= UINT16_MAX 约束(65535 不可用);scatter 模式可到 65535 但受 PMD 能力限制
  • 非法配置启动即报错,不会静默回退

5.2 运行时修改

# primary 进程:软+硬件一起改(含 EBUSY→stop/set/start)
ff_ifconfig -p 0 f-stack-0 mtu 9000
​
# 查询
ff_ifconfig -p 0 f-stack-0
f-stack-0: flags=8843<UP,BROADCAST,RUNNING,SIMPLEX,MULTICAST> metric 0 mtu 9000

多进程约定:primary 的修改同时更新软/硬件;每个 secondary 需各自触发一次(只改本进程软件视图)。这是使用约定不是 bug,跨进程 IPC 协调是范围外的后续里程碑。

5.3 使用效果(物理机实测)

测试项结果
IPv4 巨帧ping -M do -s 8972 双向 8500 字节收发正常,MTU=9000 不分片 ✅
IPv6 巨帧ping6 -M do -s 8500 收发正常(修复前回包被按 1448 分 6 片,补 if_notifymtu 后不分片)✅
KNI/MTU 共存mtu_enable=1 + kni.enable=1 共存正常;veth0 MTU 1500/9000 收发均正常 ✅
单元测试59 通过(含 8 个新增 MTU 测试),12 个测试二进制全 PASS ✅
门禁-Werror / freebsd 树零改动 / 无 rte_eth 泄漏 / 无 atoi / 无 IPC 残留 / 零回归 全 PASS ✅

单测覆盖:配置解析 8 个新用例(UT-CFG-01..08)+ 7 个 fixtures,重点打配置校验边界(缺省值、跨字段冲突、非法字符串、溢出)。

5.4 对使用者的建议

  • 要开巨帧先确认链路:物理网卡、vSwitch、对端全部支持 jumbo 才有意义,链路不支持时大帧中途被丢比 1500 更糟
  • 内存敏感场景选 scatter:large 模式 mbuf 池按 max_mtu 预分配,内存开销显著;scatter 省内存但要求 PMD 支持 RX_SCATTER + TX_MULTI_SEGS
  • 只想调小 MTU:不用开 mtu_enable,直接 ff_ifconfig ... mtu 1400 就是

6. 延伸阅读:

  • 调研结论总览与三方证据:docs/mtu_change_spec/zh_cn/00-调研结论总览.md
  • IPv6 巨帧分片异常根因链(12 个 file:line):docs/mtu_change_spec/zh_cn/15-IPv6巨帧分片异常分析.md
  • 实施报告(M0~M5 + Post-M5):docs/mtu_change_spec/zh_cn/14-实施报告.md
  • 接口与配置设计:docs/mtu_change_spec/zh_cn/08-接口与配置设计.md
  • 相关 issue:#239(set MTU in example)、#490(Why MTU MAX CONF is 1500)、#720(Enabling jumbo frames)、#1033(大包性能与 MTU)
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md

F-Stack 2.0 前瞻 6 : LD_PRELOAD 无锁 Ring IPC 改造

1. 本功能主要作用和特点

F-Stack 的 LD_PRELOAD 模块(libff_syscall.so)从 2023-05 初版提交到现在演进三年了,这篇讲的是 2026 年上半年给它做的无锁环形队列改造(FF_USE_RING_IPC),顺带把这三年从初版到现在的优化和修改一起捋一遍。

F-Stack 的标准接入方式是改代码:应用调 ff_* 前缀 API + ff_run() 主循环,代码侵入大。为了降低存量应用的迁移门槛,2023 年社区在 dev 分支提交了 adapter/syscall 目录(commit 8f5f1dfbb,2023-05-03),提供 libff_syscall.so 动态库,通过 LD_PRELOAD 劫持 Linux socket 系统调用转发给 fstack 实例进程处理,应用零代码修改即可接入。初版发布时官方定位很克制:「目前功能尚不完善,仅供测试使用」。

三年后的今天,这个模块已经支持 fork、accept4、_FORTIFY_SOURCE 包装函数、epoll polling 模式,并且把 APP 与 fstack 之间的 IPC 从信号量三层同步演进到了 DPDK 无锁 rte_ring 双环 SPSC。几个关键点:

  • 免改代码接入:socket/bind/connect/read/write/epoll/kevent/select 全部劫持,存量应用(Nginx、netperf 等)零代码修改直接跑在 F-Stack 上
  • 双环 SPSC:FF_USE_RING_IPC 用 rte_ring 单生产者单消费者模式替换 sem_wait/sem_post,消灭全局锁和 O(n) 遍历
  • 诚实收敛:ring 改造经过 v1~v3.7 共七轮实测迭代,最终结论不是”ring 全面胜利”,而是”ring 在 LD_PRELOAD + FF_MULTI_SC 场景下没有性能优势,生产推荐 sem”——这是这篇最想说的:优化要有对照、有证伪、敢于否定自己

2. 本功能的主要适用场景

2.1 存量应用免改代码接入 F-Stack

这是 LD_PRELOAD 模块的根本定位。历史 issue 档案里,官方对”现有多线程/多进程/Go/netperf 类应用怎么移植”的回答,推荐方案第一条几乎都是它:不用改源码,先起 fstack 实例进程,再 LD_PRELOAD 拉起应用。适配的接口面包括 socket 全家桶、epoll 全家桶、kqueue/kevent、select、fork,以及 glibc _FORTIFY_SOURCE 编译的 recv_chk/read_chk/__recvfrom_chk 包装函数。

2.2 Nginx 免改代码集成

Nginx 官方默认携带 1.16.1,经 LD_PRELOAD 接入无需改任何代码,需要同时开 FF_KERNEL_EVENT + FF_MULTI_SC 两个编译开关,配置上 multi_accept on、listen reuseport。不适用场景明确:多实例做客户端(反向代理)暂不支持,需要像社区 @铁皮大爷 那样在 hook 层加 RSS 对称 hash 选实例。

2.3 fork 多进程模型应用

2025-05 的 fork 支持(commit 4891fabf5,PR #887)之后,每个 fork 出来的进程都拥有独立的 FreeBSD struct thread,行为对标 Linux 内核 fork。配合 FF_MULTI_SC,Nginx master fork worker 的经典模型可以跑通。

2.4 不太适合的场景

  • 追求极致性能:每组应用实例要 2 个 CPU 核(1 个 fstack + 1 个 APP),CPU 几乎翻倍,官方原话”性价比不高”。要极致性能还是直接改代码用标准 F-Stack
  • 8 核以上的短连接场景:LD_PRELOAD 性能不如标准 F-Stack,受 APP 与 fstack 匹配度影响

3. 本功能的架构特征

3.1 整体拓扑

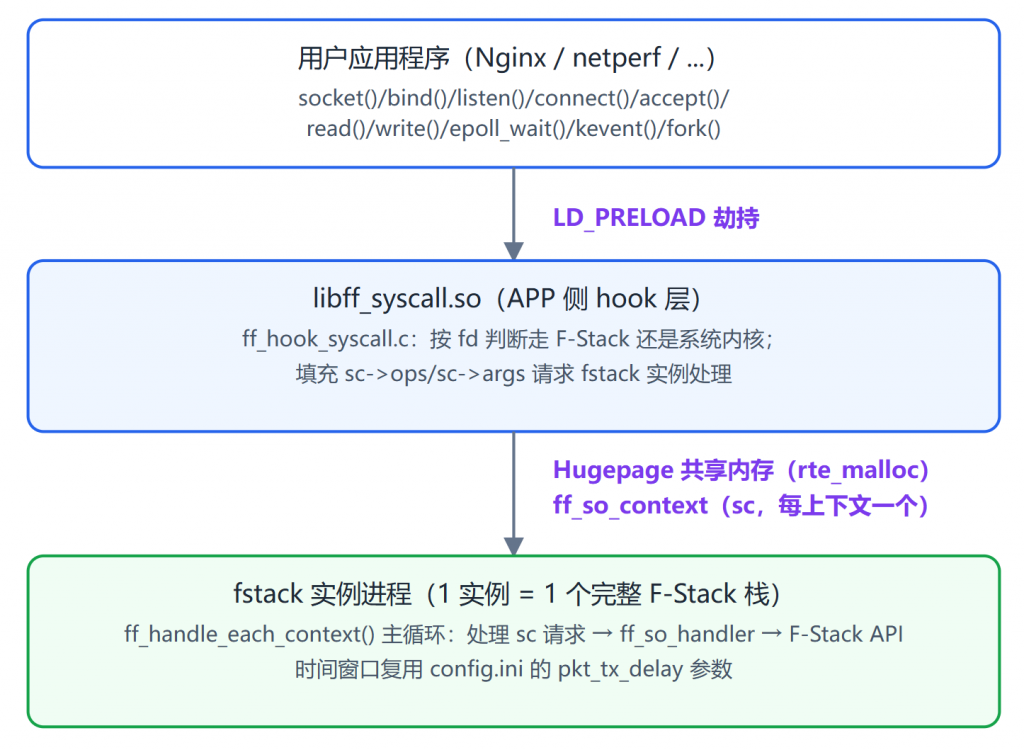
核心通信载体是 DPDK 大页共享内存上的 ff_so_context(简称 sc)。APP 把要执行的 socket 操作填进 sc,fstack 实例主循环处理并把结果写回。fstack 实例和 APP 建议跑在同 NUMA 节点的不同物理核上。

3.2 初版同步机制:信号量三层同步

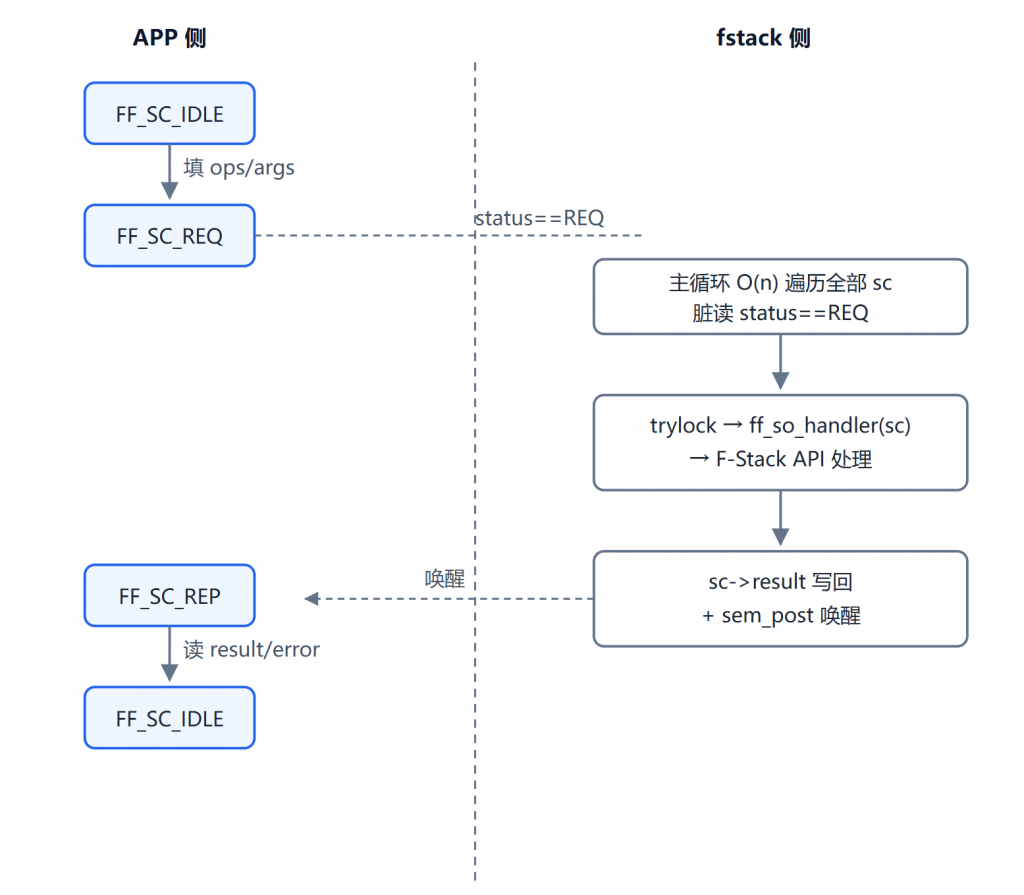
初版(2023-05 ~ 2026-04 默认路径)sc 的同步靠三层机制:

层机制位置
状态机FF_SC_IDLE → FF_SC_REQ → FF_SC_REP → FF_SC_IDLEff_socket_ops.h
互斥锁rte_spinlock_t lock(sc 级 + zone 级全局锁)ff_socket_ops.h
信号量sem_t wait_sem(POSIX 跨进程信号量,futex 实现)ff_socket_ops.h

一次 socket 调用的往返流程:

3.3 新同步机制:双 Ring SPSC

2026-04-09 的 commit d2b71ac89 引入 FF_USE_RING_IPC:用 DPDK rte_ring(SPSC 模式)替代 sem。请求环 APP 生产 fstack 消费,响应环 fstack 生产 APP 消费:

状态语义的等价迁移:sc 在 req_ring 中 = 旧 FF_SC_REQ;在 rsp_ring 中 = 旧 FF_SC_REP;两个 ring 都不在 = 空闲。spinlock 和状态机转换不再参与同步逻辑。

3.4 为什么选 rte_ring

spec 文档(SPEC-002)里给了四条理由:F-Stack 本身大量使用 rte_ring(dispatch_ring、msg_ring),零学习成本;DPDK 原生 SPSC 无需自研无锁算法;Hugepage + rte_memzone 已验证跨进程可见;比 VPP 的 svm_msg_q 更简单。APP 与 fstack 实例 1:1 绑定,天然满足 SPSC 约束。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 初版遗留问题清单(ring 改造的动机)

初版的信号量机制在 spec 文档(SPEC-001)里被列了 5 条性能瓶颈:

  1. 内核态切换:sem_wait/sem_post 走 futex 系统调用,每次 100-200ns,epoll_wait 短超时场景被放大
  2. 超时精度差:sem_timedwait 用 CLOCK_REALTIME,受 NTP 调时影响,唤醒粒度受调度器 tick(1-4ms)限制;还有个竞态:超时返回后 fstack 才 sem_post,导致下次 sem_timedwait 立即返回读到过期结果
  3. O(n) 遍历:ff_handle_each_context 每轮遍历全部 32 个 sc 的 status 字段,绝大多数处于 IDLE 也要脏读
  4. alarm_event_sem 补偿机制脆弱:5 个示例程序里只有 1 个真正调用它,其余全注释掉了
  5. 模式分裂:信号量模式(低 CPU 高延迟)和轮询模式 FF_PRELOAD_POLLING_MODE(低延迟 100% CPU)通过编译宏二选一,运行时不可切换

4.2 三年中间演进(2023-08 ~ 2026-03,ring 之前的沉淀)

ring 不是凭空出现的,中间这三年社区补了不少坑,按时间排:

时间commit内容
2023-080ee517ed0修 Ubuntu 22.04 / kernel 5.19 / gcc 11.4 编译错误(#777),pre-C99 声明问题
2025-035de6ec6d2新增 epoll polling 模式,改善 RTT 敏感场景延迟
2025-033c21f2253修 ff_hook_recvfrom sh_fromlen 未初始化导致返回 -1(PR #872)
2025-03e3766b423accept4 支持 + ff_socket 支持 LINUX_SOCK_CLOEXEC/NONBLOCK
2025-05111816e29hook recv_chk/read_chk/_recvfrom_chk,FORTIFY_SOURCE 编译的应用可用
2025-054891fabf5完整 fork 支持(PR #887),每个进程独立 FreeBSD struct thread
2026-03b36ce995d修 ioctl 可变参数签名冲突编译错误(#942,PR #1048)

其中 ioctl 那个坑值得展开一句:glibc 里 ioctl(2) 是可变参数签名 int ioctl(int, unsigned long, …),而 ff_declare_syscalls.h 按定参注册,新工具链一编就炸。这类”glibc 签名 vs hook 声明”的不一致,是 LD_PRELOAD 这类方案的天生雷区,只能靠社区逐一踩坑修复。

4.3 ring 初版落地(2026-04)

2026-03-27 先产出了 4 篇 spec(需求/架构/接口/测试),审核通过后 2026-04-09 一次性提交 d2b71ac89:双 rte_ring SPSC、FF_USE_RING_IPC 编译开关、三种等待策略(busy-poll/yield-poll/eventfd,默认 yield-poll)、rte_rdtsc 替代 sem_timedwait 做微秒级超时、alarm_event_sem 改为 sentinel 入队。设计上严格走”编译宏切换 + 旧路径不动”,可渐进迁移。

4.4 ring 性能优化攻坚战(2026-05,七轮迭代的教训全集)

初版 ring 一上实测就出问题:短连接 QPS 9.1w,比 sem 基线 10.5w 低 12.4%。于是有了 v1~v3.7 的七轮迭代,这段过程是这篇最有价值的部分——不是”怎么修好的”,而是”怎么一步步证伪自己的错误假设”。

第一轮假设(H10/H11,v1):只读了 ff_socket_ops.c 的 ring 分支,下结论”sem 模式没有 30us drain 强制空轮询”。被证伪——对照 else 分支发现 sem 同样有 if (diff_tsc >= drain_tsc) break 循环。教训:单边代码分析,不对照另一分支就下结论。

第二轮假设(H15,v2):基于”sem 有 nb_handled 旁路而 ring 没有”,假设 ring 的 dequeue burst 跨核读 prod.tail 导致 LLC miss 暴增。perf stat 实测证伪:ring 的 LLC miss 反而比 sem 少 23%(6.8K/s 量级,不构成瓶颈)。教训:没先验证可证伪的物理量就把假设写进文档。

第三轮(v3.1):把”每 256 次 PAUSE 触发 sched_yield”按纯算术推成次因(H18),实测三组配置(yield 阈值 0xFF/0x1FFF/busy-poll)QPS 全部 9.2w,voluntary_ctxt_switches 增长约等于 0——spin_count 是局部变量,短连接场景单次 wait 根本到不了 256 次。教训:频率类估算先做 10 秒采样,别做 30 分钟的弯路。

第四轮(v3.2):perf top callgraph 锁定真因——ff_ring_process_requests Self 15.44%(每次主循环 spin 都走完整 dequeue burst 函数调用栈,即使 nb=0)+ ff_ring_send_response Self 3.33%(每次响应写 rsp_ring->prod.tail,触发 APP 核 cache invalidate)。同期还证伪了自己两条假设:H21 把 wrk 延迟差 +190us 当成单 syscall 开销(差 3 个数量级,真因是 CPU 占用挤压);H24 在 perf 已给明确证据后还发散”跨 NUMA”环境假设(同环境对照实验的唯一变量是 IPC 实现本身)。

方案 C 的失败(v3.3,H25):想用 atomic pending_count 旁路复刻 sem 的 nb_handled 快速跳过,结果 QPS 反劣化 4%(9.1w → 8.7w)。根因:APP 每次 syscall 多写 atomic 2-4 次,跨核 cache 乒乓比省掉的 dequeue 路径更贵。这个方案当天实施当天回退,代码随后彻底删除(f344d945f)。教训写进了文档的”对称评估表”方法论:任何优化必须同时列出”消除的物理量”和”新引入的物理量”,后者数量级必须明显小于前者才允许实施。

D2 的成功(v3.4,+9.7%):放弃响应 ring,fstack 处理完直接写 sc->completion(sc cache line 0 上本来就预留的字段),APP 端 spin completion 标志。写频率与 sem 基线完全一致,零新跨核字段。QPS 9.1w → 10.0w,ff_ring_send_response 从 perf top 消失。

D5(+1.3%):ff_ring_process_requests 改为先 rte_ring_empty() 内联快速空判断,空时不展开函数调用栈。Self 18.98% → 4.53%,但 QPS 只涨 1.3%——省下的 CPU 立刻被 main loop spin 填满。这是关键的洞察起点:fstack lcore 100% CPU + 30us drain 设计下,IPC 省下的 CPU 不会 1:1 变 QPS。

D6(+0.9%):ff_handle_socket_ops_ring 标 static inline,主循环直接函数名调用(去函数指针),与 sem 模式的 ff_handle_socket_ops 对齐。10.13w → 10.22w。

最终收敛:ring 单 worker QPS 10.22w,距 sem 的 10.5w 还差 2.7%。perf top 显示两边 main loop CPU 占比已完全一致(50.13% vs 50.41%),剩余差距来自 rte_ring_sc_dequeue_burst 的 acquire fence 和 ring 元数据维护——sem 的 dirty read 是 plain load 无 fence。这是 SPSC 架构的物理代价,单 worker 单 lcore 场景不可消除。

4.5 意外收获:sem 路径的启动饥饿修复

ring 攻坚过程中顺带修了一个老问题(8125beece,2026-05-25)。现象:sem 模式 + FF_MULTI_SC + config.ini 里 idle_sleep=0 时,多 worker 启动、还没任何流量,nginx 第二个 worker 卡死在 ff_attach_so_context 的 rte_spinlock_lock,gdb 堆栈和死锁一模一样。

但它是饥饿不是死锁:fstack secondary lcore 专核紧自旋,每 50-100us 释锁一次但释锁窗口 <<1us(idle_sleep=0 不让 CPU),nginx worker 是普通调度进程,cmpxchg 永远慢一拍,命中窗口概率趋近 0。修复只改了 13+/5- 行:进入 while 前快照 tmp(in-use sc 数),unlikely(!tmp) 时 unlock → pause → lock 让出窗口,有负载时零影响。最优补丁是”条件性让出”不是”无条件让出”。

【注1】这条饥饿现象同时说明:跨进程自旋锁竞争里,专核 DPDK lcore 永远胜过普通调度进程,这是物理机制不是代码 bug。能用配置(idle_sleep 改 1)消除的现象,根因 99% 是时间窗/调度类问题。

4.6 多核长连接实测:最终证伪 ring 的设计目标(v3.5~v3.7)

单 worker 收敛后转向多核对照。结果比预想残酷:

场景结论
多核短连接(1/2/4 核)ring ≡ sem(差距 -1.9%/0%/-0.3%,噪声范围)
多核长连接(1/2/4 核)ring 稳定劣于 sem 2.4%~4.5%,方向一致且大于噪声

长连接把 ring 的劣势放大而不是抵消:FF_MULTI_SC 下每个 fstack lcore 与 nginx worker 是 1:1 同 zone,sem 的 zone 锁是 fstack lcore 独占持有(cache line 一直 exclusive,近乎零成本),而 ring 每次 dequeue 都要 acquire fence 同步内存系统,高 QPS 下线性放大。当初”长连接下 sem 全程持锁压力升高、ring lock-free 优势将显现”的预测被彻底证伪。

v3.7 终版结论(2026-05-25 晚):

  1. 性能层面:ring 在任何已测场景下均无 net win,sem 仍是 LD_PRELOAD + FF_MULTI_SC 的最优配置
  2. 鲁棒性层面:ring 主循环 lock-free 的理论价值(启动饥饿免疫)已被 8125beece 在 sem 源头修复
  3. 架构层面:ring 代码保留(FF_USE_RING_IPC + D2/D5/D6 作为默认行为,c62d56a3b),作为”多线程同进程共享 sc”和”多进程间共享 sc(worker 数 > fstack 实例数)”的未来预留能力,当前 fork 多进程场景默认不启用

【注2】这个收敛结论值得反复看:一个设计良好、实现了完整 spec、优化了七轮的方案,最终被对照实验判定”不如老方案”。如果只有实现没有对照基线,这个结论永远不会出现。性能优化工作里,”对照组先于优化”比”数据先于理论”更值钱。

4.7 ring 之后还在继续(2026-05 ~ 08)

收敛之后模块没有停:README 全面刷新(bc7c380b2,2026-05-26);ff_hook_bind 增加 addrlen 边界检查(8762e05c1,2026-06-08,#1068);新增 UDP echo server 示例(2215dc4f2,2026-08-07,#1063)。

5. 如何使用、如何配置、使用效果

5.1 编译

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig
​
cd /data/f-stack/adapter/syscall
# Nginx 无缝接入:同时开 FF_KERNEL_EVENT + FF_MULTI_SC
export FF_KERNEL_EVENT=1
export FF_MULTI_SC=1
# 可选:启用无锁 ring IPC(默认关闭,见 5.4 推荐配置)
#export FF_USE_RING_IPC=1
make clean; make all

编译产物:fstack(实例程序)、libff_syscall.so(劫持库)、5 个 helloworld 示例 + main_stack_udp 示例。FF_USE_RING_IPC 与 FF_PRELOAD_POLLING_MODE 互斥,Makefile 有编译期检查,同时定义直接报错。

5.2 运行

# 1. 先起 fstack 实例(lcore_mask 等配置同标准 F-Stack)
bash ./start.sh -b adapter/syscall/fstack
​
# 2. 再以 LD_PRELOAD 方式拉起应用
export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so
export FF_NB_FSTACK_INSTANCE=4        # 与 nginx worker 数 1:1
/usr/local/nginx/sbin/nginx

运行时环境变量:FF_NB_FSTACK_INSTANCE(实例数,默认 1)、FF_INITIAL_LCORE_ID(起始核,默认 0x4)、FF_PROC_ID(进程号,配合 CPU 绑定)。应用能自己绑核的(如 nginx worker_cpu_affinity)优先自己绑。

5.3 Nginx 配置要点(免改代码,但要调配置)

worker_processes  4;
worker_cpu_affinity 10000 100000 1000000 10000000;
​
events {
   worker_connections 1024;
   multi_accept on;      # F-Stack epoll 是 kqueue 封装,必须开
   use epoll;
}
​
http {
   access_log off;
   sendfile   off;      # 用 F-Stack 必须关
   keepalive_timeout 0;
​
   server {
       listen       80 reuseport;   # 每个 fd 对接不同 fstack 实例的 sc
       location / {
           return 200 "0123456789abcdefghijklmnopqrstuvwxyz";
      }
  }
}

注意 kern.maxfiles 不应大于 65536(保证 epoll fd 到内核 fd 的正确映射)。

5.4 使用效果与推荐配置

性能数据(E5-2670 v3 双路 / 10G X540,v3.7 终版实测):

场景SemRing差距
多核短连接 1/2/4 核(万 QPS)10.4 / 20.8 / 35.910.2 / 20.8 / 35.8≤2%(噪声)
多核长连接 1/2/4 核(万 QPS)33.3 / 65.9 / 130.531.8 / 64.3 / 127.0-2.4%~-4.5%
单 worker 优化轨迹—9.1w → 10.22w(+12.3%)距 sem 10.5w 差 2.7%

生产推荐配置(2026-05-25 终版):

# LD_PRELOAD + nginx 多 worker 推荐(默认,不开 ring)
make FF_KERNEL_EVENT=1 FF_MULTI_SC=1
# config.ini: idle_sleep = 0(8125beece 之后安全),pkt_tx_delay = 50(短连接)/ 100(长连接)

ring 路径仅在以下任一情况启用:单进程内多线程需共享 sc;多进程间共享 sc(worker 数 > fstack 实例数);或者接受 -2.4%~-4.5% 的性能损失换取主循环 lock-free 设计。

对 F-Stack 使用者的整体建议:LD_PRELOAD 是”少改代码”的折中,不是”性能最优”的路径。要追求极致还是标准 F-Stack 改代码接入;只想快速迁移存量应用,LD_PRELOAD + sem 默认配置就够用,ring 等未来多对多共享场景再启。

6. 延伸阅读:

  • ring 需求/架构/接口/测试 spec:docs/ld_preload_ring_spec/zh_cn/01~04
  • v3.7 终版性能分析(七轮迭代完整复盘):docs/ld_preload_ring_spec/zh_cn/ring_ipc_perf_offline_analysis.md
  • 模块官方文档(含 2023-05 ~ 2026-05 全部 feature updates):adapter/syscall/README.md
  • 初版公众号介绍(2023-05):https://mp.weixin.qq.com/s/hmxCEu0kOzp5X5TEB7r3OQ
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 历史 issue 档案:docs/zh_cn/f-stack-issue-ana.md