F-Stack 2.0 前瞻9 :Nginx 优雅重载支持,从「reload 必断流」到两代进程共存的分流架构

本篇文章是F-Stack 2.0 前瞻系列的第十篇,也是最后一篇,2.0 版本将在几天内正式发布。

本篇的 Nginx reload 功能在当前的 F-Stack 架构下相对来说非常复杂的,单独 spec 架构设计文档就 review 修改了很多轮,开发、功能完善、bug修复、测试、审核同样进行了很多轮,预计 token 使用量在百亿左右(Codebuddy + HY4 preview/GLM-5.3/Opus-5/Opus-5.5/GPT-6-Astra),总算达到了算是基本完善的版本,当然肯定还是会存在一些未知 bug 或遗留问题的,非常欢迎各位开发者试用并提出发现的问题,如果直接提交修复 PR 则更加感谢。

1. 本功能主要作用和特点

在历史版本上,F-Stack Nginx 一直不支持优雅重载,-s reload 无论怎么调都会造成短暂服务中断,原因其实也不复杂:F-Stack 的 Nginx master 进程本身就是 DPDK primary,独占网卡;reload 一来 worker 全部退出重建,进程更替的空档里网卡队列没人收包,流量必丢。

有不少开发者也希望支持(可以参考 issue #528(重复 #1036)的历史回复),但是一直没有实际去做。社区里唯一的先例是 #547 里的那套 DPDK 18.11 时代的专用接收核补丁,和现在的版本架构早就对不上了,目前也并未开放到社区,回退版本使用也存在一定的开发门槛。

这次把 reload 整个补齐了。在配置文件中开启graceful_reload=1 之后:

  • HUP 无损 reload:新旧两代 worker 并存,新代接管网卡收包并逐包分流,旧代继续服务存量连接直到排空退出。TCP 长传输跨 reload md5 不变、0 停顿;UDP 新流立刻归新代,旧流留在旧代直到空闲
  • USR2 二进制升级 + WINCH:换二进制文件发版也走同一套交接协议,旧 master 的 worker 在活跃 UDP 流排空前先继续提供服务,不会一交接就把旧流扔下
  • 反向代理对称支持:两代主动连上游的临时端口按奇偶分代,新代发起的 TCP/UDP 上游连接,应答不会被误送给旧代
  • KNI/内核共存不受影响:绑内核端口的流量经 KNI ring 由归属代 worker 送内核,reload 前后 veth、SSH、控制面照常工作
  • 可观测:master 打每一步 FSM 迁移和完成统计,worker 打排空与 UDP linger 日志。

关键词:常驻 slim primary(网卡不再跟着 Nginx 重启)、按代分流(软件流表 + UDP 发布表决定每个包归谁)、有限收敛(排空有硬上限,不会无限等下去)。

2. 本功能的主要适用场景

2.1 长连接业务的高频发布

推送、IM、网关 keepalive 这类业务最怕 reload:原生 F-Stack 一 reload 全断重连。两代共存后存量连接不断,新配置对新建连接立刻生效。实测多条并发流跨 HUP,md5 全部一致、0 停顿。

【注1】当前如果重载时的流量压力特别大的话不能保证所有流100%不中断,还是可能会存在部分流中断或失败,建议先降低负载再进行 reload 操作。

2.2 反向代理

proxy 场景有个隐蔽的坑:新代主动连上游,SYN-ACK 回来在流表里查不到,被当成旧流转给了旧代,窗口内新建上游连接全部 504。UDP 代理更惨,修复前 worker 在第一个代理数据报上就 SIGSEGV。现在 TCP/UDP 的临时端口都按代奇偶划分,两代上游四元组不会撞,各自的应答各回各的。

【注2】本地主动外访的本地源端口新旧进程可能选择到相同的源端口导致旧流的流量也路由到新 worker 上导致异常,当前是按代奇偶划分选择本地源端口的方案,但源端口可选范围会降低一半。另一种可选的方案是重载时导出旧 worker 上所有在用源端口到新的 worker 上,选到旧 worker 在用端口则重选。

2.3 DNS / UDP 服务,给 QUIC 打底

UDP 没有 SYN,没法照抄 TCP 的流表判断方法,单独做了一套「发布表」机制。DNS 这种一问一答的业务 reload 无感;持续发包的 UDP 流在窗口内保持归属,直到空闲或到超时上限。支持了 UDP 则有了对 HTTP/3 的支持的基础,但目前仅是简单的四元组分流,尚未支持连接 ID 路由等功能,对 QUIC 必然还存在一些适用范围的限制,目前写进了文档,留待后续版本支持和测试。

2.4 二进制热升级

改了代码要发版,USR2 + WINCH 走同一套交接协议,升级期间服务不断。但也有个限制要注意:老 master 还活着时,新 master 会拒绝继续 HUP,日志写明原因——不挡这一下,两代变三代,类似端口奇偶这类不变量就全乱了。

2.5 不太适合的场景

  • 指望 QUIC 连接迁移 / NAT 重绑定后还保持旧连接:四元组一变就归新代,原连接断开;CID 路由没做
  • 依赖 IP 分片的大 UDP 应答:分片报文一律留在新代(和 TCP 的处理一致)
  • 想把 reload 完成时间精确控制在亚秒级:旧流没排空时,完成时间由旧连接何时结束决定,上限是 worker_shutdown_timeout(不配默认 90 s)

3. 本功能的架构特征

3.1 进程模型与共享结构
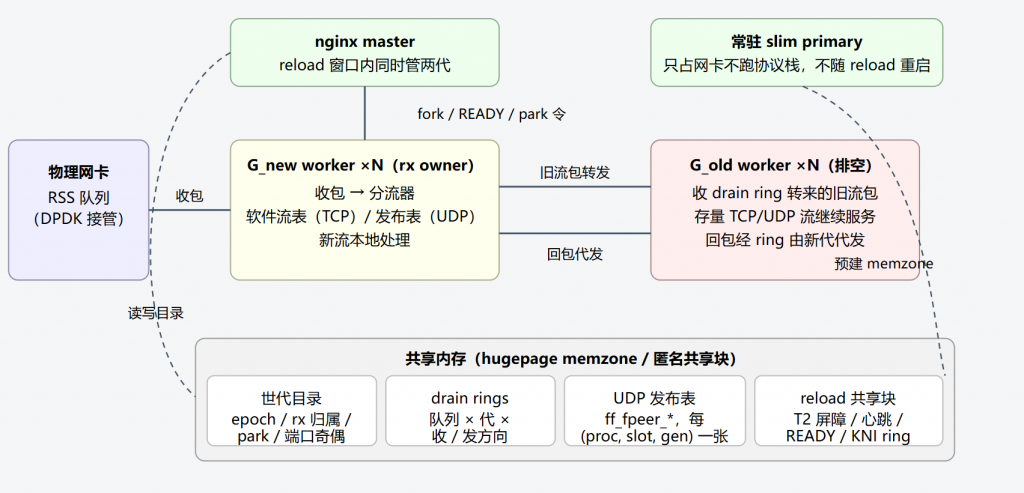
几件事还需要单独注意一下:

  • slim primary 只占 PCI 设备、不初始化协议栈,Nginx 的所有进程(master 和 worker)都是 secondary。reload 只动 Nginx 自己,primary 原地不动,网卡队列永远有人
  • primary 不是无脑常驻:按 pid/comm 判活复用,同时比对启动时的配置摘要。设备侧配置(网卡绑定、队列数、mtu_enable 这类)变了,说明复用不安全,HUP 直接拒绝并给出原因
  • 世代目录(ff_reload_gendir,hugepage memzone)是跨 master 的协调点:epoch 单调递增、4 个槽位记录每轮升级的 master、rx 归属字、端口奇偶标记都放在这里。HUP 是同一个 master 内两代交替,USR2 是两个 master 各占一个槽,两套场景共用一份结构

3.2 HUP 的六步状态机

master 侧把一次 reload 建模成 T0~T5 的状态机:
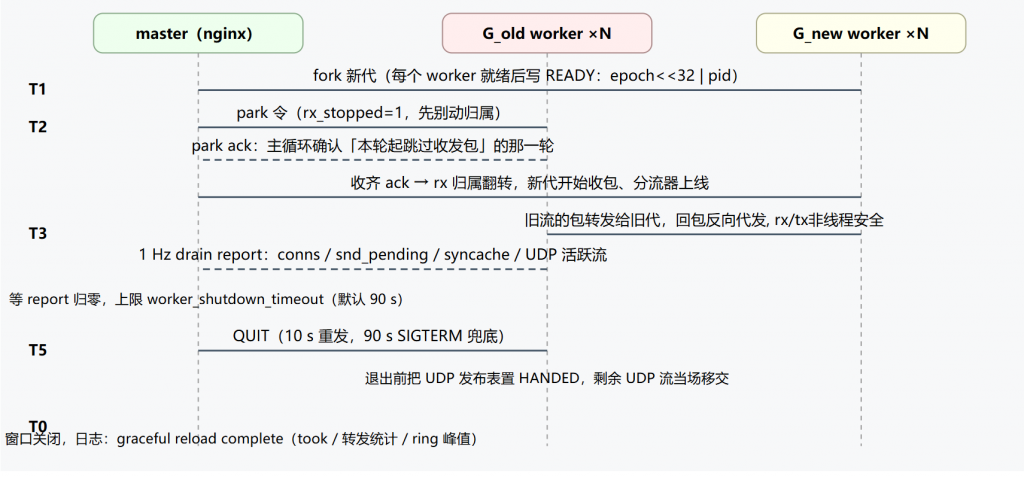
T2 是整个交接里最重要的一步。master 下 park 令之后不能直接翻归属,必须等旧代每个存活的 worker 在自己的主循环里确认「这一轮开始跳过收发包」并 ack——没有这个屏障,网卡队列可能出现两个消费者,或者一个都没有。另一个配套机制是心跳:rx owner 每轮主循环递增共享块里的 heartbeat,其他进程采样它就能发现接收方卡死(reload_heartbeat_timeout_ms),不至于对着一个假 owner 空等。

3.3 分流器:每个包归谁

窗口打开后,新代 worker 的收包路径先进分流器(ngx_ff_flow_map_dispatcher),TCP 和 UDP 走两套规则:
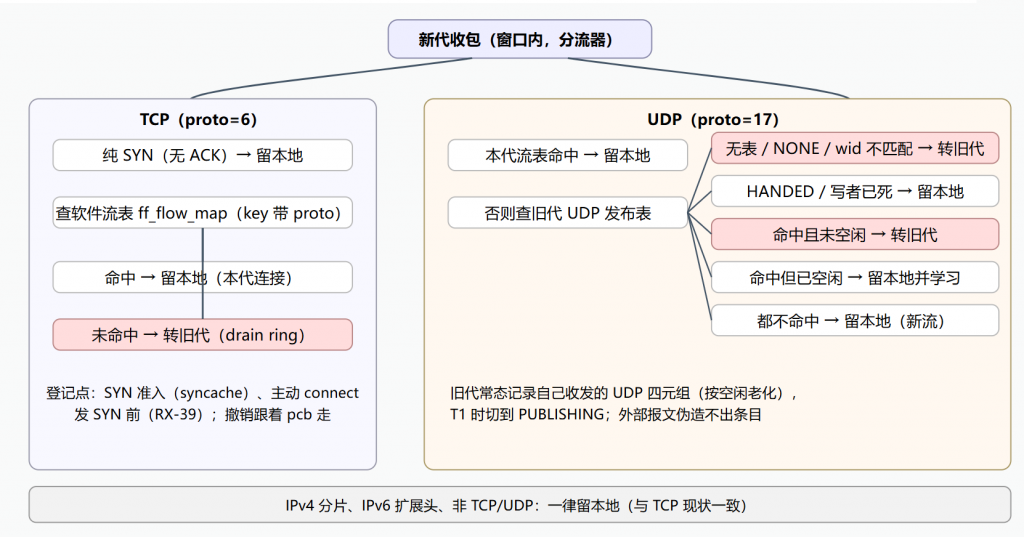
TCP 这套在初期版本有个问题:流表只有 syncache 一个登记点(被动建连),主动 connect 发出的 SYN 没人登记,上游回的 SYN-ACK 查表 miss 被转给旧代,窗口内新建上游连接全 504。修法是主动 connect 在发 SYN 前登记、撤销跟着 pcb 走(RST/关闭/drop 都覆盖),再加上两代临时端口按奇偶划分,四元组从根上就不会撞。

UDP 没法照抄:没有 SYN,也没有可靠的「新流」信号,而且 G_new 的流表里只有本代的条目,服务端的新旧判断需要的是「旧代有什么」。所以反过来做——旧代把正在服务的 UDP 四元组发布出来,新代查这张表决定转还是留。表头是个三态机:

进程挂接     → NONE         还没开始:新代按老行为转发(对端是旧二进制时就是这个状态,兼容)
窗口开始(T1) → PUBLISHING   常态记录的四元组整表可见;表头带窗口身份 wid,防上一轮的旧表被误认
进程退出     → HANDED       新代此后全部本地处理,不再转给退出中的旧代

条目按 reload_udp_idle_ms 空闲老化(默认 10 s):一条流只要还在收发包就一直续着;旧代已经没人在服务的流,空闲到期后新代本地接管并学习进本代流表。

3.4 排空怎么收敛

旧代每秒上报一次 drain report:TCP 连接数(UDP socket 不再计入,否则配了 listen ... udp 每轮 reload 都被钉死在 deadline)、发送队列积压、半开连接数,再加上发布表里未老化的 UDP 流数。master 的 T3 等这个数归零,上限 worker_shutdown_timeout(不配默认 90 s),到点强制推进,剩余 UDP 流当场移交。USR2 没有 master 侧 T3,走 worker 自己的 linger:交接后旧 worker 收到 QUIT 时如果还有活跃 UDP 流,先留着监听继续服务,流空闲或到上限(配了 worker_shutdown_timeout 取该值,否则 30 s)再走退出流程。

4. 具体做了哪些改造、遇到了哪些问题、怎么解决的

后续比较枯燥,不需要深入研究实现过程的可以跳过本节,直接看第 5 节怎么用。

4.1 把 primary 从 Nginx 里拆出来

这是整个功能的地基。原生的模型是「Nginx master 即 DPDK primary」,worker 是 secondary——master 一退出,网卡就没人管了。改造后多出一个常驻的 slim primary:只做 DPDK EAL 初始化、占住 PCI 设备、建好共享 memzone(drain ring、世代目录这些都归它预建),协议栈一概不碰。Nginx 的 master 和全部 worker 都是 secondary,进程随便杀随便换。

配套的东西不少:secondary 直接引用 primary 地址的指针转换(fp/gp/va 三套布局)、primary 按 pid/comm 判活复用、启动配置摘要比对(设备侧 key 变了必须整体重启)、以及 Nginx -s stop 时连带停掉 primary,不然它就成孤儿了(人工测试验收发现的问题,这里不具体展开了)。

4.2 交接屏障、READY 和心跳

T2 的 park 屏障前面说过,这里再补充两个细节。一是新代 worker 起来后要写一个 READY 字(epoch 高 32 位 + pid),master 等所有worker的 READY 等齐了才进入 T2——listen 都没建好的新代接管网卡就是事故。二是心跳:rx owner 每轮主循环加一,采样方发现心跳停了就不等它,按异常路径走。这两个都是「不信任对端一定活着」的防御兜底机制(一般是中止重载,保持或回退到旧 worker 继续服务),整个 reload 过程中里这类防御到处都是,毕竟两个 master 十几个进程谁崩了都不能把别人拖死。

4.3 问题一:主动 connect 的回包被转给旧代

现象是反代场景窗口内新建上游连接 100% 超时,error.log 里一片 upstream timed out (110: Connection timed out) while connecting to upstream。抓包看很清楚:上游 SYN、SYN-ACK 都在,但 SYN-ACK 之后代理侧没有任何回应——SYN-ACK 带着 ACK 位,被分流器当成「已建立的旧流」转给了旧代,而旧代的流表里同样没有它,包进了旧代黑洞。修复就是 3.3 里说的主动登记 + 端口奇偶,外加一条防线:老 master 还在时新 master 拒绝 HUP,防止三代并存破坏奇偶不变量。修复后窗口内 20/20 请求 200,上游端口奇偶 0→1 干净分代。

4.4 UDP 的三个坑

设计上借鉴了 Cloudflare udpgrm 的 FLOW 模式(旧实例在收发路径登记、条目老化、查不到的流给新实例),也记住了 Envoy hot restart 的教训——它把窗口内的新 UDP 包全经父进程转发,envoy#47833 记录过这条转发通道阻塞导致父子进程互相死锁。所以这里只转发「旧代已发布且活跃」的流,新流一律本地,转发面收得越小越好。实现过程中被三任审核各打回来一次,三个坑都值得记:

坑一:只在发布期记录,第二轮 HUP 的表是空的。 最初的设计是「窗口开始(T1)才记录」,T1 时顺带快照一次存量会话。实测第二轮 HUP 时 T3 只用了 1 秒就宣布排空完成,长流被提前移交。原因是第二轮的旧代在上一轮是「新代」,它服务的流都是经分流器本地的,而 UDP 的 return 会话一问一答即结束,快照抓不到东西;T1 之后第一个报文到来之前,活跃流数就是 0。改成常态记录:worker 挂接后每个 UDP 收发包都记(哈希加最多 32 次探测,约 256 KB 的表),T1 只把表头切到 PUBLISHING。代价是 graceful 模式下常态每包多一次哈希,换来的正确性值得。

坑二:跨进程比时钟,无符号差把「未来」判成「已老化」。 写者(旧代)和读者(新代)各自在自己主循环开头取一次 CLOCK_MONOTONIC 毫秒。写者这轮的取样经常比读者晚 1 ms 左右,于是读者算 now - last 得到 0xFFFFFFFF,无符号比较大于任何超时,活跃流被当成已老化、直接被新代抢走。改成有符号差 (int32_t)(now - last) > (int32_t)idle,顺手把配置上限压到 1 小时防止真溢出。单测里专门加了一个「写者晚 5 ms 仍判活」的用例。

坑三:park 令把发布开始的门关上了。 USR2 多 worker 场景,旧 master 发现新 master 后下 park 令;某个兄弟 worker 把目录里的 rx_stopped 置 1 之后,还没开始发布的 worker 一看「我不是 rx owner 了」,按原来的门控(还持有 rx 才开始发布)就永远不发布了——它会照常 ack park,但表停在 NONE,新代只能按老行为转发。根因是「还持有 rx」这个判定把 park 令也算进去了。改成只看 block 里的 rx_owner_gen 是否已经翻转:park 是「准备交」,翻转才是「真的交了」,ack 那一轮之前开始发布是完全安全的。

4.5 UDP linger 和既有上限叠加,排空最长翻倍

最早的写法是 QUIT 来了先 linger 等 UDP 流,linger 结束再走原有退出流程——而原有流程里 shutdown timer、监听关闭(30 s cap)、发送队列等待是各自起算的。叠起来最坏情形接近两倍上限,master 那边 T5 的 90 s SIGTERM 都可能先到。改成一份预算:linger 开始就启动 shutdown timer(之后不再重复启动),linger 结束进入退出流程时,监听关闭和发送队列的起算点回拨到第一次 QUIT 的时刻。USR2 的 linger 上限也和 worker_shutdown_timeout 对齐,同一时刻到期。

4.6 顺手修的原有的 UDP 反代 crash 问题

stream udp 反向代理修复前根本跑不起来:ngx_udp_sendmsg_chain 里 F-Stack 改过的条件先取 c->listening->belong_to_host 再判 c->listening 是否为空,而经 ngx_event_connect_peer 建立的上游连接没有 listening,第一个数据报就 SIGSEGV。gdb 栈一行定位,三处(sendmsg chain 一处、QUIC 输出两处)统一改成先判空。这个 bug 在 F-Stack 的 Nginx-1.28 移植里从合入起就在,只是没人用 UDP 代理所以没炸过。

4.7 测试矩阵

25 个集成用例(harness test_graceful_reload.sh),reload 相关的核心几个:rt01/rt02(TCP 长传输跨 HUP,md5、停顿计数)、rt12(KNI 管理面)、rt25(循环 HUP)、rt27~rt29(primary 复用/停止/MTU 拒绝)、rt32(TCP 反代)、rt33(UDP 服务端,2 worker,v4+v6)、rt34(UDP 反代)、rt35(USR2+WINCH)。单测覆盖流表 key 的协议隔离、发布表的记录/查找/老化/时钟回绕、端口奇偶、HUP/USR2 的开始与放弃条件。修复前后的对照数据都存了档,第 5 节挑重点列。

5. 如何使用、如何配置、使用效果

5.1 配置

f-stack 配置(config.ini / f-stack.conf):

[dpdk]
lcore_mask=7         # 注意:primary_slim=1 时需要比 worker 数量多配置一个 lcore,只要配置两个lcore
​
graceful_reload=1     # 总开关,缺省 0,行为与旧版完全一致
primary_slim=1       # 必须,常驻 slim primary(graceful 的前提)
reload_udp_idle_ms=10000 # UDP 流空闲多久算结束:100..3600000,默认 10000
                    # 改它不用重启 primary(不在配置摘要里)
[port0]
lcore_list=1,2       # 注意:primary_slim=1 时需要多配置跳过 primary 所在的 lcore
​
[kni]
owner_proc_id=1       # 注意:开启 kni 且 primary_slim=1 时需要配置接管 kni 包代发的子进程 ID

Nginx 侧建议配一个 worker_shutdown_timeout,它同时是 HUP 的 T3 上限和 USR2 的 linger 上限,不配默认 90 s,多数场景太长:

worker_shutdown_timeout 25s;

UDP 服务和 UDP 代理就是标准 stream 写法,没有新增指令:

worker_processes  2;              # worker 数量为 f-stack.conf 配置的核心数减1
​
stream {
   server {
       listen 5353 udp;          # DNS 类一问一答
       return "pid=$pid";
  }
   server {
       listen 5354 udp;          # UDP 反代到上游
       proxy_pass <UPSTREAM_IP>:53;
       proxy_responses 1;
       proxy_timeout 5s;
  }
}

5.2 日常操作与日志

nginx -s reload                    # HUP:日常配置变更,无损
kill -USR2  $(cat Nginx.pid)       # 二进制升级:新 binary 接管
kill -WINCH $(cat Nginx.pid.oldbin)# 旧 master 的 worker 开始排空
Nginx -s stop                      # 停止(常驻 primary 一并退出)

master 的 error.log 会把整个过程说清楚,几个关键行:

graceful reload fsm: T2_HANDOVER -> T3_DRAIN (transition 3, elapsed 155 ms)
graceful reload complete: generation 1 now active (took 1297 ms: handover 1 ms,
  drain 1000 ms, drain forwarded 41 / relayed 41 pkts, ring peak rx 0 / tx 0)

worker 侧的排空与 UDP 日志:

ff drain: started (drain generation, conns=0 syncache=0)
reload: publishing UDP flows (HUP), 3 in the snapshot
reload: UDP dispatch: 258 forwarded, 2 kept, 0 taken over, 0 without a peer table
ff drain: UDP linger over after 18200 ms, 0 flow(s) still active

排空卡住时看 T3 stalled 日志(conns/snd_pending/syncache 各是多少一目了然),UDP 则看发布表还剩几条活跃流。

5.3 使用效果(实测)

项修复前修复后
rt33 UDP 服务端:窗口内新流归属(2 worker,v4/v6)8 条新流 6 条被旧代应答新流 240/240 全新代,旧流 592/592 全旧代,0 丢包
rt33 reload 完成时间每轮都钉死在 90 s deadline旧流空闲后 15 s 完成(配的上限 25 s);不停发的长流到上限移交一次、0 丢包
rt34 UDP 反代worker 在第一个代理数据报上 SIGSEGV(约 3 s 内 8 次)上游端口奇偶 0→1 分代,旧流 493/493、新流 120/120,26 s 完成
rt35 USR2+WINCH交接后新流 24/24 无应答,旧流丢 63/259新旧分干净、0 丢包;旧 worker linger 18.2 s 后 0 流退出
rt32 TCP 反代窗口内新建上游连接全 504窗口内 20/200,上游端口奇偶 0→1
rt01/rt02 TCP 长传输—跨 HUP md5 一致,36 流 0 停顿
回归—25 用例全绿,含 KNI 管理面(rt12)与 IPv6

5.4 限制与建议

  • 临时端口常态减半:graceful_reload=1 时两代共存要求 TCP/UDP 临时端口按奇偶分代,每代可用约一半(默认范围约 2.7 万/目的四元组),显式 bind 端口不受约束。端口用量极大的业务要评估
  • QUIC 连接迁移 / NAT 重绑定:四元组一变就归新代,原连接断开;要做 CID 路由是后续工作
  • IP 分片、多播/广播、ICMP 差错:窗口内一律由新代处理,包括旧代已连接上游返回的分片大应答(比如大 DNS 应答)
  • UDP 发布表容量:每进程 16384 项,探测窗口内找不到空槽的流不记录(计数为 not recorded),窗口内按新流处理。一问一答的 DNS 不受影响;超高并发长活 UDP 流要留意
  • 写者判活有约 1 s 粒度:旧代崩溃后,新代最多 1 s 内还往它转;旧代被 SIGKILL 留下的表由同坐标后继进程复位
  • 多 worker 反代依赖 RSS:上游回包要落回发起 worker 的队列,没有 RSS 的机器反代只能单 worker 跑(服务端多 worker 不受影响)
  • 建议:UDP 业务都配上 worker_shutdown_timeout,收敛时间可控;DNS 类一问一答不需要任何特殊配置

6. 延伸阅读:

  • 方案设计与问题登记(中文,权威):docs/Nginx_reload_spec/zh_cn/06-solution-design.md(§10.5 TCP 主动登记、§10.9 RX-39、§10.10 RX-40/RX-41)
  • 测试矩阵与全部实测数据:docs/Nginx_reload_spec/zh_cn/08-testing.md
  • 用户手册(graceful 模式行为与限制):doc/F-Stack_Nginx_APP_Guide.md
  • 三层架构文档:docs/zh_cn/01-LAYER1-ARCHITECTURE.md、03-LAYER3-FUNCTIONS.md
  • 知识图谱:docs/zh_cn/KNOWLEDGE_GRAPH_WIKI.md
  • 相关 issue:#528 / #1036(官方确认 reload 不支持)、#547(DPDK 18.11 接收核补丁)
F-Stack ff_rss_check()优化介绍

1. 概述

本文档旨在介绍 F-Stack 中对 ff_rss_check() 函数的一项重要优化。该优化通过引入一个预计算的静态端口查找表,显著提升了应用程序作为客户端主动发起大量短连接时的性能,解决了原 ff_rss_check() 函数在高并发场景下可能成为性能瓶颈的问题。

核心优化提交:e54aa4317b5d81f9f8643e491d8ec0ec1e72282a

2. 背景与问题分析

ff_rss_check() 函数在 F-Stack 中负责一个关键任务:当应用程序作为客户端发起新的 TCP 连接时,为其分配合适的本地源端口。

  • 原有实现机制: 每次需要建立新连接时,都会动态调用 ff_rss_check()。该函数会根据目标服务的 IP 和端口(4元组信息),通过一个哈希计算来选择一个 RSS(Receive Side Scaling)友好的本地端口,以确保数据包能被高效地分发到正确的 CPU 核心上处理。
  • 性能瓶颈: 在需要频繁创建短连接(例如,处理 HTTP 请求且未开启 keep-alive)的场景下,每次连接建立都需要执行一次或多次端口选择和冲突检查。这个过程涉及多次的toeplitz_hash计算(平均每次耗时约300+tsc,平均次数至少为该端口的总队列(进程)数),在高并发压力下,会消耗可观的 CPU 资源,并成为限制连接建立速率的瓶颈。

3. 优化方案:静态 RSS 端口表

为了克服上述性能问题,优化方案的核心思想是:变“动态计算”为“静态查找”。

  1. 预初始化静态表:
    • 在应用程序启动阶段(ff_init() 时),根据配置文件中的预定义规则,预先计算并初始化一个静态的端口查找表(ff_rss_tbl),。
    • 该表包含了预先调用ff_rss_check()计算好的哪些本地端口发出去的包可以返回本进程对应的网卡队列,表中包含 {{远程地址,远程端口}:{本地地址, [所有可用本地端口]}}组合,以及一些辅助数据结构,如可用端口的起始、结束索引,上次选择的到的端口索引等。
  2. 高效的端口选择:
    • 当需要建立新连接时,首先尝试从这个预先生成的静态表中进行查找。
    • 如果能找到一个与当前连接目标地址/端口匹配且未被占用的本地端口,则直接使用它。这个过程几乎是无锁且开销极低的(平均耗时约100-250tsc)。
    • 最重要的是,静态查找表无需多次选择并计算RSS,只需要查找一次本地端口即可保证远程回包可以回到本进程的队列进行处理,极大提升了选择源端口的效率,进而提升总体的QPS性能。
  3. 优雅降级:
    • 如果静态表中所有符合条件的端口都已被占用或该四元组未配置静态查找表,系统会自动降级到原有的 ff_rss_check() 动态计算流程,确保功能的正确性。

4. 配置说明

此功能需要通过配置文件(例如 config.ini)手动开启和定义。相关配置段如下:

# 启用或禁用静态 ff_rss_check 表。
# 若启用,F-Stack 将在 APP 启动时初始化该表。
# 此后当 APP 作为客户端连接服务器时,会首先尝试从该表中选择本地端口。
[ff_rss_check_tbl]
# 启用开关:0-禁用,1-启用。默认为 0。
enable = 1
# 定义端口分配规则(4元组)。
# 格式:<网卡端口ID> <本地地址 daddr> <远程地址 saddr> <远程端口 sport>
# 单个四元组内用空格分隔,多个四元组之间用分号分隔。
# 注意:saddr/sport 二元组最多支持 16 个,同一 saddr/sport 下最多支持 4 个 daddr。
# 因此,最多支持 64 种组合,超出的配置将被忽略。
rss_tbl=0 192.168.1.10 192.168.2.10 80;0 192.168.1.10 192.168.2.11 80;0 192.168.1.10 192.168.2.12 80

配置参数详解:

  • enable: 总开关,必须设置为 1 才能启用此优化功能。
  • rss_tbl: 定义端口分配规则。每一条规则指定了网卡端口ID用于获取网卡的队列配置,对于特定的目标服务(saddr + sport),使用哪个预先分配好的本地地址(daddr)。

5. 性能提升

根据内部测试数据,该优化带来了显著的性能提升:

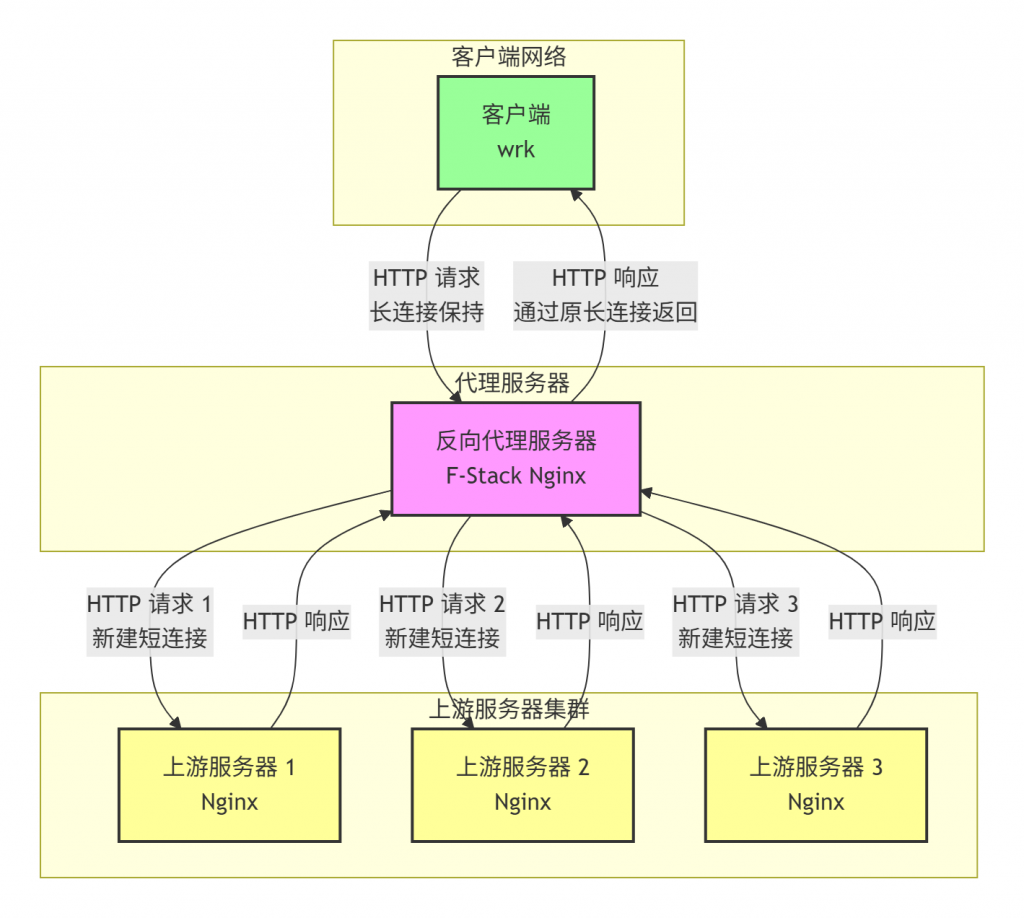
  • 测试场景: 客户端(wrk)向F-Stack Nginx发起http请求,使用长连接。F-Stack Nginx设置反向代理,作为客户端,频繁向多个远程服务器发起短 TCP 连接(未使用 keep-alive)。示例图如下所示:
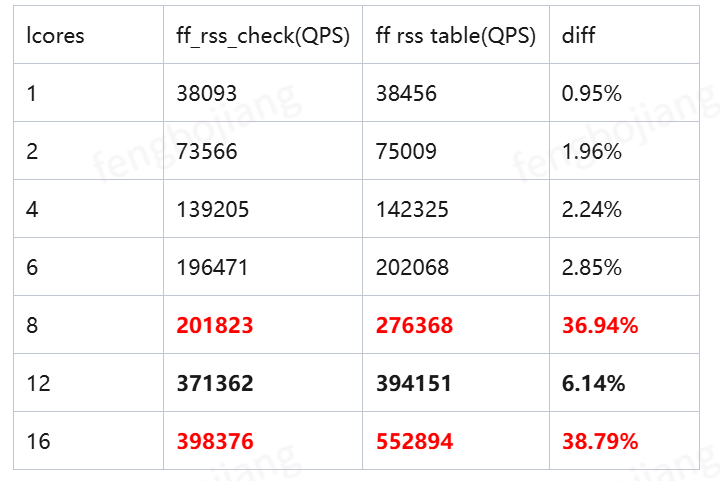
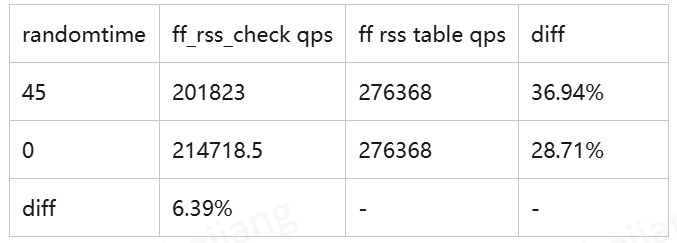
  • 测试数据:如下表所示
  • 常规 QPS 提升约 2-6%左右,且提升的比列会随着进程数的增加而增加,因为进程数越多,原有的ff_rss_check()需要计算的平均次数就越多。
  • 某些特殊场景下提升可以达到35%以上,主要是因为在某些进程数的配置下,原始动态计算方式,随机选择源端口的次数会远超数学期望的总进程数+少量次数,导致需要大量额外调用ff_rss_check()进行计算,消耗了大量CPU资源。
    • 【注意】不同的upstream服务器配置(数量、IP、端口等)可能会导致不同的进程数存在类似问题,在本测试场景下配置8或16进程时,会出现该问题。导致该问题的具体原因则尚未完全明确,查看相关静态表、端口是否正在被占用和请求测试都正常。
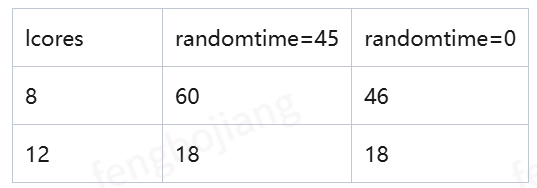
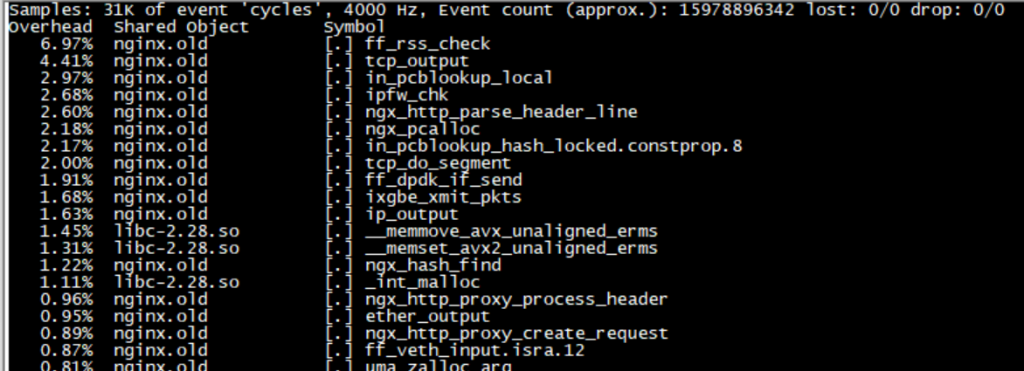
    • 如下表所示分别为8和12进程Nginx调用ff_rss_check()次数的统计,可以看到8核时的随机选择次数明显超出了数学期望的(应该在8-12次左右),16核同理。
      • 其中randomtime表示内核参数net.inet.ip.portrange.randomtime的设置,因为F-Stack框架的特性,作为客户端选择源端口时此时完全随机选择效果更好,且F-Stack对随机性要求并不高,早前已经替换了性能好好很多的伪随机函数。
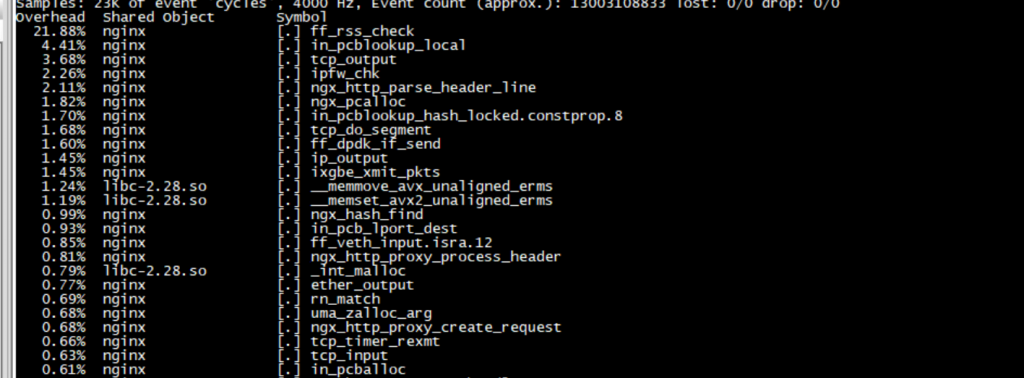
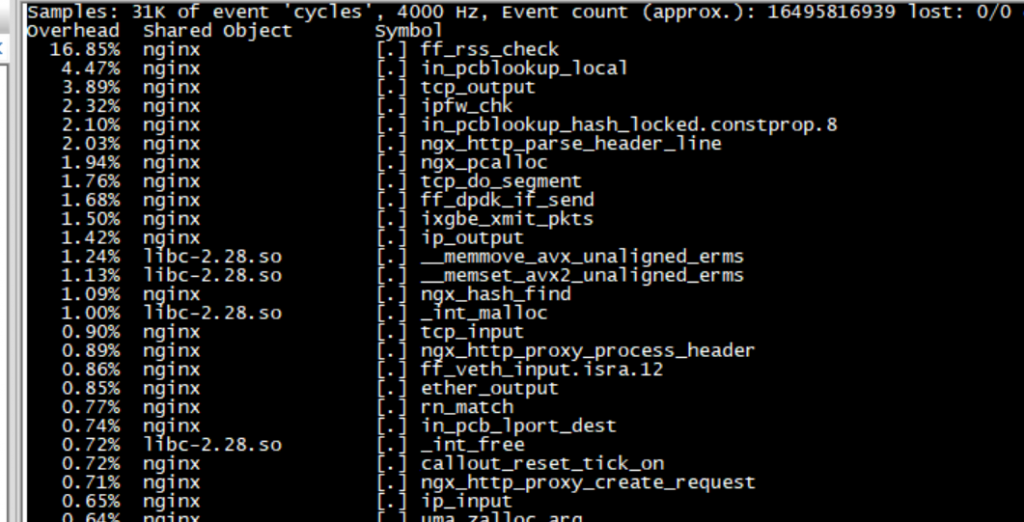
  • perf top截图

8进程间歇性随机(大部分不随机)时ff_rss_check()调用次数太多,热点很高

8进程完全随机,ff_rss_check()调用次数热点有一定降低

12进程,ff_rss_check()的热点则大幅下降

  • 8进程间歇随机和完全随机选择源端口QPS性能对比

6. 其他参数优化调整

F-Stack对应调整了部分参数,具体如下,其他业务如何配置可以根据自己业务的具体特点灵活调整

[freebsd.sysctl]
net.inet.tcp.delayed_ack=1 # 可以提升大并发的吞吐量
net.inet.tcp.fast_finwait2_recycle=1
net.inet.tcp.finwait2_timeout=5000
net.inet.tcp.maxtcptw=128 # 尽快释放TIME_WAIT状态的端口,增加空闲端口,减少in_pcblookup_local()的调用次数,进而减少ff_rss_check()的调用次数
net.inet.ip.portrange.randomized=1
# Always do random while connect to remote server.
# In some scenarios of F-Stack application, the performance can be improved to a certain extent, ablout 5%.
net.inet.ip.portrange.randomtime=0 # 对某些特定配置条件下原动态计算ff_rss_check()方式有一定性能提升

7. 总结

本次对 ff_rss_check() 的优化是 F-Stack 追求性优化能的一个典型例子。它通过以下方式解决了核心瓶颈:

  1. 空间换时间: 使用预计算的静态表换取运行时动态计算的开销。
  2. 减少调用次数: 极大降低了端口选择时的ff_rss_check()和in_pcblookup_local()的重试调用次数,实现总体系统2-6%,特殊极限场景35%以上的总体系统性能提升。
  3. 保证兼容: 通过降级机制保障了在任何情况下的功能正确性。

建议启用此功能的场景: 所有使用 F-Stack 作为客户端、需要高频率创建新连接(特别是短连接)的应用程序。启用后,只需在配置文件中预先定义好常用的目标服务地址,即可获得显著的性能收益。

【AI使用声明】本文初始版本使用DeepSeek-V3.1生成,然后进行人工调整;示意图片由元宝根据人工提供的提示词生成和修改

F-Stack LD_PRELOAD 介绍

2026.05.26本文章已经更新

跳票许久许久的LD_PRELOAD功能模块(后续以 libff_syscall.so 代替)在 F-Stack dev 分支的 adapter/sysctall 目录下已经提交,支持 hook 系统内核 socket 相关接口的代码,降低已有应用迁移到 F-Stack 的门槛。下面将分别进行具体介绍, 主要包括libff_syscall.so 相关的架构涉及其中的一些思考,支持的几种模式以及如何使用等内容。

总体结论:

  • 原有应用程序的接入门槛比原本的 F-Stack 有所降低,大部分情况下可以不修改原有的用户应用程序和 F-Stack lib 的代码,而是仅修改libff_syscall.so相关代码即可适配。
  • 可以支持多 F-Stack 实例(即原 F-Stack 应用程序进程),每个 F-Stack 实例可以对应 1 个或多个用户应用程序。
    • 为了达到最佳的性能,建议一个用户应用程序(进程或线程)对应一个 fstack 实例应用程序,即为一组应用实例。
  • 每组应用实例的性能会略高于系统内核的性能,与单个标准 F-Stack 应用进程互有高低;单机整体的性能相比系统内核仍有较大的优势,但与标准 F-Stack 仍有差距。
    • 新的每组应用实例需要运行在两个 CPU 核心上,而标准 F-Stack 应用进程只需要运行在一个 CPU 核心上,总体而言性价比不高,是否使用可以视各业务的具体情况而定。
    • Nginx 600 字节的 body 内存应答测试中,长连接中相同数量的新应用实例组略高于标准 F-Stack 应用进程,短连接中相同数量的新应用实例组则略低于标准 F-Stack 应用进程,见 Nginx 接入介绍章节,但使用的 CPU 几乎翻倍。

已知限制

自 2023 年以来 libff_syscall.so 持续迭代,原本作为开放问题的多个能力(如 fork、accept4、__recv_chk 系列、epoll polling 模式以及 lock-free ring IPC 等)已经实现,详见下文 功能更新历程。下列限制仍在跟踪,欢迎社区共同完善:

  • 进程结束时仍可能存在内存泄漏与死锁风险。
  • 部分接口(如 sendmsg、readv、readmsg 等)线上场景使用较少,尚未做充分的性能优化与测试,仍需进一步打磨(较新加入的 accept4、__recv_chk、__read_chk、__recvfrom_chk 等已覆盖)。
  • 项目在准生产环境中持续迭代,欢迎社区提供更长时间运行的稳定性反馈。
  • 在多 F-Stack 实例同时运行时暂不能作为客户端使用,例如 Nginx 的 proxy 场景;参考的改造思路如下:
  • @铁皮大爷:之前实现过类似的逻辑,在 hook 内再加一层 RSS。延迟建立 socket(仅在确定目的与来源后再选择由哪个 F-Stack 作为 worker 进程),同时要求网卡接收侧开启 RSS 对称哈希,保证出入方向能落到同一个 F-Stack worker。
    • app -> socket:暂存 socket 操作,创建 fd(fd1)返回给用户。
    • app -> bind:暂存 bind 操作,将 bind 参数与 fd1 绑定后返回给用户。
    • app -> connect:在 fd1 上追加 connect 参数,按 RSS 对称哈希选定某个 F-Stack 进程(worker),将暂存的 socket、bind、connect 一并交给该 F-Stack 进程处理并等待同步结果。

功能更新历程 (2023-05-04 ~ 2026-05-25)

以下汇总自 v1.22 以来 adapter/syscall/ 目录的主要变更。

新功能

  • Lock-free rte_ring IPC(FF_USE_RING_IPC):以 DPDK SPSC ring 替代原先基于信号量的共享内存 IPC,从 fstack 主循环中彻底移除全局 ff_so_zone->lock。多核短/长连接实测中 ring 与 sem 性能相当或略低 2–4%,无跨 worker 锁竞争,并天然免疫启动期自旋锁饥饿。Ring 分支默认启用 v3.4 的优化(D2:sc->completion 唤醒;D5:内联 rte_ring_empty 快速空判断;D6:内联 dequeue burst 与 dispatch)。编译开关见附录 FF_USE_RING_IPC,完整设计与性能分析见 docs/ld_preload_ring_spec/。
  • epoll polling 模式:在 RTT 敏感的事件等待路径上改善时延表现。
  • fork 支持:每个 fork 出的进程拥有自己的 FreeBSD struct thread,行为更接近 Linux kernel,解除了原先 LD_PRELOAD 下 fork 使用受限的状况。
  • accept4 及 SOCK_CLOEXEC / SOCK_NONBLOCK 支持:新增 accept4 hook,并在 ff_socket 上支持 LINUX_SOCK_CLOEXEC / LINUX_SOCK_NONBLOCK 标志位。
  • glibc _FORTIFY_SOURCE 系列 hook:新增 __recv_chk、__read_chk、__recvfrom_chk,使开启 -D_FORTIFY_SOURCE 编译的应用能在 LD_PRELOAD 下正常工作。

功能完善与缺陷修复

  • FF_KERNEL_EVENT 模式下 kernel epoll fd 泄漏修复:ff_hook_close 在启用 FF_KERNEL_EVENT 时同步关闭系统侧 epoll fd,解决长时间运行 Nginx 场景下观察到的内核 fd 泄漏。
  • ff_hook_syscall.c 中 cplen 计算修复:修复 hook 路径中错误的长度计算,并后续将代码风格统一到 ff_hook_accept。
  • ff_hook_recvfrom 中 sh_fromlen 未初始化修复:在调用 ff_sys_recvfrom 之前初始化 sh_fromlen,修复返回 -1 的回归问题。
  • ioctl 函数原型冲突的编译错误修复(#942):解决新版工具链下函数原型冲突导致的构建失败。
  • Ring IPC 启动期饥饿修复:在 FF_MULTI_SC + idle_sleep = 0 场景下,nginx worker 在 attach 第二个 fstack 实例的 ff_so_zone 时可能表现为死锁;sem 路径在确认无在用 socket context 时做条件性的 unlock → pause → lock,消除饥饿且对正常负载零影响。
  • Ubuntu 22.04 / kernel 5.19 / gcc 11.4 编译错误修复:包含 pre-C99 声明问题,参考 #777。
  • 其他零碎编译 / 日志 / Makefile / 头文件打磨:包括 syscall 目录编译问题修复、日志清理,以及一系列围绕 ff_hook_syscall.c、ff_socket_ops.c、ff_socket_ops.h、ff_linux_syscall.c、ff_sysproto.h、ff_declare_syscalls.h 与 Makefile 的细节改进。

libff_syscall.so 的编译

先设置好FF_PATH和PKG_CONFIG_PATH环境变量

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig

在adapter/sysctall目录下直接编译即可得到ibff_syscall.so的相关功能组件

cd /data/f-stack/adapter/sysctall
make clean;make all
​
ls -lrt
fstack
libff_syscall.so
helloworld_stack
helloworld_stack_thread_socket
helloworld_stack_epoll
helloworld_stack_epoll_thread_socket
helloworld_stack_epoll_kernel

下面将分别进行介绍各个组件的主要作用

fstack 实例应用程序

fstack应用程序对标的是标准版 F-Stack 中的应用程序,其运行与普通的 F-Stack 应用程序完全相同,包括配置文件及其多进程(每进程即为一个实例)的运行方式等, 具体运行方式可以参考 F-Stack 主目录的 README, 在执行 LD_PRELOAD 的用户应用程序前必须先运行 fstack实例应用程序。

fstack 应用程序的作用主要是底层对接 F-Stack API,其主函数ff_handle_each_context即为普通 F-Stack 应用的用户层 loop 函数,非空闲时或每间隔 10ms (受 HZ参数影响) 时会调用该函数去循环处理与 APP 对接的上下文,如果 APP 有对应的 API 请求,则调用实际的 F-Stack API 进行处理。

与 libff_syscall.so用户应用进程间通信使用 DPDK 的 rte_malloc 分配的 Hugepage 共享内存进行。

该函数对 libff_syscall.so 的整体性能有至关重要的影响,目前是复用了 F-Stack 主配置文件(config.ini)中的 pkt_tx_dalay参数,死循环并延迟该参数指定的值后才会回到 F-Stack 的其他处理流程中。

如果想提高 libff_syscall.so的整体性能,那么fstack实例应用程序与 APP 应用程序的匹配十分重要,只有当一个ff_handle_each_context循环中尽量匹配一次循环的所有事件时才能达到最优的性能,这里需要调十分精细的调优,但是目前还是粗略的使用 pkt_tx_dalay参数值。

【提示】pkt_tx_dalay参数的默认值为 100us, 较适合长连接的场景。如果是 Nginx 短链接的场景,则应考虑设置为 50us,可以可获得更好的性能。当然不同的用用场景如果想达到最优的性能,可能需要业务自行调整及测试。复用该参数也只是临时方案,后续如果有更优的方案,则随时可能进行调整。

libff_syscall.so

该动态库主要作用是劫持系统的 socket 相关接口,根据 fd 参数判断是调用 F-Stack的相关接口(通过上下文 sc 与 fsack 实例应用程序交互)还是系统内核的相关接口。

与fstack实例应用进程间通信使用 DPDK 的 rte_malloc 分配的 Hugepage 共享内存进行。

【注意】在第一次调用相关接口时分配相关内存,不再释放,进程退出时存在内存泄漏的问题,待修复。

F-Stack用户的应用程序 (如 helloworl 或 Nginx)设置 LD_PRELOAD劫持系统的 socket 相关 API 时使用,即可直接接入 F-Stack 开发框架,可以参考如下命令:

export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so

确保 fstack实例应用程序已经正确运行的前提下,然后启动用户应用程序。

当然如果是改造用户的 APP 使用 kqueue代替 Linux 的 epoll 相关事件接口时,也可以在用户 APP 中直接链接该运行库, 可以参考相关示例程序helloworld_stack和helloworld_stack_thread_socket对应的源文件main_stack.c和main_stack_thread_socket.c,因为不是使用的LD_PRELOAD, 所以本文档不再详细介绍。

【重要提示】一组对应的fstack应用程序和用户应用程序最好运行在同一个 CPU NUMA 节点的不同物理核上,其他场景(运行在同一个CPU核心、两个 CPU 核心跨 NUMA 节点,物理核和超线程核混用)都无法达到一组实例的最佳性能。

  • 特别的,如果 CPU 物理核心比较缺乏,可以考虑一组实例分别运行在对应的一组 CPU 的物理核心和 HT 核心上,虽然单组实例性能会有所下降(约 20% 左右),但可以使用更多的 CPU 核心,单机总性能可能会有所提升。

DEMO 演示程序 helloworld_stack*

其他编译生成的hello_world开头的可执行文件为当前libff_syscall.so支持的几种不同运行模式的相关演示程序,下一节进行具体介绍。

F-Stack LD_PRELOAD 支持的几种模式

为了适应不同应用对 socket 接口的不同使用方式,降低已有应用迁移到 F-Stack 的门槛,并尽量提高较高的性能,目前 F-Stack 的 libff_syscall.so 主要支持以下几种模式,支持多线程的 PIPELINE 模式、线程(进程)内的 RTC(run to completion)模式、同时支持 F-Stack 和内核 socket 接口的 FF_KERNEL_EVENT 模式和类似内核 SO_REUSEPORT 的 FF_MULTI_SC 模式。

支持多线程的 PIPELINE 模式

该模式为默认模式,无需额外设置任何参数直接编译libff_syscall.so即可。

在此模式下,socket 相关接口返回的 fd 可以在不同线程交叉调用,即支持 PIPELINE 模式,对已有应用的移植接入更友好,但性能上相应也会有更多的损失。

该模式除了单进程运行方式外,同时可以支持用户应用程序多进程方式运行,每个用户进程对应一个fstack实例应用程序的实例,更多信息可以参考附录的运行参数介绍。

【注意】以此默认方式接入 F-Stack 的应用程序只能使用 F-Stack 的 socket 网络接口,而不能使用系统的 socket 接口。

hook 系统 epoll 接口

对于已有的 Linux 下的应用,事件接口都是一般使用的是epoll相关接口,对于没有更多特殊要求的应用程序,可以直接使用默认的编译参数编译libff_syscall.so后使用,参考 DEMO 程序helloworld_stack_epoll, 代码文件为main_stack_epoll.c。

【注意】F-Stack 的epoll接口依然为kqueue接口的封装,使用上依然与系统标准的epoll事件接口有一定区别,主要是事件触发方式和multi accept的区别。

使用 kqueue

当然libff_syscall.so除了支持使用LD_PRELOAD方式 hook 系统的 socket 接口的方式使用,也支持普通的链接方式使用,此时除了可以使用系统的epoll事件接口之外,还可以使用 F-Stack(FreeBSD)具有的kqueue事件接口,参考 DEMO 程序helloworld_stack, 代码文件为main_stack.c。

该使用方式的性能比LD_PRELOALD使用系统epoll接口的方式有略微的性能提升。

线程(进程)内的 RTC(run to completion)模式

该模式需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_THREAD_SOCKET或执行以下 shell 命令来开启。

export FF_THREAD_SOCKET=1
make clean;make all

在此模式下,socket 相关接口返回的 fd 仅可以在本线程内调用,即仅支持线程内的 RTC 模式,对已有应用的移植接入门槛稍高,但性能上相应也会有一定的提升,适合原本就以 RTC 模式运行的应用移植。

同样的,该模式除了单进程运行方式外,同时可以支持用户应用程序多进程方式运行,每个用户进程对应一个fstack实例应用程序的实例,更多信息可以参考附录的运行参数介绍。

【注意】以此默认方式接入 F-Stack 的应用程序同样只能使用 F-Stack 的 socket 网络接口,而不能使用系统的 socket 接口。

hook 系统 epoll 接口

其他同默认的 PIPELINE 模式,可以参考 DEMO 程序helloworld_stack_epoll_thread_socket, 代码文件为main_stack_epoll_thread_socket.c。

使用 kqueue

其他同默认的 PIPELINE 模式,可以参考 DEMO 程序helloworld_stack_thread_socket, 代码文件为main_stack_thread_socket.c。

FF_KERNEL_EVENT 模式

该模式可以同时支持 F-Stack 和系统内核的 socket 接口,需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_KERNEL_EVENT或执行以下 shell 命令来开启。

export FF_KERNEL_EVENT=1
make clean;make all

在此模式下,epoll相关接口在调用 F-Stack 接口的同时会调用系统内核的相关接口,并将 F-Stack 返回的 fd 与系统内核返回的 fd 建立映射关系,主要为了支持两个场景:

  • 用户应用程序中有控制 fd 与 数据 fd 使用相同的 epoll fd, 如 Nginx。
  • 希望本机也可以同时访问用户应用程序监听的网络接口。
    • 如果希望单独与本机系统内核进行普通网络通信,需要额外调用socket接口,并需要指定type | SOCK_KERNEL参数,并为返回的 fd 单独调用 bind()、listen()、epoll_ctl()等接口,参考 DEMO 程序helloworld_stack_epoll_kernel, 代码文件为main_stack_epoll_kernel.c

【注意1】F-Stack 中 FreeBSD 的内核参数 kern.maxfiles不应该大于 65536(原默认值为 33554432),以保证 F-Stack 的 epoll fd 到系统内核的 epoll fd 的正确映射。

【注意2】Nginx 的无缝接入需要开启此模式,因为在 Nginx 中有多个控制 fd 与 数据 fd 使用相同的 epoll fd。

FF_MULTI_SC 模式

该模式为 Nginx 等使用内核SO_REUSEPORT且fork子进程 worker 运行等特殊的设置为设置,需要设置额外的编译参数后来编译libff_syscall.so才能开启,可以在adapter/sysctall/Makefile中使能FF_MULTI_SC或执行以下 shell 命令来开启。

export FF_MULTI_SC=1
make clean;make all

在此模式下,用户应用程序与fstack实例相关联的上下文sc除了保存在全局变量sc中之外,会额外保存在全局的scs数组中,在fork()子进程 worker 时会使用 current_worker_id设置sc变量为对应 worker 进程 fd 对应的 sc,供子进程复制及使用。

Nginx 的reuseport模式的主要流程为,主进程为每个 worker 分别调用 socket()、bind()、listen()等接口,并复制到 worker 进程,而后 woker 进程各自调用epoll相关接口处理各自的 fd, 需要各自 fd 对应的上下文 sc 才能正确运行。

【注意】Nginx 的无缝接入需要同时开启 FF_THREAD_SOCKET 和 FF_MULTI_SC 模式。

Nginx 接入libff_syscall.so介绍

Nginx(以 F-Stack 默认携带的 Nginx-1.16.1 为例)目前可以不修改任何代码直接以LD_PRELOAD动态库libff_syscall.so的方式接入 F-Stack,以下为主要步骤及效果。

编译libff_syscall.so

需要同时开启 FF_THREAD_SOCKET 和 FF_MULTI_SC 模式进行编译

export FF_PATH=/data/f-stack
export PKG_CONFIG_PATH=/usr/lib64/pkgconfig:/usr/local/lib64/pkgconfig:/usr/lib/pkgconfig
​
cd /data/f-stack/adapter/sysctall
export FF_KERNEL_EVENT=1
export FF_MULTI_SC=1
make clean;make all

配置nginx.conf

以下为主要需要注意及修改的相关配置参数示例(非全量参数):

user  root;
worker_processes 4; # worker 数量
worker_cpu_affinity 10000 100000 1000000 10000000; # 设置 CPU 亲和性
​
events {
  worker_connections 1024;
  multi_accept on; # epoll 是封装 kqueue 接口,必须要开启
  use epoll;
}
​
http {
access_log off; # 关闭访问日志,用于提高测试时的网络性能,否则每次请求都需要额外调用系统的 write() 接口记录访问日志
​
sendfile       off; # 使用 F-Stack 时需要关闭

keepalive_timeout 0; # 视长连接/短链接的业务需要调整
  #keepalive_timeout 65;
  #keepalive_requests 200; # 默认每个长连接最多 100 个请求,视业务需要调整,长连接时适当提高此值可以略微提高性能
   
  server {
      listen       80 reuseport; # 应该设置 reuseport,与使用系统的内核的 reuseport 行为不太一致,但都可以提高性能
​
      access_log off;
       
      location / {
          #root   html;
          #index index.html index.htm;
          return 200 "0123456789abcdefghijklmnopqrstuvwxyz"; # 直接返回数据用以测试单纯的网络性能
      }
  }
}

【注意】此处的 reuseport作用是使用多个不同的 socket fd, 而每个 fd 可以对接不同的fstack实例应用程序的上下文sc来分散请求,从而达到提高性能的目的。与系统内核的reuseport行为异曲同工。

运行

假设运行4组 Nginx – fstack 实例应用程序,可以简单按照以下步骤进行

  • 运行 fstack 实例
  • 设置config.ini中的lcore_mask=f00,即使用 CPU 核心 9-11, 其他配置按照标准 F-Stack 配置进行。
  • 参考以下命令启动 fstack 实例,并等待一段时间待 fstack 主进程和子进程都启动完成
  cd /data/f-stack
  bash ./start.sh -b adapter/syscall/fstack
  • 运行 Nginx
  • 参考以下命令配置libff_syscall.so所需的环境变量
  export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so # 设置 LD_PRELOAD libff_syscall.so
  export FF_NB_FSTACK_INSTANCE=4 # 设置有 4 个 fstack 实例应用程序,前面 nginx.conf 中也配置了 4 个worker
  • 启动 Nginx
  /usr/local/nginx/sbin/nginx # 启动 Nginx

性能对比

测试环境

CPU:Intel(R) Xeon(R) CPU E5-2670 v3 @ 2.30GHz * 2

网卡:Intel Corporation Ethernet Controller 10-Gigabit X540-AT2

OS :TencentOS Server 3.2 (Final)

内核:5.4.119-1-tlinux4-0009.1 #1 SMP Sun Jan 23 22:20:03 CST 2022 x86_64 x86_64 x86_64 GNU/Linux

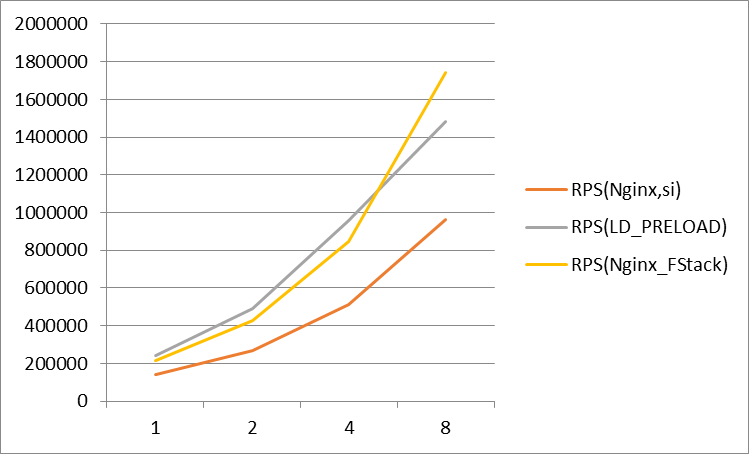
Nginx长连接

  • body 大小为 602 字节(不包括 http 头等)。
  • LD_PRELOAD 实际使用的 CPU 为几乎横轴 CPU 核心数的双倍,系统内核均衡软中断实际使用的 CPU 也远高于 worker 数量对应的 CPU 核心数量。
  • 限于时间所限,其中 LD_PRELOAD 的测试数据为以上测试环境的数据,其他为历史 40G 测试环境的数据,后续会更新为相同测试环境的数据。
  • 受网卡硬件所限,8核 LD_PRELOAD 测试带宽已经接近 10G 网卡线速(服务端出带宽9.xG,148万 RPS), 导致的与标准 F-Stack 的数据差异,实际CPU尚有一些空闲,后续应使用 40G/100G 网卡进行对比测试
  • pkt_tx_delay 参数为 100us。

Nginx短链接

  • body 大小为 602 字节(不包括 http 头等)。
  • LD_PRELOAD 实际使用的 CPU 为几乎横轴 CPU 核心数的双倍,系统内核均衡软中断实际使用的 CPU 也远高于 worker 数量对应的 CPU 核心数量。
  • 受 CPU 硬件所限(12C24HT * 2),LD_PRELOAD 测试只能测试12组应用实例组,即使用了全部 CPU 的物理核心,无法进行更多实例组的测试。
  • 8核之后 LD_PRELOAD 的性能不如标准 F-Stack 的性能,最主要是受用户应用程序和fstack应用程序的匹配度不高(ff_handle_each_context的循环次数及时间等)影响很大,并未完全达到性能极致,如果持续的精细化调整可以进一步提高性能,但是通用性也不高。
  • pkt_tx_delay 参数由 100us 调整到 50us。

附录:详细参数介绍

编译参数

本段总体介绍各个编译选项,所有参数都可以在adapter/sysctall/Makefile中开启或通过 shell 命令设置环境变量来开启。

DEBUG

开启或关闭 DEBUG 模式,主要影响优化和日志输出等, 默认关闭。

export DEBUG=-O0 -gdwarf-2 -g3

默认的优化参数为

-g -O2 -DNDEBUG

FF_THREAD_SOCKET

是否开启线程级上下文sc变量,如果开启,则 socket 相关 fd 只能在本线程中调用,一般可以略微提高性能, 默认关闭。

export FF_THREAD_SOCKET=1

FF_KERNEL_EVENT

是否开启epoll相关接口在调用 F-Stack 接口的同时调用系统内核的相关接口,并将 F-Stack 返回的 fd 与系统内核返回的 fd 建立映射关系, 默认关闭,主要为了支持两个场景:

  • 用户应用程序中有控制 fd 与 数据 fd 使用相同的 epoll fd, 如 Nginx。
  • 希望本机也可以同时访问用户应用程序监听的网络接口。
export FF_KERNEL_EVENT=1

FF_MULTI_SC

在此模式下,用户应用程序与fstack实例相关联的上下文sc除了保存在全局变量sc中之外,会额外保存在全局的scs数组中,在fork()子进程 worker 时会使用 current_worker_id设置sc变量为对应 worker 进程 fd 对应的 sc,供子进程复制及使用。 默认关闭。

export FF_KERNEL_EVENT=1

FF_USE_RING_IPC

是否将 libff_syscall.so 与 fstack 实例之间的 IPC 从原有的信号量+共享内存方案切换为 lock-free 的 DPDK SPSC rte_ring,默认关闭。

export FF_USE_RING_IPC=1

启用该开关时,v3.4 的 ring 路径优化均作为默认行为合入(基于 sc->completion 的唤醒、内联 rte_ring_empty 快速空判断、以及内联 dequeue burst 与 dispatch),无需额外子开关。

性能摘要:在 LD_PRELOAD + FF_MULTI_SC 且 nginx worker 与 fstack 实例 1:1 的部署形态下,ring 与 sem 在 1 / 2 / 4 核短/长连接实测中相差均在 2–4% 以内。Ring 路径的主要价值是结构性的:主循环 lock-free、天然免疫启动期自旋锁饥饿、且不需要 fstack 侧的 zone 级锁。对于每个 worker 拥有独立 fstack 实例的生产部署,sem 路径仍是推荐配置;ring 路径主要作为未来”单进程内多线程共享 sc”或”多进程间共享 sc(worker 数量多于 fstack 实例数量)”扩展场景的预留能力。完整设计与性能分析见 docs/ld_preload_ring_spec/。

运行参数

通过设置环境变量设置一些用户应用程序需要的参数值,如果后续通过配置文件配置的话可能需要修改原有应用,所以暂时使用设置环境变量的方式。

LD_PRELOAD

设置 LD_PRELOAD 的运行库,再运行实际的应用程序,可以参考以下命令

export LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so

如果想通过gdb调试应用程序,则可以参考以下命令

export LD_PRELOAD=
gdb ./helloworld_stack_epoll
(gdb) set exec-wrapper env 'LD_PRELOAD=/data/f-stack/adapter/syscall/libff_syscall.so'

FF_NB_FSTACK_INSTANCE

设置fstack实例应用程序的实例数,用于和用户应用程序的进程/线程等 worker 数量相匹配,默认1。

export FF_NB_FSTACK_INSTANCE=4

建议用户应用程序 worker 数量与fstack实例应用程序尽量 1:1 配置,可以达到更好的性能。

FF_INITIAL_LCORE_ID

配置用户应用程序的 CPU 亲和性绑定的起始 CPU 逻辑 ID,16进制,默认0x4(0b0100),即 CPU 2。

export FF_INITIAL_LCORE_ID=0x4

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。

FF_PROC_ID

配置用户应用程序的进程 ID,可以配合FF_INITIAL_LCORE_ID参数设置 CPU 亲和性的绑定,10进制递增,默认0。

export FF_PROC_ID=1

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。

致谢

特别感谢以下外部贡献者自 2023-05-04 以来通过 pull request 与 commit 对 libff_syscall.so 做出的实质性扩展:

  • liujinhui-job —— 自 2025 年以来贡献最多的外部开发者,主要工作包括:fork 支持(PR #887)、accept4 及 SOCK_CLOEXEC / SOCK_NONBLOCK 支持、__recv_chk / __read_chk / __recvfrom_chk 系列 _FORTIFY_SOURCE hook、epoll polling 模式、ff_hook_recvfrom 中 sh_fromlen 未初始化修复(PR #872),以及围绕 ff_hook_syscall.c、ff_socket_ops.c、ff_socket_ops.h、ff_linux_syscall.c、ff_sysproto.h、ff_declare_syscalls.h 与 Makefile 的一系列细节优化。
  • zhaozihanzzh —— 修复 ff_hook_syscall.c 中的 cplen 计算错误(并将代码风格统一到 ff_hook_accept),以及在 FF_KERNEL_EVENT 模式下 ff_hook_close 内的 kernel epoll fd 泄漏问题。

上述贡献显著提升了 LD_PRELOAD 路径的完整性、正确性以及对 Nginx 的友好程度,欢迎社区继续提交 pull request 与建议。

如果用于应用程序可以配置 CPU 亲和性,则可以忽略该参数,如 Nginx 配置文件中的worker_cpu_affinity参数。

Nginx TCP 多证书透明代理及 Linux/F-Stack(FreeBSD) 路由相关设置

某个 TCP 服务对外有多个域名提供相同的服务,且每个域名都是基于 TLS 的,需要通过 Nginx 对 TLS 进行卸载后转发到实际的上游服务,且上游服务必须使用客户端的源 IP,所以 Nginx 需要使用透明代理。分别需要对Nginx 和系统路由进行配置。

Nginx 配置

需要 Nginx 1.15.9 以上版本,简化配置如下所示,

stream {       
  upstream up_server {
      server 192.168.1.3:8081;
  }
   
  # 通过 map 配置不同域名(SNI)使用不同的证书文件
  # 证书为泛解析证书, 匹配泛解析域名
  # 会降低性能
  map $ssl_server_name $targetCert {
      ~*domain1.com$ /usr/local/cert/domain1.crt;
      ~*domain2.com$ /usr/local/cert/domain2.crt;
      ~*domain2.com$ /usr/local/cert/domain3.crt;
      default /usr/local/cert/domain1.crt;
  }
   
  map $ssl_server_name $targetCertKey {
      ~*domain1.com$ /usr/local/cert/domain1.key;
      ~*domain2.com$ /usr/local/cert/domain2.key;
      ~*domain2.com$ /usr/local/cert/domain3.key;
      default /usr/local/cert/domain1.key;
  }
   
  server {
      listen 8080 ssl reuseport;
   
      ssl_certificate $targetCert;
      ssl_certificate_key $targetCertKey;
      ssl_protocols TLSv1.2 TLSv1.3;
      ssl_session_tickets off;
​
      proxy_pass up_server;
      proxy_bind $remote_addr transparent; # 透明代理
  }
}

Linux 系统路由配置

因为透明代理的源 IP 是实际客户的 IP,在实际服务接受处理完响应包返回时会返回给实际的客户 IP,所以需要配置将回包发到 Nginx 进行处理,这里的上游服务为本机服务,需进行如下配置。如上游在其他服务器上,可以查看参考资料中文章并进行对应配置。

# 新建一个 DIVERT 给包打标签
iptables -t mangle -N DIVERT;
iptables -t mangle -A DIVERT -j MARK --set-mark 1;
iptables -t mangle -A DIVERT -j ACCEPT;
​
# 把本机 TCP 服务的回包给 DIVERT 处理
iptables -t mangle -A OUTPUT -p tcp -m tcp --sport 8081 -j DIVERT
​
# 有标签的包去查名为 100 的路由表
ip rule add fwmark 1 lookup 100
​
# 100的路由表里就一条默认路由,把所有包都扔到lo网卡上去
ip route add local 0.0.0.0/0 dev lo table 100

F-Stack(FreeBSD) 路由配置

F-Stack(FreeBSD) 上游回包路由配置,

# upstream 为本机时
# 假设 f-stack-0 的 IP 为 192.168.1.3,将 upstream 往外发的所有出包都转发到 F-Stack Nginx 监听的 IP 和端口即可
# 因为转发到本机地址时目的端口会被忽略,可不设置端口
ff_ipfw add 100 fwd 192.168.1.3,8080 tcp from 192.168.1.2 8081 to any out
​
# upstream 为其他机器时
# 将 upstream 通过设置网关或者 IP 隧道(需额外进行隧道配置)等方式发过来的所有入包都转发到 F-Stack Nginx 监听的 IP 和端口即可
# 因为转发到本机地址时目的端口会被忽略,可不设置端口
ff_ipfw add 100 fwd 192.168.1.3 tcp from 192.168.1.2 8081 to any in via f-stack-0

参考资料

  1. nginx TLS SNI routing, based on subdomain pattern
  2. 使用nginx的proxy_bind选项配置透明的反向代理
  3. [sslh] Using sslh transparent proxy on FreeBSD?